Вопрос, у которого дважды менялся ответ
Практический вопрос звучит одинаково во всех конфигах: что поставить в Ciphers у sshd, какой шифрсьют оставить в прокси, чем шифровать чанки в своём файловом формате. Формулируется он двумя именами — AES-GCM или ChaCha20-Poly1305, — и за двадцать лет правильный ответ переворачивался дважды. В 2005 году программный AES был дорог и опасен, и любой поточный шифр выигрывал у него в разы. В 2014 году Google выкатил ChaCha20-Poly1305 в Chrome на Android, потому что на тогдашних телефонах AES-GCM был именно таким. Сегодня на процессоре с аппаратным AES выигрывает AES-GCM, и с запасом.
Существенно, что ни один из этих переворотов не связан с криптоанализом. Стандартного статуса за это время не потеряла ни одна из двух схем: AES остаётся в FIPS 197, переизданном в мае 2023 года без технических изменений в алгоритме, и в списке одобренных функций CMVP, ChaCha20-Poly1305 держится на RFC 8439. Состояние криптоанализа ChaCha20 разобрано в статье про саму связку; криптоанализ AES эта статья не разбирает вовсе — для выбора между двумя схемами он ничего не решает. То, что атаки, меняющей выбор, не появилось ни у той, ни у другой схемы, — авторская оценка, а не итог обзора литературы. Менялось железо под алгоритмами, и вместе с ним менялось то, сколько стоит выполнить одну и ту же спецификацию. Это и делает тему полезной: здесь целиком виден цикл «решение → следствие → пересмотр через десять лет», причём пересмотр честный, а не смена моды.
Это третья статья цикла crypto-*. Понятия nonce, AAD, тега и лимитов на объём введены в заметке про AEAD, устройство ChaCha20 и Poly1305 разобрано в следующей за ней, и здесь ни то, ни другое не переопределяется: механика повтора nonce, вывод лимитов из различия перестановки и функции, обрезка ключа Poly1305 — там. Сюда попадают только выводы и их вес при выборе.
Одну вещь надо назвать сразу, потому что её отсутствие бросается в глаза. Свежих публичных данных о том, какая доля трафика идёт каким шифром, найти не удалось: последняя пригодная цифра — публикация Cloudflare 2017 года, и подпирать ею утверждение о сегодняшнем дне нельзя. Поэтому в статье нет ни одного тезиса вида «в мире преобладает то-то»: доли неизвестны, а выбор всё равно делается не по популярности.
Четыре объекта, а не два имени
Сравнение двух имён скрывает, что сравниваются четыре независимых куска, по два на каждую схему, и зависимость от железа у них разная.
AES — блочный шифр подстановочно-перестановочной конструкции: каждый раунд гоняет байты через таблицу подстановки (S-box) и перемешивает их линейным преобразованием, и таких раундов десять для 128-битного ключа и четырнадцать для 256-битного. В AES-GCM он работает в режиме счётчика, то есть как генератор гаммы: сам режим потоковый, блочным остаётся примитив под ним. ChaCha20 — поточный шифр по построению, собранный из сложения, XOR и вращения на константу (ARX), и почему именно так — предмет предыдущей статьи: таблиц в нём нет потому, что таблицы текут по времени.
Вторая половина каждой связки — аутентификатор, и здесь различие зеркально отражает первое уровнем ниже. Оба — полиномиальные MAC: сообщение становится коэффициентами многочлена, который вычисляется в секретной точке. GHASH считает в двоичном поле GF(2¹²⁸), где умножение — это умножение без переносов, для которого в процессоре нужна отдельная команда (PCLMULQDQ у x86, PMULL у ARM). Poly1305 считает по модулю простого 2¹³⁰ − 5 и обходится обычным целочисленным умножителем, который есть везде. Бернштейн выбирал простое поле в 2005 году именно поэтому — команды умножения без переносов тогда не было ни в одном массовом процессоре.
Сложив, получаем главное структурное утверждение статьи: обе половины AES-GCM опираются на специальные команды, обеих половин ChaCha20-Poly1305 это не касается вовсе.
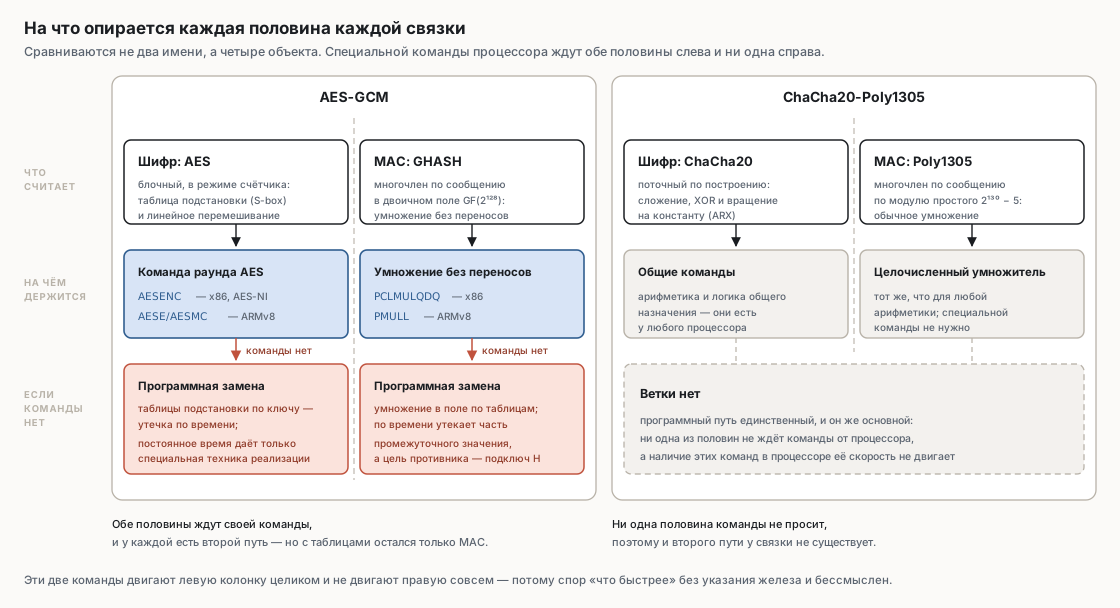
Отсюда и следует всё остальное. Наличие или отсутствие двух команд в процессоре двигает одну связку на порядок и не двигает другую совсем — а значит, вердикт не может быть один на все машины, и спор «что быстрее» без указания железа бессмыслен.
Как менялся вердикт
До 2010: программный AES дорог, и особенно дорого сделать его безопасным
Порядок величин здесь стоит запомнить, потому что именно они породили ChaCha20-Poly1305. Мацуи и Накадзима на CHES 2007 показали первую реализацию AES на Intel Core 2, которая одновременно была постоянной по времени и быстрее всего, что было до неё: 9,2 такта на байт. Оговорка в их результате не менее важна, чем число, и её приводят Кяспер и Швабе в «Faster and Timing-Attack Resistant AES-GCM» (CHES 2009): скорость достигалась только на кусках по 2 КБ, переводимых в специальный битслайс-формат, с учётом конверсии выходило около 10 тактов на байт, а на пакетах в 576 байт авторы ожидали замедления более чем втрое — «making the approach unsuitable for many network applications».
Сами Кяспер и Швабе довели постоянный по времени AES-128 до 7,59 такта на байт на Core 2 Q9550 и 6,92 на Core i7. Но полный AES-GCM у них стоил 10,68 такта на байт — и только потому, что GHASH в этой цифре табличный. Версия без таблиц дала 21,99. Двукратная цена за отказ от таблиц в MAC — это и есть та развилка «быстро и опасно против медленно и безопасно», о которой говорят применительно к AES.
Сравнивать эти числа надо с 3,95 такта на байт у ChaCha20 на Core 2 Duo (таблица 1.3 в записке Бернштейна, цитируется в предыдущей статье) — причём у ChaCha20 нет ни специального формата, ни зависимости от длины сообщения, ни выбора между быстрой и безопасной реализацией. Против постоянной по времени реализации самих Кяспера и Швабе разрыв на шифре почти двукратный, против числа Мацуи с учётом конверсии — примерно в два с половиной раза. Этот разрыв плюс аутентификатор, которому, в отличие от GHASH, специальная команда не нужна вовсе, — вот что видели инженеры Google, когда в 2013–2014 годах собирали связку для Android. Их собственные замеры и мотив разобраны там же, и повторять их здесь незачем; важно, что довод был про железо, и только про железо. Прямого сопоставления двух готовых AEAD на одной машине той эпохи в этом разделе нет намеренно: числа взяты из разных работ, и складывать их в одно отношение нельзя.
После 2010: команда раунда AES и то, как она росла
AES-NI появилась у Intel в микроархитектуре Westmere в 2010 году, в том же поколении, что и PCLMULQDQ, — то есть обе опоры AES-GCM приехали одним комплектом. Команда AESENC выполняет полный раунд AES над 128-битным блоком; девять таких команд и завершающая AESENCLAST дают AES-128. Внутри одного блока они зависимы по данным, зато на независимых блоках конвейеризуются — а режим счётчика как раз и даёт независимые блоки, и это отдельная причина, почему выигрыш от аппаратного AES в AES-GCM больше, чем при шифровании в сцепляющем режиме вроде CBC, где следующий блок нельзя начать до окончания предыдущего.
Дальше выигрыш рос без участия криптографии. Расширение VAES применяет тот же раунд сразу к вектору из двух или четырёх блоков, а VPCLMULQDQ делает то же с умножением без переносов. Насколько это двигает готовый код, видно по двум коммитам Эрика Биггерса, которыми VAES-реализации AES-GCM приехали в ядро Linux. Вариант на AVX-512 (b06affb1cb58, июнь 2024) дал против прежнего кода на AES-NI и AVX2 от 42 до 71% на Ice Lake и от 38 до 162% на Sapphire Rapids. Разброс внутри строки — это и есть зависимость от длины сообщения, и устроена она на двух микроархитектурах по-разному: у Sapphire Rapids верх диапазона держится на сообщениях от 4 до 16 КиБ, а на шестнадцати байтах остаётся 38%, тогда как у Ice Lake минимум приходится, наоборот, на 16 КиБ. Вариант на AVX2 (fae3b96ba601, октябрь 2025) добавил на AMD Milan (Zen 3) до 74% (расшифровка 16 КиБ; на шифровании тех же 16 КиБ — 67%) и заодно перечисляет, у кого VAES вообще есть без AVX-512: AMD Zen 3, клиентские Intel от Alder Lake до Lunar Lake, серверный Sierra Forest; у Ice Lake и Tiger Lake VAES есть вместе с AVX-512.
У ARM тот же комплект называется криптографическими расширениями ARMv8: команды AESE/AESMC для раунда и PMULL для умножения без переносов. Ключевое отличие от x86 — они не обязательны, и об этом отдельный раздел ниже.
ChaCha20 за это время тоже ускорилась, и об этом обычно забывают: её реализации векторизуются на SSSE3, AVX2 и AVX-512, потому что четыре четверть-раунда независимы. Но векторизация — это умножение пропускной способности общих исполнительных устройств, тогда как AES получил специализированную команду, а потом ещё и её векторную версию. Разрыв в пользу AES-GCM на машинах с обеими командами — это не «AES догнал», а «AES получил то, чего у ARX-шифра по построению быть не может».
Измерение: одна машина, два режима диспетчеризации
Числа из чужих блогов в этом вопросе бесполезны: они меряют неизвестное железо неизвестной библиотекой. Полезно другое — измерение, где меняется ровно одна переменная. OpenSSL выбирает реализацию по флагам процессора в рантайме, и эти флаги можно замаскировать переменной окружения OPENSSL_ia32cap, не трогая ни код, ни машину:
# 16 КиБ на вызов, обычный путь
openssl speed -elapsed -evp aes-128-gcm

# то же, но AES-NI (бит 57) и PCLMULQDQ (бит 33) объявлены отсутствующими;
# вторым словом маски сохраняем AVX2 и AVX-512, иначе заодно отключится
# векторный ChaCha20 и сравнение перестанет быть честным
OPENSSL_ia32cap="~0x200000200000000:~0x0" openssl speed -elapsed -evp aes-128-gcm
Результаты ниже получены на виртуальной машине с Intel Xeon поколения Cascade Lake (4 vCPU, 2,8 ГГц номинально), OpenSSL 3.0.13, 13 сентября 2026 года. Это замер одной конкретной машины, а не характеристика алгоритмов; воспроизводить его надо на своём железе, ради чего команды и приведены. Цифры — мегабайты в секунду, по колонкам 1 КиБ и 16 КиБ на вызов.
| Схема | 1 КиБ, есть AES-NI | 16 КиБ, есть AES-NI | 1 КиБ, команды замаскированы | 16 КиБ, команды замаскированы |
|---|---|---|---|---|
| AES-128-GCM | 3754 | 4969 | 249 | 254 |
| AES-256-GCM | 2980 | 3605 | 210 | 215 |
| ChaCha20-Poly1305 | 1891 | 2087 | 1859 | 2056 |
Читать таблицу нужно по строкам, а не по столбцам. Строка ChaCha20-Poly1305 практически не меняется — разница в пределах шума измерения, и это ожидаемо: связка не использует ни одну из замаскированных команд. Строки AES-GCM проваливаются в пятнадцать-двадцать раз, в зависимости от размера блока. Соотношение при этом переворачивается: с аппаратной поддержкой AES-128-GCM быстрее ChaCha20-Poly1305 в 2,4 раза на больших блоках и вдвое на килобайтных, без неё ChaCha20-Poly1305 быстрее в восемь раз.
Две поправки, и обе делают картину мягче, чем она есть. У этого процессора нет VAES, так что на машине поновее преимущество AES-GCM будет больше измеренного. И маскировка убирает только AES-NI с PCLMULQDQ, оставляя весь прочий SIMD: OpenSSL продолжает видеть SSSE3 и уходит на векторную перестановочную реализацию AES, а не на самую медленную — что это именно она, видно из следующего раздела, где дополнительная маскировка SSSE3 роняет скорость ещё вчетверо. Иными словами, 254 МБ/с — это x86 без аппаратного AES, но не худший из возможных программных путей.
Отдельная строка про AES-256: четыре лишних раунда стоят около четверти пропускной способности. В TLS это чистая потеря — комментарий в исходниках crypto/tls языка Go формулирует резко и по делу: единственные возможные преимущества AES-256 (запас в многоключевой постановке и гипотетические постквантовые свойства) к TLS не относятся. Брать AES-256 стоит там, где этого требует внешний контур, а не «на всякий случай».
Где аппаратного AES нет
«На ARM AES медленный» и «на ARM AES быстрый» одинаково неверны, и причина не в маркетинге, а в том, как Arm лицензирует ядра. Криптографические расширения ARMv8 — опциональный блок: в техническом руководстве по криптодвижку Cortex-A72 прямо сказано, что этот движок не входит в базовый продукт и требует отдельных контрактных прав. Производитель SoC решает сам, и решает по-разному.
Показательная пара — два поколения одной и той же платы. Broadcom BCM2711 в Raspberry Pi 4 построен на Cortex-A72 без криптоблока, BCM2712 в Raspberry Pi 5 — на Cortex-A76 с ним; по сводке замеров проекта sbc-bench все 64-битные Raspberry Pi, кроме пятой, аппаратного AES не имеют. То есть один и тот же одноплатник на расстоянии одного поколения даёт противоположный ответ на вопрос этой статьи.
Это, однако, про SBC, а связку внедряли ради телефонов, и тут надо сказать прямо: свежих данных о том, какая доля массовых мобильных SoC идёт сегодня без криптоблока, найти не удалось, поэтому числа в статье нет. Известно только то, что проверяется: опциональным блок остаётся по-прежнему, а класс устройств без него живёт и признан производителем платформы — документация AOSP предлагает шифровать хранилище ARX-схемой Adiantum «for devices running Android 9 and higher whose CPUs lack AES instructions» и прямо велит не брать её там, где есть криптографические расширения ARMv8 или AES-NI. Насколько этот класс сегодня велик и остался ли он только внизу рынка — вопрос открытый, и довод 2014 года про телефоны стоит читать как исторический, а не как описание сегодняшнего дня.
Проверяется это за секунду и не требует бенчмарка: у ядра Linux на ARM64 признаки печатаются в /proc/cpuinfo. У FreeBSD /proc/cpuinfo нет, и те же признаки печатает ядро при старте: на arm64 строкой Instruction Set Attributes 0 со значением AES+PMULL, на amd64 — в Features2 флагами AESNI и PCLMULQDQ. На macOS с Apple Silicon наличие блока отдаёт отдельный sysctl.
grep -m1 Features /proc/cpuinfo              # Linux: нужны aes и pmull, sha1/sha2 приезжают тем же блоком
dmesg | grep 'Instruction Set Attributes 0'  # FreeBSD на arm64: ищем AES+PMULL
sysctl hw.optional.arm.FEAT_AES              # macOS на Apple Silicon: 1
openssl speed -elapsed -evp aes-128-gcm      # проверка того же на результате, а не на флаге
Второй класс машин без аппаратного AES — всё, что исполняется не процессором напрямую: WebAssembly и JavaScript. Здесь позиция libsodium содержательнее любого замера: библиотека вообще не поставляет программной реализации AES-GCM — «There are no plans to support non hardware-accelerated implementations of AES-GCM. This includes JavaScript and WebAssembly, where it can't be implemented efficiently and securely. If portability is a concern, use ChaCha20-Poly1305 instead». Функция crypto_aead_aes256gcm_is_available() существует именно поэтому: приложение обязано спросить у железа разрешения, прежде чем выбрать AES.
Третий класс — встраиваемые системы и микроконтроллеры, но там вопрос обычно стоит иначе: не «что быстрее», а «что влезает», и ответ уводит к отдельному семейству алгоритмов (см. раздел про соседей).
Постоянное время: структура против дисциплины
Скорость — не единственное следствие отсутствия аппаратной поддержки, и не самое неприятное. Второе следствие — утечка по времени, и здесь различие между двумя схемами не количественное, а по природе гарантии.
У ChaCha20 постоянство времени следует из набора операций: сложение, XOR и вращение на константу выполняются за фиксированное время на любом процессоре, который их умеет, и чтобы получить утечку, надо постараться. У AES программная реализация индексирует таблицы подстановки байтами, зависящими от ключа, — это та самая кэш-тайминговая атака Бернштейна 2005 года, из-за которой ARX-шифры и появились; подробный разбор — в статье про ChaCha20. Постоянное время у AES обеспечивает либо аппаратная команда, либо специальная техника реализации, и ни то, ни другое не следует из спецификации шифра.
Насколько это не теория, видно по документации. Пакет crypto/aes языка Go начинается с предупреждения: «The AES operations in this package are not implemented using constant-time algorithms. An exception is when running on systems with enabled hardware support for AES that makes these operations constant-time» — дальше перечислены amd64 с AES-NI и s390x, и добавлено, что на таких системах постоянным по времени становится и GHASH внутри GCM. Аналогичного предупреждения у golang.org/x/crypto/chacha20poly1305 нет, и это отсутствие содержательно: предупреждать не о чем. Соблазнительно сказать «ChaCha20-Poly1305 постоянна по времени везде», но точная формулировка другая и она в статье про устройство связки: у шифра постоянство времени структурное, у Poly1305 его обеспечивает реализатор — финальная редукция требует сознательной аккуратности. Разница в объёме: у Poly1305 это несколько ветвлений в конце, у AES — весь тракт данных.
Интереснее всего то, что на x86 развилка «быстро и опасно против медленно и безопасно» за двадцать лет переехала из шифра в MAC. На той же машине, что и выше, AES-128-CTR без AES-NI даёт 531 МБ/с, а если замаскировать вдобавок SSSE3 и тем самым увести OpenSSL с векторной перестановочной реализации на табличную — 126 МБ/с. То есть реализация, безопасная по построению, вчетверо быстрее той, что течёт по времени, и выбирать между скоростью и утечкой в самом шифре больше не приходится. (Это измерение того, что выбирает диспетчер OpenSSL на этом процессоре, а не утверждение о лучшей достижимой табличной реализации AES вообще.)
А вот в GHASH развилка осталась. Без PCLMULQDQ OpenSSL считает умножение в поле по 4-битным таблицам, и комментарий в crypto/modes/gcm128.c описывает цену выбора без прикрас: при более простой раскладке таблиц «it's trivial to see that cache timing information can reveal fair portion of intermediate hash value», а зная шифртекст, противник может попытаться вывести секретный параметр H и, если получится, подделывать сообщения — «which is nothing but trivial in CTR mode». Про выбранный вариант Шоупа сказано, что там это не так тривиально, «but there is no reason to believe that it's resistant to cache-timing attack». Восьмибитные таблицы отвергнуты сознательно, ради «better security-performance balance», и осторожность формулировки в том же комментарии стоит сохранить: по расчёту они «should be twice as fast», а наблюдалось «~75% faster, closer to 100% for commercial compilers». Чем оборачивается восстановление H, разобрано в статье про AEAD — тем же, чем повтор nonce: подделкой любых сообщений в соединении.
Вывод для выбора: на машине без PCLMULQDQ AES-GCM — это не просто «медленно», это ещё и аутентификатор с табличным умножением по секретному значению.
Nonce и лимиты: ось, где вердикт не менялся
Две оси сравнения не зависят от железа вовсе, и потому их вердикт за двадцать лет не двигался ни разу.
Первая — цена ошибки в nonce. Повтор nonce ломает любой AEAD, но в AES-GCM он отдаёт противнику подключ аутентификации H, общий на весь ключ, и вместе с ним подлинность всего соединения, а в ChaCha20-Poly1305 одноразовая пара Poly1305 выводится заново для каждого nonce, поэтому ущерб ограничен этим одним nonce. Механика обеих атак — в статье про AEAD. При выборе это весит ровно столько, сколько весит ваша уверенность в дисциплине nonce: если в системе есть параллельные писатели под одним ключом, снепшоты виртуальных машин или случайные 96-битные nonce без учёта количества, AES-GCM стоит дороже при равных прочих.
Вторая — лимиты на объём под одним ключом. Различие структурное: AES — псевдослучайная перестановка, и лимит берётся из того, что перестановка не повторяет выходы, а ChaCha20 — псевдослучайная функция, где различать нечего. В TLS 1.3 это выражено одной фразой (RFC 9846, §5.5): для AES-GCM это 2²⁴·⁵ полноразмерных записей на набор ключей, а для ChaCha20-Poly1305 «the record sequence number would wrap before the safety limit is reached». Вывод и арифметика — в статье про AEAD.
Практическое следствие стоит назвать явно, потому что оно не про TLS. В протоколе с рукопожатием разница почти незаметна: перевыработку ключей делает сам протокол, и от выбора шифра меняется только частота KeyUpdate. А вот в долгоживущем соединении без перевыработки или в файловом формате, где под одним ключом лежит терабайт, лимит AES-GCM становится реальным ограничением, которое приходится обслуживать руками — сменой ключа по счётчику записей. С ChaCha20-Poly1305 обслуживать нечего. Если вы проектируете формат, а не настраиваете сервер, это соображение весит больше, чем разница в пропускной способности.
Как выбор устроен в живых реализациях
Практическая трудность в том, что шифр согласуют две стороны, а аппаратная поддержка есть у каждой своя. Сервер с AES-NI и клиент без криптоблока хотят разного, и сервер не может опросить клиента о его процессоре. Решение, к которому независимо пришли три реализации, одно и то же: клиент выражает своё железо порядком в списке, а сервер этому порядку уступает.
BoringSSL строит список шифров прямо по результату EVP_has_aes_hardware(), и комментарий в ssl/ssl_cipher.cc описывает обе роли: при наличии аппаратного AES клиент предпочитает AES-128 → AES-256 → ChaCha20, а сервер объявляет все три равнопредпочтительными и отдаёт решение клиенту; при отсутствии — ChaCha20 идёт первым у обоих. OpenSSL даёт тот же эффект отдельной опцией: SSL_OP_PRIORITIZE_CHACHA временно поднимает ChaCha20-Poly1305 в начало серверного списка, «if a ChaCha20-Poly1305 cipher is at the top of the client cipher list», и работает только вместе с SSL_OP_CIPHER_SERVER_PREFERENCE. В nginx это включается одной строкой, и ровно она стоит примером в документации директивы (доступна с версии 1.19.4):
ssl_prefer_server_ciphers on;
ssl_conf_command Options PrioritizeChaCha;
Go делает то же в библиотеке, без настроек: функция isAESGCMPreferred в crypto/tls требует совпадения двух условий — у нас есть аппаратная поддержка AES-GCM и первый знакомый шифр в списке собеседника тоже AES-GCM, «implying the peer also has hardware support for it». Комментарий рядом объясняет, почему порядок вообще зависит от железа, и стоит того, чтобы привести его целиком: при наличии аппаратного AES обе версии AES-GCM быстрее ChaCha20-Poly1305, а при отсутствии AES-128-GCM «is one or more of: much slower, way more complex, and less safe (because not constant time)».
Вердикт для сервера отсюда прямой: не навязывать AES-GCM серверным приоритетом. Либо оставить порядок клиенту, либо включить приоритизацию ChaCha20. Собственный процессор сервера в этом решении не участвует вовсе — он шифрует и то, и другое приемлемо, а вот клиентский может не уметь ни того, ни другого хорошо.
SSH устроен иначе, и это стоит знать. Умолчание OpenSSH фиксировано и никак не зависит от железа: chacha20-poly1305@openssh.com, затем aes128-gcm@openssh.com и aes256-gcm@openssh.com, затем варианты CTR (sshd_config(5)). Выбор делает клиент: по RFC 4253, §7.1, берётся первый алгоритм из списка клиента, который есть и у сервера. Значит, на паре машин с аппаратным AES, между которыми гоняют большие объёмы по scp, rsync -e ssh или sftp, имеет смысл поднять AES-GCM явно — и делать это надо на стороне клиента:
ssh -c aes128-gcm@openssh.com user@example.com
По измерениям выше это разница примерно вдвое на канале, где упор в процессор, а не в сеть. Множитель здесь только ориентир: openssl speed меряет обе схемы реализациями OpenSSL, а OpenSSH так берёт лишь AES-GCM — ChaCha20-Poly1305 у него свой (Poly1305 всегда собственный, ChaCha20 уходит в EVP_chacha20 только при сборке с подходящим OpenSSL), и поверх этого он шифрует длину пакета отдельным ключом. На ноутбуке без AES-NI или на SBC ровно то же изменение сделает хуже, поэтому строка Ciphers в ~/.ssh/config — это утверждение о железе клиента, а не универсальная настройка.
Соседи по столу
Выбор не сводится к двум именам: рядом стоят ещё три схемы, и их стоит держать в поле зрения — хотя бы чтобы понимать, почему они пока не ответ. В таблице они идут вместе с двумя основными, потому что сравнивать имеет смысл по одним и тем же осям.
| Схема | С аппаратным AES | Без него | При повторе nonce | Статус на 13 сентября 2026 |
|---|---|---|---|---|
| AES-GCM | самый быстрый из массовых | медленно, и GHASH считается по таблицам | теряется подлинность всего соединения | SP 800-38D, в списке одобренных CMVP |
| ChaCha20-Poly1305 | медленнее вдвое на килобайтных блоках и в 2,4 раза на 16 КиБ (замер выше) | быстрее в разы, постоянное время из конструкции | ущерб в пределах одного nonce | RFC 8439; в списке CMVP нет |
| AEGIS-128L | быстрее AES-GCM | наследует все проблемы AES | случайный nonce безопаснее, чем в AES-GCM; без практического предела — только у AEGIS-256 | draft-irtf-cfrg-aegis-aead-18, в очереди RFC-редактора с марта 2026 |
| Ascon-AEAD128 | не про скорость на больших процессорах | приемлемо; ниша — размер схемы | заявлена частичная устойчивость: гарантии держатся, пока пара (nonce, AAD) уникальна, а сам nonce повторён не более 2⁸ раз | SP 800-232 (13 августа 2025), в списке CMVP со 2 сентября 2025 |
| AES-GCM-SIV | медленнее AES-GCM: два прохода | наследует все проблемы AES | раскрывает только факт равенства открытых текстов | RFC 8452 |
AEGIS — семейство из финалистов конкурса CAESAR, построенное из раунда AES: черновик обещает производительность, «significantly exceeds AES-GCM on CPUs with AES instructions», а для процессоров с векторными AES-командами определяет отдельные параллельные режимы AEGIS-128X и AEGIS-256X. Отсюда же его граница: это ускорение поверх аппаратного AES, а не замена ему. На машине без криптоблока AEGIS упирается в то же самое, во что упирается AES-GCM, — сам черновик обещает там лишь преимущество «to a lesser extent». Реализация есть в libsodium с 1.0.19. Статус — informational-черновик IRTF: опрос IRSG начался в октябре 2025, к RFC-редактору документ ушёл 2 марта 2026 года и на дату сверки всё ещё не опубликован — с 9 сентября 2026 года его состояние у редактора значится как ожидание ответственного. Ревизия 18 от 5 октября 2025 года с тех пор не менялась. Вердикт: смотреть, не ставить в протокол, от которого нельзя отказаться.
Ascon — победитель конкурса лёгкой криптографии NIST, стандартизован в SP 800-232 13 августа 2025 года. Ниша названа в заголовке стандарта — constrained devices: перестановочная конструкция с маленьким состоянием, дешёвая по площади и по коду. На сервере он не конкурент ни одному из первых двух, и мерить его там незачем. Важное следствие для регуляторики — ниже.
AES-GCM-SIV — ответ именно на повтор nonce ценой двух проходов и потери потоковости; разобран в статье про AEAD, и место его там же, где сказано: записи и конверты, целиком помещающиеся в память, а не сетевой поток.
Регуляторный контур
Единственная ось, по которой у AES-GCM безусловное преимущество и которая может перевесить всю технику разом. ChaCha20-Poly1305 не входит в список одобренных функций FIPS 140-3, и механизм этого «не входит» стоит понимать точно, потому что он объясняет, почему ситуация не изменится сама.
Список одобренных функций задаёт SP 800-140C. В редакции Rev. 2 (июль 2023) сам документ похудел до трёх страниц: все разделы с перечнями из него убраны, а вместо них стоит ссылка на веб-страницу CMVP, причём мотив изменения записан в журнале правок — будущие изменения списка делаются на сайте, чтобы не переиздавать публикацию. Формулировка требования при этом осталась максимально жёсткой: документ «identifies CMVP-approved security functions. It precludes the use of all other security functions». Список закрытый, и попасть в него можно только одним способом — через стандарт NIST.
Ни ChaCha20, ни Poly1305 на этой странице нет: в разделе про аутентифицированное шифрование лежат режимы AES из SP 800-38C и SP 800-38D. Существенно, что дело не в подозрениях к алгоритму: механизм чисто процедурный, и лучшее тому доказательство — Ascon. Он тоже не AES и тоже пришёл со стороны, но у него есть стандарт NIST, и 2 сентября 2025 года Ascon-AEAD128 был добавлен в тот же список отдельным пунктом. То есть «одобренный AEAD» перестал быть синонимом «режим AES» — но ChaCha20-Poly1305 это не касается, потому что стандарта NIST у неё нет и работ над ним не объявлено.
Вердикт: если контур требует FIPS-валидированного модуля, выбора нет — AES-GCM, и обсуждать тут нечего. Во всех остальных случаях список CMVP аргументом не является.
Вердикт по классам
Одного ответа нет, но и «зависит от задачи» — не ответ. Классов четыре, и они различаются не задачей, а тем, что известно про железо.
Сервер или десктоп с аппаратным AES (практически любой x86 после 2010 года — с поправкой на бюджетные SKU, где AES-NI отключали, — и большинство ARM64-серверов) — AES-128-GCM. На машине из раздела с измерением он быстрее ChaCha20-Poly1305 вдвое на килобайтных блоках и в 2,4 раза на больших, а на процессоре с VAES запас будет ещё шире. AES-256 — только под внешнее требование. Для TLS на сервере — оставить клиенту право выбрать ChaCha20 (приоритизация или отказ от серверного порядка): клиент знает про своё железо то, чего не знаете вы.
SBC, встраиваемое, старое и всё, где аппаратного AES нет — ChaCha20-Poly1305, и вопрос даже не в разнице пропускной способности (восьмикратной на x86 с замаскированными командами; на конкретном SBC число будет своим), а в том, что альтернатива тянет за собой табличный GHASH. Проверять надо не по названию архитектуры, а по флагам процессора: у ARM криптоблок опционален, и две соседние ревизии одной платы дают разный ответ. Телефон сюда по-прежнему может попадать, но именно «может»: насколько велик сегодня парк мобильных SoC без криптоблока, публичных данных найти не удалось, и решает тут та же проверка флагов, а не довод 2014 года.
Свой файловый формат или протокол, который поедет на неизвестное железо — ChaCha20-Poly1305. Здесь складываются три довода, и ни один не про скорость: гарантия постоянного времени не зависит от платформы, лимит на объём под ключом недостижим и его не надо обслуживать, а цена случайного повтора nonce ограничена одним nonce. Если nonce придётся выбирать случайно — XChaCha20-Poly1305 с его 192-битным nonce, с оговоркой про статус черновика из статьи про AEAD.
Контур с FIPS-валидацией — AES-GCM, без вариантов, и это решение принимается до всех технических соображений.
Что здесь устареет первым
Статья держится на фактах с очень разным сроком годности, и полезно знать, какие из них посыплются раньше.
Соотношение производительности — самое недолговечное. Измерения выше сделаны 13 сентября 2026 года на Cascade Lake без VAES; каждое поколение векторных расширений двигает их в пользу AES-GCM, и цифры надо перемерять на своей машине, а не переносить.
Статусы черновиков. AEGIS ушёл к RFC-редактору в марте 2026 и на дату сверки всё ещё не RFC — когда номер появится, соответствующая строка таблицы устареет целиком. XChaCha20 остаётся истёкшим черновиком, и это положение держится с 2020 года.
Положение ChaCha20 в FIPS. На дату сверки в списке CMVP её нет и объявленных планов нет; прецедент Ascon показывает, что список пополняется, так что это стоит перепроверять, а не считать вечным.
Умолчания реализаций. Порядок шифров в OpenSSH и логика выбора в BoringSSL, OpenSSL и Go сверены на дату в шапке; они меняются вместе с версиями и проверяются в исходниках и man-страницах за минуту.
И то, чего в статье нет: доли шифров в реальном трафике. Актуальных публичных измерений найти не удалось, и если они появятся, это будет заметное добавление — но на вердикты выше они влиять не должны.
Источники
- RFC 8439 — ChaCha20-Poly1305 для протоколов IETF
- FIPS 197 — AES: действующий стандарт, редакция от 9 мая 2023 года без технических изменений в алгоритме
- NIST SP 800-38D — GCM и GHASH: определение умножения в GF(2¹²⁸), требования к IV
- RFC 9846 — TLS 1.3 (июль 2026): лимиты на использование ключа (§5.5), обязательные и рекомендованные шифрсьюты (§9.1)
- RFC 4253 — транспортный уровень SSH: правило выбора шифра по списку клиента (§7.1)
- RFC 8452 — AES-GCM-SIV
- NIST SP 800-232 — Ascon-AEAD128, Ascon-Hash256 и XOF (финальная редакция, 13 августа 2025): ниша constrained devices, поведение при повторе nonce (§4.4.3)
- NIST SP 800-140Cr2 — «It precludes the use of all other security functions» и перенос самого списка на веб-страницу (журнал правок, редакция 2, июль 2023)
- CMVP-approved security functions — действующий список: разделы 6.2.2 и 6.2.6, добавление Ascon 2 сентября 2025, отсутствие ChaCha20 и Poly1305
- draft-irtf-cfrg-aegis-aead — AEGIS: построение из раунда AES, параллельные режимы для векторных AES-команд (§5), сравнение с AES-GCM (§1); ревизия 18 (5 октября 2025), у RFC-редактора со 2 марта 2026, состояние на 9 сентября 2026 — ожидание ответственного
- E. Käsper, P. Schwabe, Faster and Timing-Attack Resistant AES-GCM (CHES 2009) — 9,2 такта на байт у Мацуи и Накадзимы и оговорки к этому числу, 7,59 и 6,92 такта на байт у постоянной по времени AES-128, 10,68 против 21,99 для AES-GCM с табличным и бестабличным GHASH
- D. J. Bernstein, ChaCha, a variant of Salsa20 — таблица 1.3 со скоростями ChaCha20 на процессорах до AES-NI
- eBACS: ECRYPT Benchmarking of Cryptographic Systems — открытый набор замеров примитивов на разнородном железе; первоисточник для сравнений производительности вместо чужих блогов
- Intel: Carry-Less Multiplication and its Usage for Computing the GCM Mode —
PCLMULQDQв микроархитектуре Westmere, одно поколение с AES-NI - Linux, коммит
b06affb1cb58— VAES-реализация AES-GCM на AVX-512 в ядре (июнь 2024): таблицы 1 и 2: прирост 42–71% на Ice Lake и 38–162% на Sapphire Rapids против кода на AES-NI и AVX2 - Linux, коммит
fae3b96ba601— то же на AVX2 (октябрь 2025): перечень процессоров с VAES без AVX-512 и прирост до 74% на AMD Milan (Zen 3) - Arm: Cortex-A72 Cryptography Extension TRM — криптодвижок не входит в базовый продукт и лицензируется отдельно
- sbc-bench: ARM's Crypto Extensions — сводка замеров по SoC: все 64-битные Raspberry Pi, кроме BCM2712, без аппаратного AES; проверка по
Featuresв/proc/cpuinfo - OpenSSL,
crypto/modes/gcm128.c— комментарий о том, что табличный GHASH раскрывает часть промежуточного значения по времени и позволяет пытаться вывестиH - OpenSSL,
SSL_CTX_set_options(3)—SSL_OP_PRIORITIZE_CHACHAи его связь сSSL_OP_CIPHER_SERVER_PREFERENCE - BoringSSL,
ssl/ssl_cipher.cc— порядок шифров поEVP_has_aes_hardware()и равнопредпочтительная группа на сервере - Go,
crypto/aes— предупреждение о непостоянном времени вне систем с аппаратной поддержкой - Go,
crypto/tls/cipher_suites.go—hasAESGCMHardwareSupport,isAESGCMPreferredи обоснование порядка «AES перед ChaCha20» - sshd_config(5) — умолчание
Ciphersв OpenSSH - nginx,
ssl_conf_command— проброс опций OpenSSL из конфига, сPrioritizeChaChaв качестве примера - AOSP: Enable Adiantum — ARX-схема для устройств с Android 9 и новее, чьи процессоры не имеют команд AES, и указание не применять её при наличии криптографических расширений ARMv8 или AES-NI
- libsodium: AES-256-GCM — отказ поставлять программную реализацию AES-GCM, требование
crypto_aead_aes256gcm_is_available(), рекомендация ChaCha20-Poly1305 для переносимости
Связанные заметки
- AEAD: аутентифицированное шифрование, nonce и лимиты — цена повтора nonce, вывод лимитов на объём и misuse-resistant режимы: выводы, которые здесь взвешиваются при выборе
- ChaCha20 и Poly1305: устройство связки и почему она такая — устройство обеих половин одной из сравниваемых схем: ARX как ответ на кэш-тайминг, простое поле в Poly1305, состояние криптоанализа
- Обмен ключами: X25519, KEM, вывод ключей и привязка к транскрипту — та же развилка «свой выбор против сертификации» в асимметричной части рукопожатия
- SSH углублённо — где в конфиге живёт
Ciphersи почему выбор делает клиент - Обратный прокси и TLS: nginx vs Caddy — куда ставить
ssl_conf_commandи кто терминирует TLS - OpenVPN против WireGuard — тот же выбор на уровне туннеля: AES-NI на шлюзе против единственного шифра WireGuard
- SATA, SAS и NVMe — вторая половина вопроса «во что упирается», когда шифрование перестаёт быть узким местом
- Криптографические примитивы — план цикла статей — состав цикла, порядок статей и сквозные решения
Из библиотеки института уносят только знания. Читателей здесь не считают: посещение не регистрируется, отметок в издании не остаётся, счётчиков нет ни у одного издания фонда.
Издание пополняется и пересверяется. Текст доступен на условиях CC BY-SA 4.0 — унесённое можно передавать дальше на тех же условиях.