Обзор
Разница между «запустил и попробовал» и «работает третий месяц» у сервиса инференса больше, чем у обычного демона, и причина в профиле потребления. Веса занимают десятки, а коллекция — сотни гигабайт диска постоянно. Видеопамять занимается целиком и по принципу «всё или ничего»: пока модель загружена, соседний процесс её не получит, сколько бы её ни оставалось свободной по цифрам. Вычисления идут секундами и вспышками, а между вспышками карта простаивает часами, продолжая потреблять электричество. Ни один из этих трёх ресурсов не управляется теми же средствами, что остальные, и ни один не отдаётся операционной системе на откуп так, как отдаётся обычная память процесса.
Отсюда состав статьи. Как модель считает и почему занимает столько памяти, сколько занимает, разобрано в локальном инференсе LLM; здесь этот разбор считается известным, а речь идёт о том, как всё это живёт на машине неделями без внимания: чем управляется резидентность модели, где лежат веса и что из этого попадает в бэкап, как сервис публикуется и почему аутентификация оказывается работой прокси, что мерить и на что заводить алерт, и что именно ломается, когда обновляется драйвер.
Всё, что зависит от дистрибутива, здесь сведено к минимуму намеренно: механизмы — systemd, cgroup v2, page cache, HTTP-прокси — общие, а различаются имена пакетов. Данные приведены по состоянию на 6 сентября 2026 года; версии, на которых выверялись конкретные утверждения, названы в тексте, непроверенное помечено словами.
Три ресурса и три масштаба времени
Полезно с самого начала развести три вещи, которые в обсуждениях слипаются в «ресурсы GPU-сервера».
Диск держит веса постоянно, и его потребление растёт не от числа моделей, а от числа квантов и ревизий: одна и та же модель в трёх квантах — это три полных копии. Управляется это удалением, а не сжатием и не дедупликацией; почему — ниже.
Видеопамять занимается на время жизни процесса и освобождается только вместе с ним или явной командой движку. Ядро здесь почти не участник: страничного вытеснения для VRAM нет, OOM-killer до неё не дотягивается, а контроллер memory в cgroup её не видит вовсе. Единственный настоящий регулятор — параметры самого движка, и это единственный ресурс, для которого «ограничить снаружи» в общем случае не работает. Оговорка к рамке: всё это описывает дискретный ускоритель с собственным пулом VRAM. На единой памяти — Apple silicon, APU — видеопамять и оперативная память суть один пул, отдельного ресурса «видеопамять» не существует, и веса конкурируют за память со всем остальным на машине напрямую. Как считается бюджет на таком железе, разобрано в локальном инференсе.
Электричество и тепло — непрерывная величина, которая живёт по своим правилам: пиковая мощность определяется префиллом, а средняя — тем, сколько часов в сутки машина вообще включена. Ограничивать здесь имеет смысл не то, что подсказывает интуиция, и об этом отдельный раздел.
Практический вопрос, из которого растёт вся эксплуатация, ровно один: занимать ли карту, когда никто ничего не спрашивает. Ответ на него определяет и устройство юнита, и требования к диску, и вид алертов.
Жизненный цикл сервиса
Из чего складывается холодный старт
Время от systemctl start до первого токена — это сумма четырёх слагаемых, и лечатся они по-разному.
Первое — чтение весов с диска. Величина считается делением: 20 ГиБ весов на накопителе, дающем 2 ГБ/с последовательного чтения, — это порядка десяти секунд, и никакие настройки движка этого не отменят. Второе — инициализация драйвера и создание контекста CUDA. Документация NVIDIA про persistence описывает это прямо: драйвер исторически инициализирует состояние только когда появляется клиент, и в вычислительном окружении без X-сервера карта инициализируется и деинициализируется на каждой задаче, что даёт «long load times for each CUDA job, on the order of seconds». Третье — прогрев движка: пробный прогон, построение графов вычислений, аллокация пула KV-кэша. Четвёртое — префилл системного промпта, если он длинный.
Нулевое слагаемое — скачивание весов — в эту сумму не входит, потому что случается один раз, но по величине обычно больше всех четырёх вместе взятых, и считается тем же делением: 20 ГиБ по каналу в 100 Мбит/с — это около получаса, коллекция в терабайт — почти сутки. Величина понадобится дальше, в разделе про то, что не бэкапить.
Первое слагаемое исчезает при повторном запуске, и не благодаря движку, а благодаря page cache: llama.cpp по умолчанию отображает файл модели в память (--load-mode auto — «mmap, unless a device does not support it»), и если оперативной памяти хватает, страницы весов остаются в кеше между запусками процесса. Отсюда неочевидное следствие, к которому мы вернёмся: оперативная память имеет значение даже при инференсе целиком на карте, и любое ограничение, выселяющее page cache, превращает тёплый старт обратно в холодный. Тёплый старт стоит поэтому только трёх оставшихся слагаемых — секунды против десятков секунд у холодного.
Второе слагаемое снимается демоном постоянства (nvidia-persistenced), который держит состояние драйвера инициализированным между задачами. Старый способ — nvidia-smi -pm 1 — в документации NVIDIA помечен как legacy: демон создавался, чтобы «replace this kernel-level solution with a more robust user-space solution». Ни то, ни другое не переживает перезагрузку само по себе, поэтому включается юнитом.
Резидентность модели
Модель проходит через несколько состояний, и различать их нужно потому, что «выгружена» в разных движках означает разное, а «не занимает карту» — почти никогда.
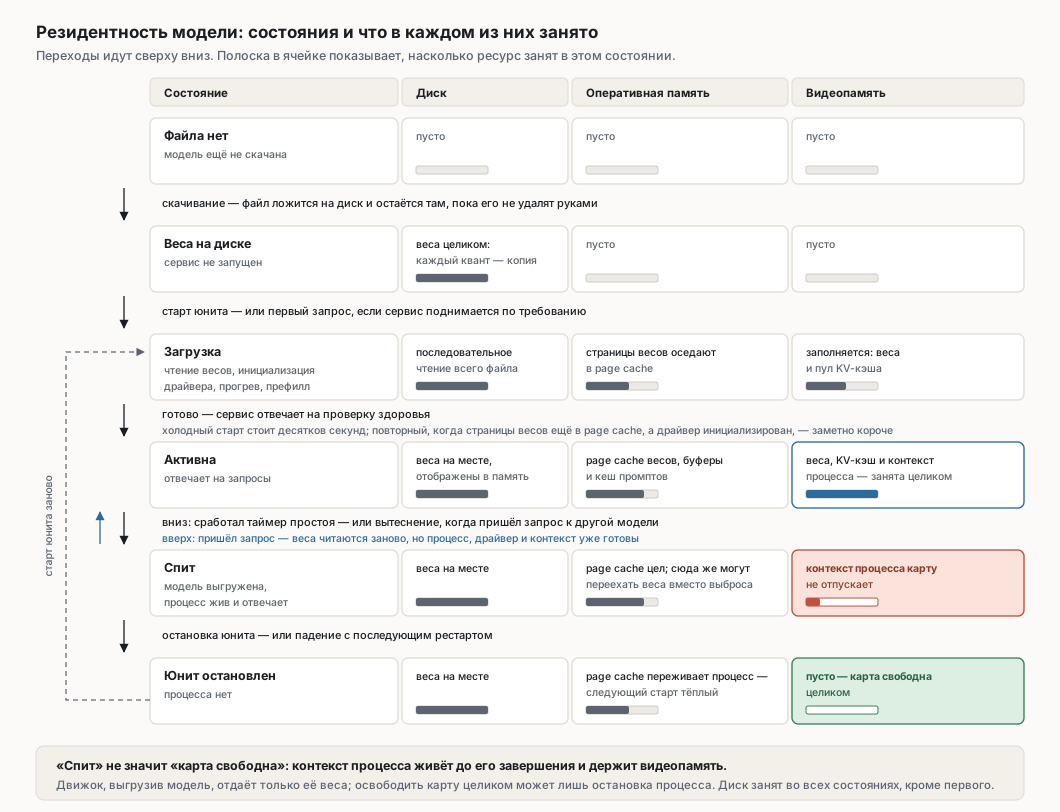
Три реализации выгрузки по простою, которые сегодня стоит знать. Ollama выгружает модель после пяти минут бездействия по умолчанию — «by default models are kept in memory for 5 minutes before being unloaded» (FAQ Ollama, сентябрь 2026); поведение управляется параметром keep_alive в запросе или переменной OLLAMA_KEEP_ALIVE, отрицательное значение означает «держать всегда», ноль — «выгрузить сразу». vLLM реализует sleep mode двух уровней: первый сбрасывает KV-кэш и перекладывает веса в оперативную память, второй выбрасывает и веса; эндпоинты /sleep, /wake_up и /is_sleeping доступны только при VLLM_SERVER_DEV_MODE=1 и запуске с --enable-sleep-mode. llama-server получил автоматический сон по простою через --sleep-idle-seconds (PR #18228; по умолчанию -1, то есть выключено); в режиме сна выгружается модель вместе с KV-кэшем, а обращения к /health, /props, /models и /metrics намеренно не считаются активностью и таймер не сбрасывают (выверялось по README сервера llama.cpp, сентябрь 2026, релиз v0.4.0) — иначе Prometheus, опрашивающий сервис раз в пятнадцать секунд, не дал бы ему заснуть никогда.
Главная ловушка здесь в том, что выгрузка модели и освобождение карты — не одно и то же. Контекст CUDA живёт в процессе и стоит сотни мегабайт видеопамяти сам по себе; пока процесс жив, эта память занята. В llama.cpp это проявилось предметно: в режиме роутера после срабатывания --sleep-idle-seconds дочерний процесс выгружает модель, но остаётся присоединённым к карте, потребляя около 600 МиБ на каждый спящий экземпляр (issue #19379, закрыт как «не планируется»). У vLLM sleep level 1 освобождает видеопамять ценой оперативной — веса переезжают в RAM, и если считать бюджет только по карте, машина неожиданно упирается в своп.
Практический вывод: если карта нужна кому-то ещё — играм, кодированию видео, второй модели, — единственное надёжное «освободить» — это остановить процесс. Сон движка решает другую задачу: он убирает веса, оставляя сервис живым и способным ответить на проверку здоровья мгновенно, и потому уместен на машине, где карта всё равно ничем другим не занята, а экономится в основном простой в энергопотреблении.
Активация по запросу: почему не socket activation
Соблазн очевиден: сокет-активация в systemd существует ровно для того, чтобы демон не висел в памяти без дела. Но она требует от приложения поддержки протокола передачи дескрипторов — процесс должен уметь принять готовый слушающий сокет через LISTEN_FDS. В дереве llama.cpp нет ни одного вхождения LISTEN_FDS, sd_listen_fds или sd_notify (проверено поиском по master, сентябрь 2026), в документации vLLM протокол тоже не упоминается — рассчитывать на это нельзя.
Обходной путь в systemd штатный и называется systemd-socket-proxyd: «One use of this tool is to provide socket activation support for services that do not natively support socket activation». Прокси наследует сокет от systemd, а трафик пересылает в обычный порт сервиса. В паре с --exit-idle-time= у прокси и StopWhenUnneeded= у сервиса это даёт и запуск по первому подключению, и остановку по простою — man прямо описывает эту связку.
Схема работает, но её цена для инференса выше, чем для nginx из примера в документации. Первый клиент после простоя ждёт весь холодный старт целиком — чтение весов, инициализацию драйвера, прогрев, — и всё это время по соединению не идёт ни байта. Ровно на такой тишине срабатывают таймауты прокси, о которых ниже, и клиент получает 504 вместо ответа. Вдобавок пока сервис остановлен, отвечать на /health некому, и мониторинг видит падение вместо простоя.
Вердикт: OS-уровневая активация уместна, когда сервис поднимается редко и запускается быстро — например, для лёгкой модели эмбеддингов. Для языковой модели правильнее держать процесс живым и пользоваться выгрузкой по простою внутри движка: процесс отвечает на проверки, метрики не рвутся, а видеопамять освобождается почти вся.
Юнит: зависимости, готовность, рестарт
Первое, что хочется написать в юните, — упорядочивание по устройству: After=dev-nvidia0.device. Это не работает, и причина документирована: systemd создаёт юниты устройств только для тех устройств, что помечены udev-тегом systemd, «by default all block and network devices, and a few others». Символьные устройства видеокарты в это «few others» по умолчанию не входят, и юнит либо не появится вовсе, либо появится не тогда, когда нужно. Тегировать устройство своим правилом udev можно, но это делает юнит зависимым от локального правила, которого на другой машине не будет.
Надёжнее строить готовность на проверке, а не на порядке загрузки. Драйвер к моменту старта либо отвечает, либо нет, и это выясняется одной командой; если не отвечает — сервис падает и перезапускается, пока не поднимется. Так же решается вопрос с моментом готовности самого сервиса. Сообщить о ней движки не умеют — того же sd_notify в дереве llama.cpp нет, — поэтому Type=notify не подходит и остаётся Type=exec: юнит считается запущенным, как только execve в сервисном процессе отработал успешно. Отсюда следствие, которое стоит проговорить, потому что от systemd обычно ждут обратного: ни TimeoutStartSec=, ни упорядочивание зависимых юнитов загрузку весов не покрывают — с точки зрения менеджера сервис запущен задолго до того, как сможет ответить. Единственный честный признак готовности — успешный ответ /health, и опрашивает его мониторинг или клиент, а не systemd.
# /etc/systemd/system/llama.service
[Unit]
Description=Local LLM inference server
After=network-online.target nvidia-persistenced.service
Wants=network-online.target

[Service]
User=llama
Group=llama
# на AMD этим даётся доступ к /dev/kfd и /dev/dri
SupplementaryGroups=video render
Type=exec
# Драйвер может быть ещё не готов после перезагрузки — тогда падаем и ждём рестарта
ExecStartPre=/usr/bin/nvidia-smi -L
ExecStart=/usr/local/bin/llama-server --host 127.0.0.1 --port 8080 \
    -m /srv/models/model.gguf -c 8192 --metrics --sleep-idle-seconds 900
Restart=on-failure
RestartSec=10s
# Покрывает ExecStartPre и запуск бинаря, но не загрузку весов: при Type=exec
# юнит считается запущенным сразу после успешного execve
TimeoutStartSec=300

[Install]
WantedBy=multi-user.target
Restart=on-failure здесь не формальность: типичная причина падения сервиса инференса — не баг, а ошибка выделения видеопамяти, когда карту на секунду занял кто-то другой. Перезапуск через десять секунд такую ситуацию разруливает сам. Общая механика юнитов, зависимостей и рестарта разобрана в статье про systemd.
Ограничение ресурсов: что имеет смысл ограничивать
Здесь наибольший разрыв между тем, чего ждут, и тем, что работает.
Видеопамять контроллером memory в cgroup не ограничивается: он считает страничный кеш, анонимную память, ядерные структуры и буферы сокетов, и VRAM в этот список не входит. С ядра 6.14 в cgroup v2 есть отдельный контроллер dmem для памяти устройств — файлы dmem.max, dmem.current, dmem.capacity с ключами вида drm/0000:03:00.0/vram0 (в документации ветки 6.13 этого раздела ещё нет). Но регионы в нём регистрируют драйверы, построенные на TTM: в дереве ядра это amdgpu, xe и nouveau (последний — для Tesla и новее). Проприетарный драйвер NVIDIA и его открытые модули ядра TTM не используют и регионов не регистрируют, так что с ними этого рычага нет. Отсутствует он именно у драйвера, а не у карты: та же карта под nouveau регион получает — только без CUDA пользы от этого немного. У systemd соответствующих директив пока тоже нет: запрос на DeviceMemoryMax= (PR #37079) открыт с апреля 2025 и с февраля 2026 висит черновиком, а мейнтейнер ядра Maxime Ripard прямо возражает, что механизм ещё не обобщён дальше видеокарт.
Отсюда правило: видеопамять ограничивается изнутри движка и только там — долей резервирования у vLLM и SGLang, числом слоёв на карте и размером контекста у llama.cpp. Разбор этих параметров — в локальном инференсе.
Ограничивать оперативную память сервису инференса через MemoryMax= — активно вредно, и механизм этого стоит понимать. Веса читаются через mmap, их страницы живут в page cache, а page cache учитывается контроллером памяти в счёт cgroup. Значит, лимит в 8 ГиБ на сервис с 20-гигабайтной моделью означает, что ядро будет непрерывно вытеснять страницы весов, а движок — непрерывно читать их обратно с диска. Формально лимит соблюдён, фактически получена дисковая нагрузка на ровном месте и падение скорости. Если ограничивать всё же нужно (например, чтобы сервис не съел память под свои буферы и кеш промптов — у llama-server это --cache-ram, по умолчанию 8192 МиБ; выверялось по README сервера llama.cpp, сентябрь 2026, релиз v0.4.0), правильный инструмент — MemoryHigh=: он давит на процесс реклеймом, но не зовёт OOM-killer, и документация systemd рекомендует именно его как основной механизм, оставляя MemoryMax= «last line of defense».
| Что ограничиваем | Чем | Работает? |
|---|---|---|
| Видеопамять на NVIDIA | ничем со стороны ОС | нет; только параметрами движка |
| Видеопамять на amdgpu, xe, nouveau | dmem.max в cgroup v2, ядро 6.14+ |
да, но без поддержки в systemd — руками или скриптом |
| Оперативная память | MemoryHigh= |
да, с оговоркой про page cache; MemoryMax= вредит |
| Процессор | CPUQuota= |
бесполезно при инференсе на карте, существенно при выгрузке слоёв на CPU |
| Дисковый ввод-вывод | IOWeight= |
заметно только в момент загрузки весов |
| Доступ к устройствам | DevicePolicy=closed + DeviceAllow= |
да, и это основной рычаг изоляции |
Вердикт: ограничивать сервису инференса имеет смысл ровно две вещи — доступ к устройствам и потолок оперативной памяти через MemoryHigh=. Остальное либо не действует, либо делает хуже. Ограничение главного ресурса живёт в конфигурации движка, и это неустранимое свойство: ОС не управляет памятью ускорителя.
Несколько моделей на одной карте
Три стратегии, и выбор между ними определяется тем, что дороже — видеопамять или ожидание.
Параллельная резидентность: модели загружены одновременно, бюджеты складываются, включая KV-кэш каждой. Переключение мгновенное, суммарный контекст маленький. Ollama идёт этим путём по умолчанию, разрешая держать загруженными до трёх моделей на карту — «the default is 3 * the number of GPUs or 3 for CPU inference» (OLLAMA_MAX_LOADED_MODELS, FAQ Ollama, сентябрь 2026).
Последовательная с вытеснением: загружена одна, приход запроса к другой выгружает первую. Полный бюджет достаётся каждой модели по очереди, ценой холодного старта на каждом переключении. Так работает режим роутера в llama-server: сервер запускается без указания модели, экземпляры поднимаются по требованию, а маршрутизация идёт по полю model в теле запроса.
Гибрид: одна модель резидентна постоянно, редкие подгружаются по требованию. На практике это чаще всего правильный ответ, потому что распределение запросов по моделям обычно сильно перекошено.
Две эксплуатационные детали режима роутера, о которые спотыкаются. Первая: GET /metrics в этом режиме требует параметр ?model= и без него отвечает 400 — значит, в конфигурации Prometheus нужен отдельный target на каждую модель, а не один на сервер. Вторая: запрос, пришедший во время подгрузки, ждёт её целиком, и это ожидание видно клиенту как гигантское время до первого токена. Если переключения частые, задержка переключения становится главной наблюдаемой характеристикой сервиса, и лечится она не настройками очереди, а решением держать ходовую модель резидентной.
Хранение весов
Порядок величин и почему дедупликация не поможет
Коллекция растёт не числом моделей, а числом их вариантов: одна модель среднего размера в двух квантах и с одним дообученным адаптером — это уже три записи в каталоге и десятки гигабайт. Сотня гигабайт набирается незаметно, терабайт — за год спокойного экспериментирования.
Первая мысль — дедуплицировать. Она не работает, и важно понимать почему. Разные кванты одной модели не имеют общих байтов вовсе: квантование меняет представление каждого тензора целиком, так что Q4_K_M и Q6_K одной модели — два независимых файла без единого совпадающего блока. Ни блочная дедупликация ZFS, ни offline-дедупликация Btrfs, ни жёсткие ссылки здесь не находят ничего, зато дедупликация ZFS постоянно стоит оперативной памяти под таблицу. То же с сжатием: квантованные веса — это уже упакованная энтропия, и файловая система на них тратит процессор впустую. Проверяется одной командой, и проверить стоит на своей коллекции:
zstd -19 --stdout model-Q4_K_M.gguf | wc -c # сравнить с размером исходного файла
Где дедупликация действительно работает — там, где один и тот же файл нужен дважды. Кеш Hugging Face устроен ровно так: каталог blobs/ хранит файлы под именами-хешами, а snapshots/<ревизия>/ — символические ссылки на них, так что две ревизии репозитория, отличающиеся конфигом, не удваивают веса. На стороне Hub с той же целью работает Xet: файлы режутся на чанки по содержимому и дедуплицируются между репозиториями, но это экономит трафик при скачивании, а не место на вашем диске (чанковый кеш hf_xet с версии 1.2.0 по умолчанию выключен).
Вердикт: место на диске освобождается удалением неиспользуемых квантов и ревизий, а не хитростями файловой системы. Инструмент для этого есть штатный:
hf cache ls --revisions --filter "size>1GB" --filter "accessed>30d"
hf cache prune          # неотслеживаемые ревизии и обрывки прерванных загрузок
Где держать
Требование к носителю выводится из холодного старта: время загрузки — это размер модели, делённый на скорость последовательного чтения. Разница между NVMe и SATA-SSD здесь видна невооружённым глазом, а сетевая файловая система превращает переключение моделей в минуты. Что определяет скорость последовательного чтения и почему интерфейс и накопитель — разные вещи, разобрано в SATA, SAS и NVMe.
Веса заслуживают отдельного раздела, датасета ZFS или подтома Btrfs, и причина не в производительности, а в политике. У этого каталога своё время жизни (данные восстановимы), своё отношение к снепшотам (откатывать в неизменяемых весах нечего) и своё отношение к бэкапу (не входит). Места сам по себе снепшот весов не занимает — на copy-on-write системе он стоит ровно того, что изменилось после него, — но платить за него приходится в двух других местах: удалённый или переписанный квант перестаёт освобождать место, пока жив снепшот, а zfs send или btrfs send тащит эти сто гигабайт целиком. Смешав веса с системой, вы получите именно это: корень, который не пустеет после удаления моделей, и распухшую на порядок передачу копии. Разумные настройки датасета — сжатие выключено, размер записи крупный: файлы читаются большими последовательными кусками и не переписываются никогда.
Отдельный случай — модель, которая не помещается в оперативную память. Тогда page cache только мешает: страницы вытесняют друг друга, и толку от кеширования нет. llama.cpp даёт для этого --load-mode dio — чтение мимо кеша, — и это тот редкий случай, когда прямой ввод-вывод для локальной машины оправдан.
Целостность
Тихая порча файла весов не даёт ни ошибки загрузки, ни падения: safetensors и GGUF читаются как массивы чисел, и испорченный байт превращается в чуть другое число. Симптом — «модель поглупела», и его почти невозможно связать с диском без проверки.
Поэтому целостность проверяется явно. Для скачанного с Hub есть штатная команда, сверяющая контрольные суммы с теми, что знает Hub:
hf cache verify meta-llama/Llama-3.2-1B-Instruct
Для всего остального работает манифест, составленный в момент загрузки: имя репозитория, хеш ревизии и sha256 каждого файла. Он занимает килобайты, входит в бэкап и отвечает на два разных вопроса — «не испортился ли файл» и «тот ли это файл, что я скачал полгода назад». От недоверенного файла, испорченного изначально, манифест не защищает: это другая задача, и она решается выбором источника и формата (см. ниже про модель угроз).
Фиксация ревизии полезна и сама по себе. Документация Transformers советует загружать модели с кодом по конкретному хешу коммита, «to avoid loading model code that may have changed», — и тот же приём делает воспроизводимым обычную загрузку весов: main в репозитории модели может измениться, и вы этого не заметите.
Что не бэкапить
Веса в резервную копию не входят. Это не экономия, а следствие определения: бэкап нужен для данных, которые нельзя воссоздать, а веса воссоздаются скачиванием. Разработчики huggingface_hub считают так же и кладут в кеш файл CACHEDIR.TAG по стандарту тегирования кеш-каталогов — прямо «tells backup tools (e.g. Borg, restic, rsync) that the directory contains re-downloadable cache data and can safely be excluded from backups». Учтите, что уважение к этому тегу у restic и borg включается флагом --exclude-caches, а не действует само.
Цена решения — время восстановления, и назвать её стоит явно, иначе «веса воссоздаются» звучит как тавтология. Воссоздаются они скачиванием, а скачивание считается делением из начала статьи: сотня гигабайт по домашнему каналу в 100 Мбит/с — это часы, терабайтная коллекция — почти сутки, в течение которых сервиса нет. Это осознанный размен: терабайт в репозитории копий стоит дороже, чем сутки ожидания раз в несколько лет. Но размен перестаёт быть выгодным, как только ожидание неприемлемо, — и тогда веса перестают быть кешем.
Бэкапа заслуживает всё остальное, и оно на удивление маленькое:
- Аргументы запуска движка и юниты. Это и есть конфигурация: контекст, число слотов, доля резервирования, шаблон чата. Восстановить их по памяти нельзя, а весят они килобайты.
- Системные промпты, наборы для оценки, сохранённые сессии — то, что писалось руками.
- Дообученные адаптеры LoRA и результаты слияний. Это единственные веса, которые нигде не лежат, кроме вашей машины, и единственные, которые обязаны быть в копии.
- Базы эмбеддингов. Формально они производные, фактически их пересчёт стоит часов работы карты — редкий случай, когда производные данные дешевле хранить, чем воссоздавать.
- Манифест весов с ревизиями и контрольными суммами.
Оговорка к слову «восстановимы»: репозиторий может стать закрытым, потребовать принятия лицензии или исчезнуть. Манифест не заменяет копию — он лишь гарантирует, что вы знаете, что именно у вас было. Если конкретная версия весов критична для воспроизводимости результата, она перестаёт быть кешем и становится данными, со всеми последствиями для стратегии копирования. Общая рамка — в резервном копировании.
Публикация и доступ
Аутентификация — обязанность прокси
Совместимый с OpenAI эндпоинт как интерфейс интеграции разобран в локальном инференсе; здесь важна другая его сторона — то, что у этого интерфейса почти нет своей модели доступа.
Разброс между движками велик, и знать его нужно точно. llama-server умеет --api-key и --api-key-file (несколько ключей, по одному на строку), а /health остаётся публичным намеренно. У vLLM ключ есть, но его область действия ограничена: аутентификация применяется только к путям, начинающимся с /v1, /v2 и /inference, и документация по безопасности vLLM говорит об этом прямо — «many other sensitive endpoints are exposed on the same HTTP server without any authentication enforcement». У Ollama встроенной аутентификации нет вовсе; запрос на её добавление (PR #9131) открыт с февраля 2025 года, и позиция проекта — пользоваться прокси или VPN.
Вывод из этого делает сама документация vLLM: развернуть сервис «behind a reverse proxy (such as nginx, Envoy, or a Kubernetes Gateway)», который явно перечисляет разрешённые эндпоинты и блокирует остальные. Это и есть правильная схема: ключ движка — второй эшелон, а граница проходит по прокси, где живут TLS, аутентификация и список разрешённых путей. Настройка самого прокси — в обратном прокси и TLS.
Отдельная неожиданность — CORS. У vLLM разрешённые источники по умолчанию ['*']. В переводе на практику: любая открытая в браузере страница может отправить запрос на http://localhost:8000/v1/chat/completions и прочитать ответ. Привязка к 127.0.0.1 от этого не спасает, потому что запрос отправляет ваш собственный браузер изнутри машины. Если сервис слушает локально и используется локальными программами, список источников нужно сузить до реально нужных, а не оставлять умолчание.
Таймауты и буферизация
Здесь интуиция обманывает чаще всего, и разобраться стоит по механизму, а не по рецепту.
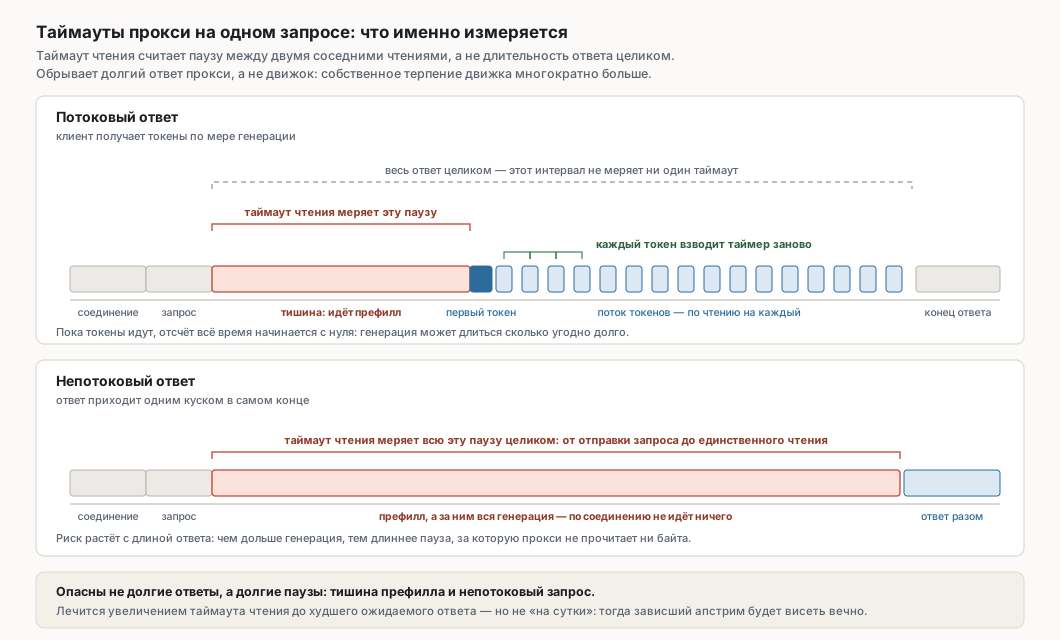
Первое, что стоит заметить: терпение у сторон разное. Собственный таймаут чтения и записи у llama-server — 3600 секунд по умолчанию (--timeout, выверялось по README сервера, сентябрь 2026, релиз v0.4.0), то есть движок готов ждать час. У nginx умолчание в шестьдесят раз меньше, и именно прокси, а не движок, обрывает долгие ответы.
Документация nginx описывает proxy_read_timeout предельно точно: «The timeout is set only between two successive read operations, not for the transmission of the whole response», умолчание — 60 секунд. Отсюда следует то, чего обычно не ждут: потоковый ответ — безопасный случай. Каждый пришедший токен считается чтением и взводит таймер заново, так что генерация может идти хоть двадцать минут, не приближаясь к шестидесятисекундному лимиту.
Опасны ровно два других случая. Первый — долгий префилл: между отправкой запроса и первым токеном по соединению не идёт ничего, и на длинном промпте эта тишина легко превышает минуту. Второй — непотоковый запрос, где ответ приходит одним куском в конце: тишина длится всю генерацию. Оба лечатся увеличением proxy_read_timeout до величины, покрывающей худший ожидаемый ответ, а не «на всякий случай в сутки»: слишком большой таймаут превращает зависший апстрим в вечно висящее соединение.
Вторая половина вопроса — буферизация. proxy_buffering в nginx включён по умолчанию, и при включённой буферизации прокси копит ответ в своих буферах; для SSE это означает, что токены доходят до клиента пачками или не доходят вовсе до конца генерации. Минимальный рабочий фрагмент:
location /v1/ {
    proxy_pass http://127.0.0.1:8080;
    proxy_buffering off;          # иначе поток токенов копится в буфере прокси
    proxy_read_timeout 600s;      # покрывает префилл длинного промпта
    gzip off;                     # сжатие тоже собирает данные в блоки
}
Альтернатива правке конфигурации — заголовок X-Accel-Buffering: no от апстрима: nginx документирует, что буферизацию можно включать и выключать значением yes/no в этом заголовке ответа.
Caddy в этом месте ничего не требует, но по другой причине, чем обычно думают: периодического сброса буфера он не делает вовсе — «by default, no periodic flushing is done», — а ответы с Content-Type: text/event-stream и ответы неизвестной длины сбрасывает клиенту немедленно, игнорируя flush_interval вообще. То есть отключать в Caddy нечего. Директива flush_interval -1 нужна не для SSE, а для потоков, которые под эти условия не подпадают, — отданных с обычным content-type и известной длиной. Вердикт для этой задачи прямой: под сервис инференса Caddy обходится дешевле, потому что потоковая передача у него работает без настройки, а на nginx нужно помнить три директивы; если nginx уже стоит по другим причинам, менять его ради этого не стоит.
Наружу и в локальную сеть
Обе крайности здесь одинаково распространены и одинаково неверны: «у меня локально, значит неважно» и «открою на час, чтобы попробовать с телефона».
Открытый наружу эндпоинт без аутентификации — это, в порядке возрастания неприятности: чужие запросы на вашем электричестве; ваши веса и системные промпты, доступные на чтение через API; и выполнение кода на вашей машине, если движку не повезло с уязвимостью. Последнее — не гипотеза. В Ollama до 0.1.34 недостаточная проверка формата дайджеста давала обход пути и перезапись произвольных файлов через эндпоинт загрузки моделей с последующим выполнением кода (CVE-2024-37032). В vLLM версий 0.10.2–0.11.0 эндпоинт completions принимал пользовательские эмбеддинги промпта и десериализовал их через torch.load без проверки инвариантов разреженных тензоров, что давало запись за границей буфера (CVE-2025-62164, оценка 8.8, исправлено в 0.11.1). В vLLM 0.8.3–0.14.0 запрос к мультимодальному эндпоинту со ссылкой на видео приводил к выполнению кода без аутентификации (CVE-2026-22778, оценка 9.8, исправлено в 0.14.1), и цепочка здесь показательна: vLLM скачивает файл сам (MediaConnector.load_from_url), отдаёт байты в cv2.VideoCapture через OpenCVVideoBackend.load_bytes, а переполнение кучи происходит в декодере JPEG2000 из FFmpeg, который поставляется внутри OpenCV. Собственного кода vLLM в этом месте нет вовсе — дыра жила в транзитивной зависимости, то есть ровно в том слое, о котором говорит раздел про четыре независимых источника поломки.
Обратите внимание на закономерность: две из трёх уязвимостей эксплуатируются содержимым обычного запроса к API, а не отдельным «служебным» эндпоинтом. Значит, аутентификации на прокси недостаточно как единственной меры — она лишь сужает круг тех, кто может попробовать.
Правильный способ дать доступ с других устройств — не открывать порт, а завести сеть: WireGuard или другой VPN, где сервис слушает на адресе туннеля. Публикация через прокси с TLS и аутентификацией — второй допустимый вариант, и он требует того же внимания к обновлениям, что любой публичный сервис.
Наблюдаемость
Общая механика Prometheus, кардинальности и алертов без шума — в наблюдаемости; здесь только то, что специфично для инференса.
Метрики карты
Метрики видеокарты в Prometheus не появляются сами: node_exporter о GPU не знает ничего. Для NVIDIA штатный источник — dcgm-exporter (порт 9400), где набор метрик задаётся CSV-файлом. Две детали стоит знать заранее. Счётчики троттлинга (DCGM_FI_DEV_POWER_VIOLATION, DCGM_FI_DEV_THERMAL_VIOLATION и соседние) в поставляемом наборе закомментированы — то, ради чего экспортер чаще всего и ставят, надо включать руками. И поддержка на потребительских картах ограничена: документация DCGM говорит, что «starting with v1.3, limited DCGM functionality is available on non-datacenter GPUs», так что для одной домашней карты проще и честнее взять экспортер, читающий nvidia-smi. Для AMD официальный инструмент — Device Metrics Exporter из ROCm; прежний amd_smi_exporter объявлен более не развиваемым.
Из метрик карты стоит смотреть на занятую видеопамять (DCGM_FI_DEV_FB_USED), температуру, потребляемую мощность и события снижения частот. А вот утилизация GPU для инференса почти бесполезна и вводит в заблуждение: она показывает долю времени, когда на карте что-то выполнялось, и при декодировании держится около сотни процентов, потому что декодирование упирается в пропускную способность памяти, а не в вычислители. График «GPU 100 %» здесь не значит ни «карта загружена полезно», ни «пора покупать вторую».
Метрики сервиса
Собственные метрики движка отвечают на вопросы, которых метрики карты не касаются. У llama-server эндпоинт /metrics включается флагом --metrics и отдаёт, в частности, llamacpp:requests_processing и llamacpp:requests_deferred (запросы в обработке и отложенные), llamacpp:prompt_tokens_seconds и llamacpp:predicted_tokens_seconds (скорости префилла и генерации), llamacpp:n_busy_slots_per_decode (среднее число занятых слотов на вызов llama_decode). Заполненности KV-кэша среди них нет: такой метрики llama-server не экспортирует (список выверялся по README сервера и по tools/server/server-task.cpp, сентябрь 2026, релиз v0.4.0), и об упоре в пул приходится судить косвенно — по числу отложенных запросов. У vLLM набор доступен на /metrics без дополнительных флагов, и заполненность там есть отдельной величиной: vllm:kv_cache_usage_perc.
Четыре величины, которые действительно нужны на дашборде: длина очереди, время до первого токена, скорость генерации и заполненность пула KV-кэша. Первая говорит, что запросов больше, чем слотов; вторая ухудшается раньше всех при любой деградации; третья ловит переход в неожиданный режим (например, часть слоёв уехала на процессор); четвёртая объясняет, почему выросли первые две — и она же единственная из четырёх, которая достаётся не на всяком движке.
Что алертить
Три полезных алерта и один вредный.
Занятая видеопамять при отсутствии активности — признак застрявшего процесса или утечки. Выражается пересечением двух источников: память занята, запросов нет, состояние держится долго.
- alert: GPUMemoryHeldWhileIdle
  expr: DCGM_FI_DEV_FB_USED > 1024 and on() llamacpp:requests_processing == 0
  for: 30m
Снижение частот под нагрузкой — сигнал теплового или мощностного упора, и его нужно отличать от «стало медленно» по общему ощущению. Здесь работают счётчики событий частоты, включённые в конфигурации экспортера.
Недоступность сервиса — но проверять надо /health, а не занятость карты. С включённой выгрузкой по простою пустая видеопамять — нормальное состояние, и алерт на неё будет срабатывать каждую ночь.
Вредный алерт — на утилизацию GPU, по причинам из предыдущего раздела.
Логи
Содержимое запросов к языковой модели — самые чувствительные данные в этой системе: туда попадают куски документов, ключи, переписка. Поэтому логирование запросов должно быть осознанным решением, а не следствием умолчания.
У vLLM подробное логирование включается флагом --enable-log-requests, причём уровень определяет объём: на INFO пишутся идентификатор и параметры запроса, на DEBUG — «Prompt inputs (e.g: text, token IDs)», то есть сам промпт. Раньше флаг назывался --disable-log-requests, и умолчание было обратным; это тот случай, когда советы из старых статей включают ровно то, что вы хотели выключить.
Второй источник утечки — прокси. Обычный лог доступа записывает метод и URL, а тела запроса не видит, и это правильное поведение; но включённое «для отладки» логирование тел превращает файл журнала в архив всех разговоров. Если запросы всё же нужно писать (для оценки качества, например), они должны храниться отдельно от системных логов, со своим сроком хранения и своими правами доступа, а не уезжать в общий сборщик вместе со всем остальным.
Тепловой режим и питание
Длительная генерация — принципиально иной профиль нагрузки, чем игры, и различие не в величине, а в форме. Игровая нагрузка колеблется вокруг среднего с провалами между кадрами; инференс даёт две разные фазы: короткий префилл, насыщающий вычислители и потребляющий близко к пределу, и долгое декодирование, которое упирается в пропускную способность памяти при умеренном потреблении, но держится сколько угодно долго без пауз.
Из этого следует неожиданный вывод про ограничение мощности. Работа, измерявшая энергопотребление по фазам на H200 (Ma et al., май 2026), показывает, что декодирование потребляет 137–300 Вт на карте с пределом 700 Вт: «no cap ever triggers, because memory-bound decode saturates HBM bandwidth rather than compute and leaves power headroom untouched». То есть ограничение мощности на декодировании не срабатывает вовсе и энергии не экономит, хотя выглядит работающим. Рычаг, который действительно на критическом пути, — фиксация частоты SM; по данным той же работы, она возвращает до 32 % энергии декодирования при небольшой потере пропускной способности.
Переносить эти числа на потребительскую карту напрямую нельзя — соотношение мощности и пропускной способности памяти у неё другое, — но переносится сам механизм: чем сильнее нагрузка упирается в память, тем меньше даёт ограничение мощности.
Дальше идёт вывод уже не из работы, а из механизма, и границу стоит провести явно: потребление префилла в ней измерялось, а вот ограничение мощности на префилле — нет. Практический смысл nvidia-smi -pl поэтому такой: срезать пиковое потребление и нагрев на префилле, удержав систему в пределах блока питания и охлаждения корпуса. А то, что экономии на генерации от него ждать не стоит, — это как раз измерено. Фиксация частот (nvidia-smi -lgc) доступна шире, чем принято думать: man-страница драйвера даёт «Supported on Volta+» и требует root, деления на потребительские и датацентровые карты там нет вовсе, то есть Turing, Ampere, Ada и Blackwell её умеют. Спотыкаются обычно о соседние ключи: -ac такое деление действительно имел и объявлен устаревшим, а -lmc для частоты памяти работает не на всех архитектурах. Ни ограничение мощности, ни фиксация частот не переживают перезагрузку, так что живут они в юните, а не в истории команд.
Всё это — рычаги NVIDIA, и у AMD они называются иначе, хотя логика та же. Потолок мощности пишется в power1_cap в hwmon карты (микроватты), фиксация частот делается через power_dpm_force_performance_level=manual вместе с pp_dpm_sclk и pp_od_clk_voltage; и то, и другое документировано в ядре. Вывод про бесполезность потолка мощности на декодировании от вендора не зависит: он следует из того, что нагрузка упирается в память, а не в вычислители.
Тепло при этом уходит преимущественно в память, а не в кристалл: декодирование гоняет полосу памяти непрерывно. Температура памяти на потребительских картах через NVML доступна не всегда — стоит проверить nvidia-smi -q -d TEMPERATURE на своей и понимать, что отсутствие показателя не означает отсутствия проблемы.
Стоимость простоя считается арифметикой, а не измерением карты: годовое потребление в киловатт-часах равно средней мощности в ваттах, умноженной на 8,76. Машина, потребляющая 60 Вт в простое, обходится в 525 кВт·ч в год независимо от того, сколько раз к ней обратились. Главное здесь то, что доминирует не карта, а остальная система, и настоящее решение — не «ограничить карту», а «держать машину включённой или будить по требованию». Пробуждение по сети возвращает нас к холодному старту со всеми его слагаемыми, включая инициализацию драйвера; если запросы приходят несколько раз в день, это разумный размен, если каждые полчаса — нет.
Модель угроз и приватность
Что уходит наружу, а что нет
Фактическая сторона вопроса без агитации. При обращении к облачному API провайдеру уходит промпт целиком со всеми вложенными документами, а также метаданные: время, объём, модель, идентификатор ключа. Что с этим происходит дальше, определяется договором и политикой хранения, а не техникой, и проверить исполнение снаружи нельзя.
При локальном инференсе не уходит ничего из содержимого запросов. Но «локально» не равно «приватно» по двум причинам. Во-первых, приватен движок, а не окружение: веб-интерфейс, размещённый на чужом сервере и ходящий к вашему эндпоинту, возвращает задачу в исходное состояние. Во-вторых, наружу утекает метаинформация: скачивание весов сообщает Hub, какие модели вас интересуют, а проверки обновлений — что и когда у вас запущено.
Поверхность атаки
У локального сервиса инференса три независимых входа, и защищаются они разными средствами.
Открытый порт — обсуждался выше; закрывается сетью и прокси.
Содержимое запроса — вход, который недооценивают. Современный OpenAI-совместимый API принимает не только текст: тензоры эмбеддингов, изображения, ссылки на медиа, которые сервер скачивает сам. Каждый из этих путей — разбор недоверенных данных сложным кодом, и две уязвимости vLLM из предыдущего раздела эксплуатируются именно так. Отсюда практическое: если мультимодальность и приём эмбеддингов не нужны, их лучше не публиковать — список разрешённых путей на прокси решает и эту задачу.
Файл весов — вход, о котором соседняя статья говорит подробно: pickle-форматы исполняют код при загрузке, safetensors и GGUF — нет. Добавить к этому стоит два места, где код исполняется помимо формата весов. Первое — код модели в репозитории: trust_remote_code=True в Transformers означает выполнение modeling.py из чужого репозитория, и документация советует по крайней мере фиксировать хеш коммита. Второе — шаблон чата: это Jinja-шаблон, поставляемый вместе с моделью, и его вычисление — не чтение данных.
Изоляция
Отдельный пользователь без оболочки — минимум, который стоит копейки. Дальше начинается специфика: PrivateDevices=yes, обычная рекомендация для сетевых демонов, здесь неприменима, потому что документация systemd описывает её действие однозначно — новый /dev только с псевдоустройствами, «but no physical devices». Видеокарта — физическое устройство, и сервис её потеряет.
Правильная замена — закрытая политика с явным списком:
[Service]
DevicePolicy=closed
DeviceAllow=/dev/nvidiactl rw
DeviceAllow=/dev/nvidia0 rw
DeviceAllow=/dev/nvidia-uvm rw
DeviceAllow=/dev/nvidia-uvm-tools rw
# /dev/nvidia0 — по номеру карты: на машине с двумя картами нужна строка на каждую
# на AMD вместо строк выше: /dev/kfd и /dev/dri/renderD128
ProtectSystem=strict
ProtectHome=yes
PrivateTmp=yes
NoNewPrivileges=yes
ReadOnlyPaths=/srv/models
ReadOnlyPaths= на каталоге весов стоит отдельного упоминания: сервису инференса не нужно право записи туда, где лежат модели, а именно эта запись была целью обхода пути в Ollama. Разбор самих директив и того, что даёт каждая, — в безопасности и hardening.
Контейнер добавляет к этому изоляцию зависимостей, что для мира, где CUDA, PyTorch и движок связаны версиями, само по себе весомо. Но границу он даёт более тонкую, чем обычно: устройство прокинуто внутрь, а значит, поверхность ioctl-вызовов драйвера доступна из контейнера так же, как с хоста. Вердикт: для одной машины отдельный пользователь плюс песочница systemd дают лучшее отношение пользы к сложности; контейнер берут тогда, когда нужно зафиксировать версии вычислительной среды или держать рядом несколько несовместимых движков.
Нюансы и trade-off'ы
Своя машина против аренды карты
| Ось | Своя машина | Аренда GPU |
|---|---|---|
| Структура затрат | капитальная, тратится сразу и целиком | операционная, по часам работы |
| Простой | оплачен заранее плюс электричество | бесплатен |
| Данные | не покидают машину | у арендодателя, включая содержимое диска |
| Задержка старта | секунды | минуты на поднятие инстанса и загрузку весов |
| Потолок железа | то, что куплено | любой доступный, вплоть до нескольких карт |
| Кто чинит драйвер | вы | образ уже собран |
Точка безубыточности считается прямо: своя карта дешевле, когда цена покупки меньше, чем часовая ставка аренды, умноженная на число часов реального использования за срок жизни карты. Подставив в это выражение честное число часов, большинство обнаруживает, что по деньгам аренда выигрывает: домашняя карта работает под нагрузкой десятки часов в месяц, а амортизируется круглосуточно.
Вердикт поэтому такой: своя машина покупается не ради экономии, а ради приватности, отсутствия зависимости от чужого расписания и мгновенной готовности. Если решающим аргументом оказывается стоимость часа вычислений — считайте аренду, она почти наверняка дешевле. Разумная комбинация — небольшая постоянная модель локально и аренда под разовые тяжёлые задачи вроде дообучения.
Когда локальный инференс объективно проигрывает
Честный список, где спорить не о чем: когда нужна лучшая доступная модель, а не лучшая помещающаяся; когда нужен очень длинный контекст, потому что KV-кэш растёт линейно и упирается в карту раньше всего; когда нагрузка редкая и рваная, потому что простой оплачен полностью; когда пользователей несколько и они приходят одновременно; когда нужна модель, вышедшая вчера. Экономическая сторона выбора разобрана в локальном инференсе, здесь — только эксплуатационная.
Четыре независимых источника поломки при обновлении
Стек инференса состоит из четырёх слоёв, которые версионируются отдельно и ломаются независимо. Понимание этого экономит вечера.
Драйвер и модуль ядра. Классический симптом — Failed to initialize NVML: Driver/library version mismatch сразу после обновления пакета: пользовательские библиотеки уже новые, а загруженный модуль ядра остался старым. Модуль нельзя выгрузить, пока карту кто-то держит, — то есть пока загружена модель, — так что лечится это перезагрузкой или остановкой сервиса с последующей выгрузкой модулей.
Вычислительная среда. Минимальная версия драйвера для CUDA задана жёстко: для 13.x это 580 и новее. Пакет прямой совместимости, позволяющий запустить новый CUDA на старом драйвере, доступен только для датацентровых карт и отдельных серверных SKU — на потребительской карте обойти требование нечем, нужно обновлять драйвер.
Движок. Меняются умолчания и исчезают возможности. Показательный пример: llama.cpp в декабре 2024 года (PR #10446) убрал типы Q4_0_N_M в пользу перепаковки во время выполнения, и файлы GGUF с этими типами перестали загружаться — «support for Q4_0_N_M model files has been removed and cannot be made anymore».
Формат весов и сами веса. Новые архитектуры требуют свежего движка, старые кванты выпадают из поддержки, конвертеры меняют раскладку метаданных.
Эти четыре слоя связаны в цепочку сверху вниз, и хуже всего, когда цепочку заклинивает снизу. Ветка драйвера 580 — последняя для архитектур Maxwell, Pascal и Volta; для GeForce на этих архитектурах после финального релиза в октябре 2025 остаются только ежеквартальные обновления безопасности до октября 2028 года. Старая карта фиксирует ветку драйвера, ветка драйвера — доступный CUDA, CUDA — версию движка, движок — набор форматов весов. Через пару лет это выглядит как «на моей карте не запускается новая модель», хотя памяти на ней достаточно.
Отсюда простая дисциплина: обновлять слои по одному, а не разом; фиксировать версию движка явно и проверять на своей модели после обновления; держать предыдущий пакет драйвера до тех пор, пока новый не отработал под нагрузкой.
Сравнение с FreeBSD
Эта статья Linux-центрична не по предпочтению, а по устройству экосистемы, и стоит назвать причину прямо.
Драйвер NVIDIA для FreeBSD существует и обеспечивает графику, но CUDA он не даёт: модуль nvidia-uvm.ko, без которого CUDA не работает, не портирован, и разбор устройства драйвера, сделанный Остином Шейфером, приводит причину прямо — «CUDA libraries are missing, so there's no reason to port this». Тот же разбор называет среди главных пробелов и Vulkan, но эта половина устарела: pkg-plist порта x11/nvidia-driver (версия 595.99.02 — та же production-ветка, что и на Linux) содержит share/vulkan/icd.d/nvidia_icd.json, share/vulkan/implicit_layer.d/nvidia_layers.json и libnvidia-glvkspirv.so, а в Makefile эти строки вырезаются из списка только для версий младше 460. Vulkan у драйвера есть.
Отпадает без CUDA поэтому меньше, чем кажется. NVML в порту есть: установлены bin/nvidia-smi и lib/libnvidia-ml.so, так что телеметрия карты доступна (работают ли на FreeBSD отдельные ключи вроде -pl, здесь не проверялось). Не хватает демона постоянства: бинарников в порту ровно три — nvidia-bug-report.sh, nvidia-debugdump и nvidia-smi, — и nvidia-persistenced среди них нет. dcgm-exporter отпадает вместе с DCGM, у которого в списке поддерживаемых платформ только дистрибутивы Linux. И отпадают движки с CUDA-бэкендом.
Что остаётся на FreeBSD: инференс на процессоре, который работает штатно и упирается в пропускную способность оперативной памяти; Vulkan-бэкенд llama.cpp, которому драйвер даёт ICD, — с оговоркой, что порт misc/llama-cpp собирается без ускорительных бэкендов вовсе (единственная опция в его Makefile — EXAMPLES), так что сборку придётся делать руками, и работоспособность этой связки здесь не проверялась; и проброс карты в виртуальную машину с Linux — механика этого разобрана в bhyve.
Всё, что в этой статье не про ускоритель, переносится на FreeBSD прямо и без потерь: рассуждение про то, что не бэкапить, про таймауты и буферизацию на прокси, про модель угроз и про манифест целостности не зависит от операционной системы. Различие ровно одно, но фундаментальное: слой драйвера и вычислительной среды.
Источники
- Документация ядра Linux: cgroup v2 — контроллер
dmemи его файлыdmem.max/dmem.current/dmem.capacityс ключами видаdrm/<bdf>/vram0(раздел проdmemесть вDocumentation/admin-guide/cgroup-v2.rstветки v6.14 и отсутствует в v6.13); состав того, что учитывает контроллерmemory(page cache, анонимная память, ядерные структуры, буферы сокетов); семантикаmemory.highиmemory.max - Исходники ядра:
amdgpu_vram_mgr.c,xe_ttm_vram_mgr.cиnouveau_ttm.c— регистрация регионовdmemдрайверами на TTM; вnouveauэтоdrmm_cgroup_register_region(drm->dev, "vram", …)вnouveau_ttm_init_vram()для Tesla и новее - Документация ядра: управление питанием и частотами amdgpu —
power1_capв hwmon,power_dpm_force_performance_level,pp_dpm_sclk,pp_od_clk_voltage - systemd: PR #37079,
DeviceMemoryMax=— открыт 10 апреля 2025, переведён в черновик в феврале 2026, возражение Maxime Ripard о неготовности механизма за пределами видеокарт - systemd.service(5) —
Type=simpleсчитает юнит запущенным сразу послеfork(),Type=exec— после успешногоexecve(); что покрываетTimeoutStartSec= - systemd.resource-control(5) —
MemoryHigh=как основной механизм иMemoryMax=как «last line of defense»;DevicePolicy=,DeviceAllow=и их реализация через eBPF - systemd.exec(5) —
PrivateDevices=даёт только псевдоустройства, «but no physical devices» - systemd.device(5) — юниты устройств создаются только для помеченных udev-тегом
systemd, «by default all block and network devices, and a few others» - systemd-socket-proxyd(8) — сокет-активация для сервисов без её поддержки,
--exit-idle-time=в связке соStopWhenUnneeded= - NVIDIA: Driver Persistence — «long load times for each CUDA job, on the order of seconds»; демон постоянства как замена legacy-режима
nvidia-smi -pm - NVIDIA: CUDA Compatibility — минимальные версии драйвера (для CUDA 13.x — 580+); пакет прямой совместимости только для датацентровых карт и отдельных SKU
- NVIDIA: Unix Drivers — актуальные ветки на 6 сентября 2026: production 595.99.02, new feature 610.57.04
- NVIDIA: план поддержки Maxwell, Pascal и Volta — 580 как последняя ветка, квартальные обновления безопасности до октября 2028
- man-страница
nvidia-smi—-lgc/--lock-gpu-clocks: «Supported on Volta+. Requires root»;-acкак устаревший ключ с делением по SKU; оговорка к-lmc - dcgm-exporter и его набор метрик — порт 9400, конфигурация через CSV, счётчики троттлинга закомментированы по умолчанию
- NVIDIA DCGM: поддерживаемые платформы — «starting with v1.3, limited DCGM functionality is available on non-datacenter GPUs»; в списке поддерживаемых систем только дистрибутивы Linux
- AMD Device Metrics Exporter — официальная замена
amd_smi_exporter - llama.cpp: README HTTP-сервера —
--sleep-idle-secondsи исключения из таймера простоя, режим роутера и?model=для GET-эндпоинтов,--api-key/--api-key-file,--metricsи список метрикllamacpp:*(метрики заполненности KV-кэша в нём нет),--load-modeс вариантамиmmap/mlock/dio,--cache-ram(по умолчанию 8192 МиБ), таймаут сервера 3600 с - llama.cpp:
tools/server/server-task.cpp—server_task_result_metrics::to_metrics(), полный список экспортируемых счётчиков и датчиков - llama.cpp: issue #19379 — после сна в режиме роутера дочерний процесс остаётся присоединённым к карте, около 600 МиБ на экземпляр
- llama.cpp: PR #10446 — удаление типов
Q4_0_N_Mв пользу перепаковки во время выполнения, декабрь 2024 - vLLM: Sleep Mode — уровни 1 и 2, эндпоинты
/sleep,/wake_up,/is_sleeping, требованиеVLLM_SERVER_DEV_MODE=1 - vLLM: Security — область действия
--api-key(/v1,/v2,/inference), «many other sensitive endpoints are exposed on the same HTTP server without any authentication enforcement», рекомендация ставить обратный прокси со списком разрешённых эндпоинтов - vLLM: метрики —
vllm:kv_cache_usage_perc,vllm:num_requests_waiting,vllm:time_to_first_token_seconds - vLLM: параметры
vllm serve—--enable-log-requestsи разница между INFO и DEBUG, умолчания хоста и CORS - GHSA-mrw7-hf4f-83pf (CVE-2025-62164) —
torch.loadнад пользовательскими эмбеддингами промпта, версии 0.10.2–0.11.0, исправление в 0.11.1 - GHSA-4r2x-xpjr-7cvv (CVE-2026-22778) — выполнение кода по ссылке на видео в мультимодальном эндпоинте: цепочка
MediaConnector.load_from_url→OpenCVVideoBackend.load_bytes→cv2.VideoCapture, переполнение в декодере JPEG2000 из FFmpeg внутри OpenCV; версии 0.8.3–0.14.0, оценка 9.8, исправление в 0.14.1 - Wiz: Probllama (CVE-2024-37032) — обход пути через эндпоинт загрузки моделей в Ollama до 0.1.34
- Ollama: FAQ — выгрузка модели через 5 минут,
keep_aliveиOLLAMA_KEEP_ALIVE,OLLAMA_MAX_LOADED_MODELS, привязка к 127.0.0.1:11434 - Ollama: PR #9131 — запрос на встроенную аутентификацию, открыт с февраля 2025
- huggingface_hub: управление кешем — раскладка
blobs/snapshots/refs, дедупликация по хешу файла между ревизиями,CACHEDIR.TAG, командыhf cache ls/rm/prune/verify, чанковый кеш Xet и его отключение по умолчанию сhf_xet1.2.0 - Transformers: загрузка моделей —
trust_remote_code=Trueисполняет код из репозитория, рекомендация фиксировать хеш коммита - restic: exclude-caches — исключение каталогов с
CACHEDIR.TAGтолько по явному флагу - nginx: ngx_http_proxy_module —
proxy_read_timeout60 с и «only between two successive read operations»,proxy_bufferingвключён по умолчанию, заголовокX-Accel-Buffering - Caddy: reverse_proxy —
flush_intervalи автоматическое отключение буферизации дляtext/event-streamи ответов неизвестной длины - Ma et al. The Illusion of Power Capping in LLM Decode, май 2026 — декодирование потребляет 137–300 Вт на карте с пределом 700 Вт, ограничение мощности не срабатывает, фиксация частот возвращает до 32 % энергии декодирования
- Austin Shafer. Anatomy of the FreeBSD NVIDIA driver — «CUDA libraries are missing, so there's no reason to port this»,
nvidia-uvm.koне портирован; часть про Vulkan устарела - Порт
x11/nvidia-driverв дереве FreeBSD —pkg-plistсnvidia_icd.json,nvidia_layers.json,libnvidia-glvkspirv.so,bin/nvidia-smiиlib/libnvidia-ml.so; условие.if ${NVVERSION:R} < 460вpost-install; версия 595.99.02 вMakefile.version - Порт
misc/llama-cppв дереве FreeBSD — единственная опция сборкиEXAMPLES, ускорительных бэкендов нет
Связанные заметки
- Локальный инференс LLM: движки, квантование, бюджет памяти — как модель считает и сколько памяти занимает; эта статья продолжает её с того места, где сервис нужно эксплуатировать
- Linux — systemd: init, сервисы, таймеры — юниты, зависимости, рестарт и сокет-активация, на которых строится жизненный цикл сервиса
- Наблюдаемость: Prometheus, node_exporter, Grafana, Loki — куда складываются метрики карты и движка и как не завести шумных алертов
- Обратный прокси и TLS: nginx vs Caddy — общая механика публикации, в которую здесь добавлены таймауты под долгую генерацию и потоковая передача
- Резервное копирование: стратегия, инструменты, проверка восстановления — рамка, в которой веса оказываются кешем, а адаптеры и промпты — данными
- Linux — безопасность: hardening, SELinux/AppArmor — директивы песочницы systemd и модель привилегий, из которых собирается изоляция сервиса
- SATA, SAS и NVMe — от скорости последовательного чтения зависит время холодного старта
- FreeBSD — bhyve: виртуализация после jails — проброс PCI как единственный способ получить CUDA на машине с FreeBSD
Из библиотеки института уносят только знания. Читателей здесь не считают: посещение не регистрируется, отметок в издании не остаётся, счётчиков нет ни у одного издания фонда.
Издание пополняется и пересверяется. Текст доступен на условиях CC BY-SA 4.0 — унесённое можно передавать дальше на тех же условиях.