Обзор
Запуск языковой модели на своей машине выглядит как задача из области машинного обучения, а по существу это задача управления ресурсами. Модель — это несколько десятков гигабайт весов, которые нужно разместить в памяти с высокой пропускной способностью и прочитать целиком на каждый сгенерированный токен. Всё остальное — производные от этого факта: почему квантование даёт не только экономию места, но и прирост скорости; почему видеокарта с быстрой памятью важнее видеокарты с быстрыми вычислительными блоками; почему движки для нагруженного сервера заранее забирают почти всю видеопамять, а движки для одного пользователя — нет.
Полезнее всего здесь то, что современные движки инференса переизобретают решения, которым в операционных системах несколько десятилетий. Пул KV-кэша, нарезанный на блоки фиксированного размера с таблицей отображения логических блоков в физические, — это страничная память. Переиспользование общего префикса между запросами — это разделяемая страница. Вытеснение запроса из пула при нехватке места — это своппинг, причём с тем же выбором между «выгрузить и вернуть» и «выбросить и пересчитать». Разбирать инференс в этих терминах и точнее, и дешевле, чем в терминах фреймворков: фреймворки меняются каждые полгода, а компромисс между резервированием и гибкостью — нет.
Статья разбирает механизм генерации токена ровно настолько, насколько это нужно для счёта памяти и скорости; дальше — слои экосистемы, стратегии управления памятью, квантование, расчёт бюджета на разных объёмах видеопамяти и эксплуатация. Теории обучения, внимания и архитектуры трансформера здесь нет сверх необходимого. Данные приведены по состоянию на начало сентября 2026 года; версии, на которых выверялись конкретные утверждения, названы в тексте, а то, что подтвердить не удалось, помечено прямо.
Что происходит при генерации токена
Prefill и decode — две разные нагрузки
Генерация распадается на две фазы, и они противоположны по характеру нагрузки. Сначала модель обрабатывает промпт целиком — это prefill: все токены входа проходят через сеть за один проход, матричные умножения получаются большими, вычислительные блоки заняты почти полностью. Затем начинается decode: модель выдаёт по одному токену за проход, каждый раз считывая все веса ради умножения на вектор из одного токена.
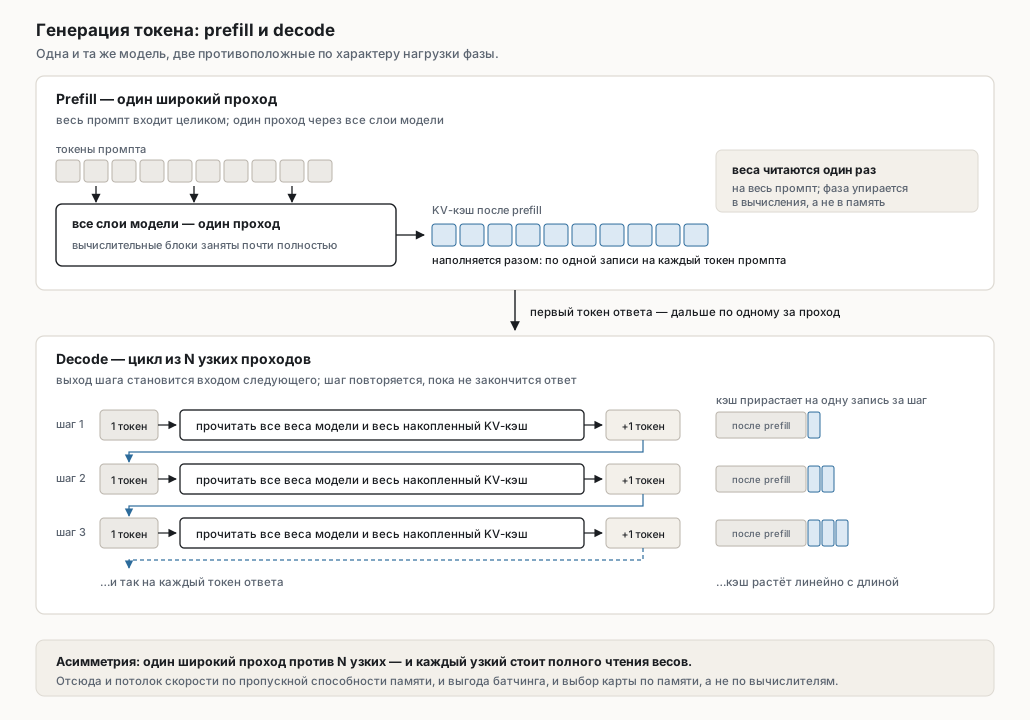
Авторы Sarathi формулируют разницу прямо: prefill насыщает вычислительные блоки уже при малых размерах батча, тогда как decode даёт низкую загрузку вычислителей, поскольку производит по одному токену на запрос за итерацию. Отсюда растёт вся практика: chunked prefill (нарезать длинный промпт на куски и досыпать в тот же батч запросы на decode) появился именно как способ занять простаивающие вычислители полезной работой.
Практическое следствие, которое видно на любой машине: скорость обработки промпта и скорость генерации — разные числа, различающиеся на порядок и больше, и мерить их надо раздельно. Длинный промпт при быстрой генерации — это долгое ожидание первого токена и быстрая выдача после него.
Потолок скорости считается по памяти, а не по вычислениям
Для decode при одном запросе арифметика простая: чтобы выдать один токен, надо прочитать все веса модели. Значит, верхняя граница скорости — это пропускная способность памяти, делённая на размер модели в памяти:
токенов/с ≤ пропускная способность памяти (Б/с) / размер весов (Б)
Модель на 8 млрд параметров в четырёхбитном кванте занимает около 4,6 ГБ. На видеокарте с 1792 ГБ/с (столько заявлено у NVIDIA RTX PRO 6000 Blackwell) это даёт потолок около 390 токенов в секунду; на машине с двухканальной DDR5-6400 — 6400 МТ/с на 16 байт шины дают 102,4 ГБ/с, то есть около 22 токенов в секунду; на NVIDIA DGX Spark с 273 ГБ/с — около 59. Реальные числа ниже потолка примерно на треть-половину — это оценка порядка, а не замер: считываются ещё KV-кэш и активации, а сама выборка идёт не на пиковой скорости. Но порядок величины формула даёт верно, и это лучший способ за пять секунд понять, стоит ли вообще пробовать конкретную связку модели и железа.
Обратная сторона той же арифметики: вычислительные блоки при генерации для одного пользователя простаивают. На каждый прочитанный байт весов приходится примерно два умножения-сложения, тогда как современному ускорителю, чтобы насытить вычислители, нужны сотни операций на байт. Загрузка вычислителей при decode с батчем в один запрос измеряется процентами — за это и не жалко платить, покупая карту с быстрой памятью вместо карты с быстрыми тензорными ядрами.
Ситуация меняется, как только запросов становится много. Веса читаются один раз на итерацию независимо от того, сколько запросов в батче, — значит, каждый добавленный в батч запрос почти бесплатен по памяти и переводит нагрузку из режима «упёрлись в пропускную способность» в режим «упёрлись в вычисления». Это и есть причина, по которой серверные движки строятся вокруг батчинга, а движки для одного пользователя — нет.
Единственный механизм, поднимающий потолок для одного пользователя, — спекулятивное декодирование, и работает он ровно по той же арифметике. Маленькая модель-черновик (или вообще поиск повторов по n-граммам в уже написанном тексте) предлагает несколько следующих токенов, а основная модель проверяет их все за один проход, то есть за одно чтение весов: проверить k предложенных токенов стоит по памяти столько же, сколько сгенерировать один. Принятые токены остаются, первый непринятый и всё за ним отбрасываются, а схема принятия построена так, что распределение выхода не меняется — vLLM формулирует это как «theoretically lossless up to the precision limits of hardware numerics». Выигрыш поэтому равен доле принятых токенов и целиком зависит от того, насколько черновик угадывает основную модель; сам черновик тоже занимает память и часть пропускной способности. Поддержано это и в llama.cpp (-md с моделью-черновиком, --spec-draft-n-max — по умолчанию черновик на 3 токена, --spec-type с вариантами без отдельной модели вроде n-грамм), и в vLLM (speculative_config: черновая модель, n-граммы, EAGLE, MTP). Документация vLLM прямо отмечает, что черновая модель, EAGLE и MTP дают наибольший выигрыш при низком потоке запросов, — то есть в интерактивном сценарии одного пользователя, где батчинг бесполезен.
Модели с разреженной активацией (MoE) ломают формулу в приятную сторону: на каждый токен читаются не все веса, а только внимание, общие слои и несколько выбранных маршрутизатором экспертов. У Qwen3-30B-A3B из 128 экспертов на токен активны 8, то есть при 30 млрд параметров на диске за токен читается порядка 3 млрд. Для машины с медленной памятью это принципиально: MoE позволяет разменять ёмкость (которой на машинах с единой памятью много) на пропускную способность (которой мало).
KV-кэш: откуда берётся и как растёт
Чтобы не пересчитывать внимание по всему префиксу на каждом шаге, ключи и значения для уже обработанных токенов сохраняются. Это и есть KV-кэш, и он — вторая по величине статья расхода памяти после весов. Размер считается точно, из конфигурации модели:
байт на токен = 2 (K и V) × слоёв × KV-голов × размер головы × байт на элемент
Возьмём Qwen3-8B (config.json: 36 слоёв, 8 KV-голов, размер головы 128, bfloat16). На токен выходит 2 × 36 × 8 × 128 × 2 = 147 456 байт, ровно 144 КиБ. Полный контекст этой модели — 40 960 токенов, то есть 5,6 ГиБ кэша при 4,6 ГБ весов в четырёхбитном кванте. Кэш больше модели, и это нормальное положение дел, а не патология.
Два множителя в формуле стоит рассмотреть отдельно, потому что именно ими архитектуры моделей сдерживают рост кэша.
Число KV-голов. В классическом многоголовом внимании их столько же, сколько голов запроса. Grouped-query attention даёт нескольким головам запроса делить одну пару ключ-значение: у Qwen3-8B 32 головы запроса и 8 KV-голов, то есть кэш вчетверо меньше, чем был бы при MHA (144 КиБ против 576 КиБ на токен, 5,6 против 22,5 ГиБ на полном контексте). Подавляющее большинство моделей, выпущенных после 2023 года, использует GQA или её родственников, и оценки «KV-кэш для 7B на 4k контекста — 2 ГиБ», унаследованные от эпохи Llama 2, завышают расход в разы.
Длина, по которой копится кэш. Она равна длине контекста только в моделях, где все слои смотрят на весь префикс. В gpt-oss-20b config.json объявляет чередование: половина слоёв — полное внимание, половина — скользящее окно в 128 токенов. Для слоёв со скользящим окном кэш не растёт вовсе после первых 128 токенов, и линейный рост суммарного кэша с длиной контекста сохраняется, но с вдвое меньшим коэффициентом.
Второй множитель, который часто забывают, — число одновременных запросов. Кэш существует на каждую последовательность отдельно, поэтому память под него растёт как произведение длины контекста на число параллельных запросов. Сервер, обслуживающий восемь клиентов по 8 тысяч токенов, тратит столько же, сколько один клиент с контекстом на 64 тысячи. Это ровно тот ресурс, ради управления которым и написаны PagedAttention и всё, что за ней последовало.
Что из этого следует для выбора железа
Три вывода, каждый прямо из арифметики выше. Для одного пользователя решает пропускная способность памяти, а не вычислительная мощность: между картой с более быстрыми ядрами и картой с более быстрой памятью при равном объёме выбирать надо вторую. Объём памяти решает раньше скорости: модель, которая не влезла, работает не медленнее, а на порядок медленнее (см. раздел про выгрузку), поэтому 24 ГБ медленной памяти почти всегда лучше 16 ГБ быстрой. И, наконец, длинный контекст — это покупка памяти, а не покупка вычислений: 128 тысяч токенов контекста у 30B-MoE вроде Qwen3-30B-A3B (48 слоёв, 4 KV-головы, размер головы 128 — то есть 96 КиБ на токен) стоят 12 ГиБ кэша сверх весов.
Слои экосистемы
Слово «запустить модель локально» покрывает четыре разных класса инструментов, и их регулярно сравнивают между собой, хотя сравнивать надо внутри класса.
| Слой | Представители | Модель памяти | Кому |
|---|---|---|---|
| Обёртка | Ollama, LM Studio, Jan | наследует от движка, настройки спрятаны | один пользователь, «поставил и работает» |
| Движок | llama.cpp, ExLlamaV3, MLX | выделение по факту потребности | одна машина, нестандартное железо, ручной контроль |
| Сервер под нагрузку | vLLM, SGLang, LMDeploy | пул страниц, резерв заранее | много одновременных запросов, карта отдана целиком |
| Датацентровый слой | TensorRT-LLM | пул плюс компиляция под конкретный GPU | парк NVIDIA, выжимаются последние проценты |
Обёртки — это приложение вокруг чужого движка: реестр моделей, автоподбор параметров, графический интерфейс или одна команда установки. Ollama использует llama.cpp, собственный движок поверх GGML и MLX (заметки к релизу 0.33.3 от 2 сентября 2026 отмечают обновление и llama.cpp, и MLX); Jan построен на llama.cpp; LM Studio умеет держать рядом модели llama.cpp и MLX и с июля 2025 бесплатен в том числе для работы. Они экономят время ровно до того момента, когда нужно поменять что-то, чего в их модели настроек нет.
Движки — это то, что действительно исполняет модель. llama.cpp примечателен портируемостью: один и тот же код собирается под CUDA, ROCm, Metal, Vulkan, SYCL и чистый CPU, и на нерыночном железе это часто единственный работающий вариант. ExLlamaV3 — специализированный движок под потребительские NVIDIA-карты со своим форматом квантования EXL3 (вариант QTIP), где авторы заявляют когерентную работу Llama-3.1-70B на 1,6 битах на вес и инференс в пределах 16 ГБ видеопамяти при кэше на 4096 токенов. MLX — фреймворк Apple под единую память Apple silicon, где массивы живут в общей памяти и устройство выбирается для операции, а не для данных.
На Apple silicon эти два движка стоят рядом, и выбор между ними стоит делать так: по умолчанию llama.cpp, MLX — когда нужна максимальная скорость именно на этой машине и нужная модель в MLX-формате уже опубликована. Причина не в бенчмарках, а в охвате и переносимости: GGUF выходит почти для любых весов и почти сразу, MLX-конвертация есть не для всякой модели, а навык работы с llama.cpp переносится на любую другую машину, тогда как MLX за пределы Apple не выходит. Аргумент в обратную сторону ровно один, но весомый: MLX написан под конкретное железо и первым получает его новые возможности — Ollama, например, включает поддержку новых мультимодальных моделей именно на MLX-движке (заметки к 0.33.3). Разброс между этими двумя движками меньше, чем между квантами одной модели, так что начинать выбор с движка — неверный порядок.
Серверы под нагрузку отличаются от движков не качеством, а точкой оптимизации: они оптимизируют суммарную пропускную способность на многих одновременных запросах, платя за это предварительным захватом памяти. vLLM и SGLang — основные; LMDeploy — третий, разработка команд MMRazor и MMDeploy, с двумя движками на выбор: TurboMind на CUDA-ядрах и запасным на чистом PyTorch.
Датацентровый слой — TensorRT-LLM. Здесь стоит отметить сдвиг, который ломает привычное описание: в релизе 1.2 из TensorRT-LLM удалён сам бэкенд TensorRT («TensorRT backend removed. PyTorch is now the sole execution backend»), вместе с ним ушли trtllm-build, trtllm-refit, trtllm-prune и per-model скрипты convert_checkpoint.py. Документация ведёт к trtllm-serve и LLM API, а не к связке с Triton Inference Server, как было принято раньше. То есть «TensorRT-LLM с Triton» как рекомендуемая конфигурация — описание вчерашнего дня.
Карты не от NVIDIA
Дискретные Radeon и Intel Arc выглядят в перечислении бэкендов сноской, а на деле определяют, какие слои экосистемы вообще доступны. llama.cpp доступен всегда: HIP/ROCm и Vulkan для AMD, SYCL и Vulkan для Intel («llama.cpp based on SYCL is used to support Intel GPU (Data Center Max series, Flex series, Arc series, Built-in GPU and iGPU)»). Вместе с ним доступен и весь GGUF — то есть подавляющее большинство опубликованных квантов.
Серверный слой доступен уже не весь и не сразу. vLLM собирается под ROCm и называет поимённо не только ускорители Instinct, но и потребительские карты: «MI200s (gfx90a), MI300 (gfx942), MI350 (gfx950), Radeon RX 7900 series (gfx1100/1101), Radeon RX 9000 series (gfx1200/1201), Ryzen AI MAX / AI 300 Series (gfx1151/1150)»; для Intel есть отдельный бэкенд XPU под Data Center GPU и Arc, о котором документация говорит осторожнее — «initially supports basic model inference and serving on Intel GPU platform». Практическая цена: сборка привязана к версии ROCm и обычно берётся готовым образом, а на только что вышедшую карту поддержка приходит не в день продаж. ExLlamaV3 — только NVIDIA, ROCm у него числится в списке нереализованного, так что формат EXL3 на Radeon недоступен в принципе.
Чего смена вендора не меняет — арифметики. Формула бюджета, размер кэша на токен, ступени объёма и цена выгрузки от марки карты не зависят: 24 ГБ на Radeon RX 7900 XTX открывают тот же класс моделей, что 24 ГБ на GeForce, и упирается всё так же в пропускную способность памяти. Меняется только список движков, отсюда и вердикт: на не-NVIDIA-карте по умолчанию берут llama.cpp, а vLLM — когда карта есть в списке поддержанных и нагрузка оправдывает возню со сборкой.
Что уже не стоит начинать
Hugging Face TGI, долго бывший стандартным ответом на вопрос «чем сервить», переведён в режим поддержки в декабре 2025, а 21 марта 2026 репозиторий архивирован и доступен только на чтение. Собственный README отправляет к vLLM, SGLang, llama.cpp и MLX. Новый проект на TGI начинать незачем; существующий — переносить.
Экосистема движется быстро, и это отдельная причина не строить статью вокруг списка имён: за год из четырёх названий в любом абзаце одно успевает измениться.
Чем платят за обёртку
Цена удобства — умолчания, которых не видно. Каноничный пример: Ollama по умолчанию использует контекстное окно в 4096 токенов независимо от того, что заявляет модель (документация: «By default, Ollama uses a context window size of 4096 tokens»; меняется через OLLAMA_CONTEXT_LENGTH, параметр num_ctx или запрос). Модель с заявленными 128 тысячами токенов в такой конфигурации молча теряет всё, что не поместилось, — и пользователь видит не ошибку, а деградацию качества на длинных входах. Второе умолчание того же рода: модель выгружается из памяти через пять минут простоя, и первый запрос после паузы включает повторную загрузку весов с диска.
Вердикт простой. Обёртка — правильный выбор, пока запрос один, машина одна и настройки устраивают; ровно в тот момент, когда появляется вопрос «а сколько у меня на самом деле контекста и куда ушла память», надо спускаться на слой движка. Обратный переход стоит дёшево, поэтому начинать с обёртки не ошибка.
Стратегии работы с памятью
Это центральный раздел, потому что именно здесь движки принимают несовместимые решения, и именно отсюда растут все жалобы вида «у меня не влезло» и «почему занята вся карта».
llama.cpp: занять столько, сколько нужно
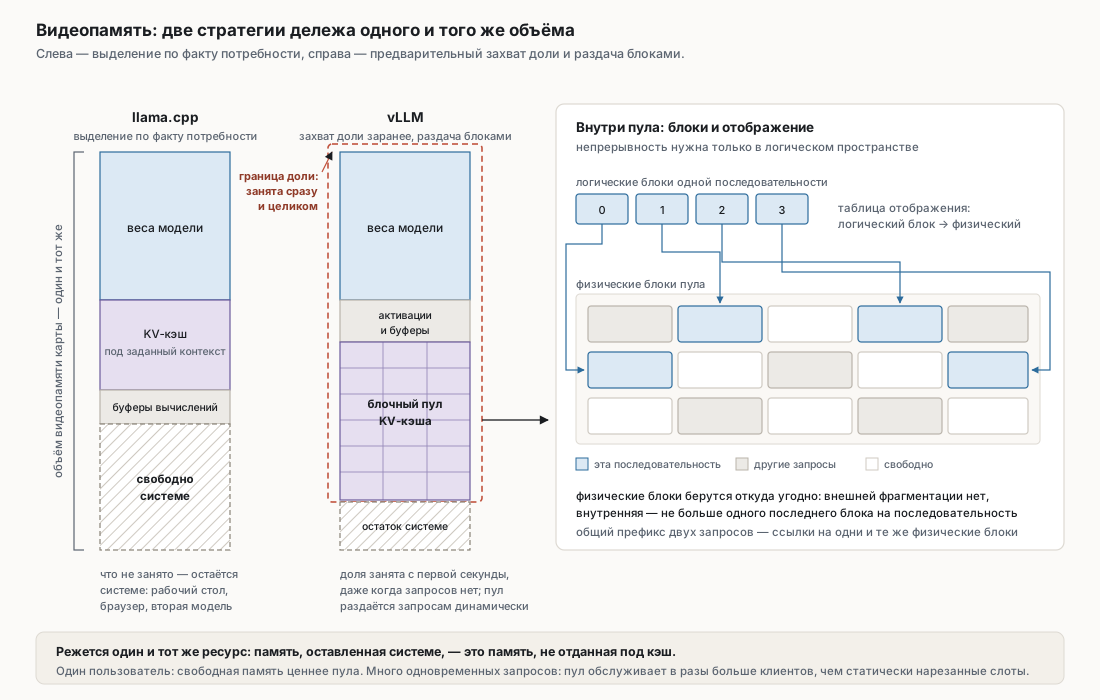
llama.cpp выделяет память консервативно: веса, буферы вычислений и KV-кэш под заданный контекст. Что не занято — остаётся системе, и на этой же карте спокойно живут рабочий стол, браузер и вторая модель. Для машины, которая одновременно и рабочая станция, такое поведение не мелочь, а главный аргумент.
Два умолчания здесь недавно изменились, и старое знание сбивает с толку. Во-первых, число слоёв на видеокарте больше не приходится подбирать руками: -ngl / --n-gpu-layers принимает auto и по умолчанию именно auto (выверялось по README сервера llama.cpp, сентябрь 2026, релиз v0.4.0). Во-вторых, KV-кэш сервера теперь единый на все слоты: --kv-unified описан как «use single unified KV buffer shared across all sequences (default: enabled if number of slots is auto)», а число слотов по умолчанию тоже auto. Раньше -c делился между слотами поровну, и запуск с -c 32768 --parallel 8 давал каждому клиенту по 4096 токенов — источник постоянного недоумения. В едином режиме -c задаёт общий бюджет пула, а ограничение на слот выставляется отдельно через --kv-unified-per-slot. То есть llama.cpp пришёл к тому же общему пулу, с которого начинал vLLM, — просто с другой стороны.
vLLM: занять всё заранее и раздавать страницами
vLLM устроен обратным образом. Параметр gpu_memory_utilization задаёт долю видеопамяти, которую движок считает своей; по документации стабильной ветки значение по умолчанию — 0,92 (а не 0,9, как в старых версиях и в половине статей в сети). Движок профилирует пиковое потребление на весах и активациях, а всё, что остаётся внутри выделенной доли, отдаёт под пул KV-кэша.
Посчитаем на карте в 24 ГБ с восьмимиллиардной моделью в четырёхбитном кванте: бюджет 0,92 × 24 ≈ 22 ГБ, из них около 4,6 ГБ занимают веса и порядка полутора гигабайт — активации, буферы CUDA-графов и рабочие области; под пул остаётся 16–17 ГБ. При 144 КиБ на токен это порядка 115 тысяч токенов кэша — например, двадцать одновременных запросов по 5–6 тысяч токенов. Ради этого пул и захватывается: память, розданная запросам динамически, обслуживает в разы больше клиентов, чем статически нарезанные слоты.
Плата за это — карта занята целиком, и nvidia-smi показывает 92 % расхода даже на простое. Оставшиеся 8 % — не запас под вторую модель, а место под контексты CUDA чужих процессов, вывод изображения и служебные буферы драйвера: на карте в 24 ГБ это меньше двух гигабайт, куда не влезет ничего крупнее модели эмбеддингов. На выделенной под инференс машине это правильное поведение; на рабочей станции оно означает, что ничего другого на карту уже не поставить, и понижать gpu_memory_utilization придётся вручную.
SGLang делает то же самое, но считает долю иначе: --mem-fraction-static — это доля памяти под статическое выделение, то есть под веса и пул KV вместе. Фиксированного умолчания у неё нет: если параметр не задан, доля вычисляется как «(GPU memory - reserved memory) / GPU memory», а 0,88 — запасное значение на случай, когда объём памяти определить не удалось. Разница в определении важна при переносе настроек между движками: одинаковые числа означают разное, а одинаковых чисел может и не оказаться.
PagedAttention как перенос страничной памяти
Идея, сделавшая пул возможным, описана в статье «Efficient Memory Management for Large Language Model Serving with PagedAttention» (SOSP 2023) и состоит в буквальном переносе страничной памяти на KV-кэш. До неё кэш выделялся непрерывным куском на максимальную длину последовательности: движок не знает заранее, сколько токенов сгенерирует запрос, поэтому резервирует по верхней границе. Профилирование авторов показало, что в существовавших системах «only 20.4 % — 38.2 % of the KV cache memory is used to store the actual token states», то есть от 60 до 80 % отведённой памяти уходило на внутреннюю фрагментацию и переразмеченный резерв.
PagedAttention режет кэш на блоки фиксированного размера (по умолчанию 16 токенов) и заводит таблицу отображения логических блоков последовательности в физические блоки пула. Дальше всё как в ядре ОС: непрерывность нужна только в логическом пространстве, физические блоки берутся откуда угодно, внутренняя фрагментация ограничена одним последним блоком на последовательность, внешней нет вовсе. Дополнительный эффект — разделение: два запроса с общим префиксом могут ссылаться на одни и те же физические блоки, ровно как два процесса на одну страницу после fork.
Аналогия продолжается и в неприятную сторону. Когда пул кончается, а запросы продолжают приходить, движок вытесняет часть запросов. Вариантов, как и в ОС, два: сохранить их кэш в память хоста и вернуть позже (swap) или выбросить и пересчитать prefill заново (recompute). В vLLM V1 умолчание — RECOMPUTE: «recomputation has lower overhead in the V1 architecture». Это тот же выбор, что между свопом и повторным чтением страницы из файла, и решается он тем же соображением — что дешевле, перекачать данные или получить их заново.
RadixAttention: общий префикс как разделяемая страница
SGLang развивает разделение до системного механизма. RadixAttention хранит кэш завершённых запросов не в куче на выброс, а в префиксном дереве (radix tree): при поступлении нового запроса рантайм ищет самый длинный совпадающий префикс и переиспользует его блоки, не считая prefill заново. Вытеснение — по LRU, планировщик учитывает попадания в кэш при выборе очередного запроса. Авторы SGLang заявляют до 6,4× выигрыша по пропускной способности на задачах со структурой — агентские циклы, few-shot, многораундовые диалоги, RAG.
Выигрыш появляется там, где префикс действительно общий, и его величина прямо равна доле сэкономленного prefill. Системный промпт на две тысячи токенов, повторяющийся в каждом запросе; многораундовый диалог, где вся история — префикс следующего хода; пакет запросов к одному большому документу — здесь экономия видна сразу. На потоке независимых коротких запросов без общего начала она равна нулю.
vLLM отвечает на то же самое автоматическим префиксным кэшированием: блоки хешируются по своим токенам и по префиксу перед ними, хеш с версии 0.11 — sha256. В V1 механизм включён по умолчанию, потому что накладные расходы удалось свести почти к нулю даже при нулевом проценте попаданий («near-zero performance degradation, even when the cache hit rate is 0 %»). Страница документации про APC местами ещё описывает старый порядок с явным флагом — это расхождение самой документации, а не двух режимов.
Вердикт
Одному пользователю на своей машине — llama.cpp или обёртка над ним: консервативное выделение оставляет машину пригодной для работы, а батчинг, ради которого написан vLLM, при одном запросе не даёт ничего. Как только запросов больше одного одновременно и карта отдана под инференс целиком — vLLM, и разница будет в разы, а не в процентах. SGLang стоит предпочесть vLLM тогда, когда в нагрузке есть устойчивый общий префикс: агенты, длинный системный промпт, диалоги. Между vLLM и SGLang на нагрузке без общих префиксов выбор близок к безразличному, и решать его стоит по поддержке нужной модели, а не по бенчмаркам.
Квантование
Что квантуется
Квантование заменяет 16-битные веса числами меньшей разрядности. Три вещи квантуются независимо, и путать их не стоит.
Веса — основной случай. Их квантуют почти всегда и почти всегда постфактум, без дообучения (post-training quantization): вес занимает меньше места, читается быстрее, и обе выгоды складываются, потому что decode упирается именно в чтение весов.
Активации — промежуточные значения, вычисляемые на лету. Их квантование (например, схемы W8A8 или FP8 на весах и активациях) даёт прирост за счёт вычислений в низкой точности на тензорных ядрах, но требует поддержки в железе и калибровки, а по качеству рискованнее: активации содержат выбросы, которые плохо переживают грубую сетку.
KV-кэш — отдельный рычаг, о нём ниже.
Ключевой приём во всех современных схемах один: квантуется не тензор целиком, а маленькие блоки, каждый со своим масштабом. Разброс значений внутри блока из 32 весов много меньше, чем по всему слою, поэтому одна и та же разрядность даёт заметно меньшую ошибку. Плата — масштаб надо хранить: он и создаёт разницу между номинальными «четырьмя битами» и фактическими 4,25–4,5 бита на вес.
Форматы
| Формат | Бит на вес | Где живёт | Чем интересен |
|---|---|---|---|
| Q8_0 | ≈8,5 | GGUF | практически без потерь, но и без выигрыша по качеству на байт |
| Q6_K | 6,5625 | GGUF | потери на уровне шума измерений |
| Q5_K | 5,5 | GGUF | компромисс, когда памяти чуть больше нужного |
| Q4_K | 4,5 | GGUF | рабочая лошадь: суперблоки по 8 блоков, масштаб и минимум по 6 бит |
| IQ4_XS | 4,25 | GGUF | те же четыре бита, но с матрицей важности при квантовании |
| MXFP4 | 4,25 | GGUF, HF | стандарт OCP: элементы E2M1, блок 32, общий масштаб E8M0 |
| Q3_K | 3,4375 | GGUF | заметная деградация, оправдана только нехваткой памяти |
| Q2_K | 2,625 | GGUF | последнее средство |
| GPTQ | 3–4 | HF | послойное квантование по приближённой матрице Гессе |
| AWQ | 4 | HF | защищает ~1 % значимых каналов, выбирая их по активациям |
| FP8 (E4M3/E5M2) | 8 | HF | формат для тензорных ядер, а не для экономии места |
| EXL3 | 2–8, настраивается | ExLlamaV3 | вариант QTIP, работает от 1,6 бит на 70B-моделях |
Различие между семействами полезно понимать по назначению, а не по цифрам. GGUF и его K-кванты — это формат для движка, который может считать на чём угодно, включая процессор: квантование сделано так, чтобы обратное преобразование было дешёвым в скалярном коде. AWQ и GPTQ — форматы для GPU-серверов, где важно, чтобы вес разворачивался в регистрах тензорного ядра. FP8 стоит особняком: восемь бит — это не про экономию, а про то, что у современных ускорителей тензорные ядра умеют считать в FP8 нативно, поэтому выигрыш идёт от вычислений и вдвое меньшего трафика, а не от размера. MXFP4 — попытка стандартизовать блочную схему на уровне индустрии, и её появление в GGUF рядом с K-квантами наглядно показывает, что llama.cpp пришёл к той же идее на пару лет раньше стандарта.
Отдельно стоит отметить, что квантование всё чаще перестаёт быть посторонним действием над чужими весами: gpt-oss-20b публикуется с quantization_config вида mxfp4 прямо в конфигурации, причём внимание, маршрутизатор и эмбеддинги из квантования исключены. Это правильная практика — квантовать имеет смысл то, что составляет массу весов, а не то, что чувствительно и мало.
Как измерять деградацию
Стандартный индикатор — перплексия на корпусе: насколько хорошо модель предсказывает следующий токен. Он дёшев, воспроизводим и годится для сравнения квантов одной и той же модели между собой. Ограничение у него принципиальное: перплексия — среднее по огромному числу токенов, а деградация от квантования концентрируется в редких, но важных местах. Модель может сохранить перплексию с точностью до третьего знака и при этом развалиться на длинных цепочках рассуждений, на строгом следовании формату вывода или на редких языках.
Работа «Accuracy is Not All You Need» (2024) показывает это количественно: даже при совпадающей точности на бенчмарках сжатая модель даёт «flips» — ответы, меняющиеся с верного на неверный и обратно, — и её поведение для пользователя заметно отличается от исходной. Авторы предлагают мерить расстояние между распределениями: KL-дивергенцию и долю flips. Практический вывод — сравнивать не абсолютные метрики, а расхождение с неквантованной моделью: в llama.cpp для этого есть llama-perplexity --kl-divergence, где сначала снимается база логитов с FP16-модели, а потом считается расхождение квантованной («a measure of how similar the FP16 and the quantized logit distributions are with a value of 0 indicating that the distribution are the same»).
Практический порядок такой. Q6_K и выше — можно не проверять. Q4_K — проверять на своей задаче, потому что здесь начинается область, где разница видна. Три бита и ниже — проверять обязательно и ожидать, что на задачах со строгим форматом вывода или длинными рассуждениями модель посыплется раньше, чем это покажет перплексия.
Правило соотношения
Формулировка, которую стоит держать в голове: при равном бюджете памяти большая модель в сильном кванте обычно лучше меньшей в слабом. Это не фольклор — это вывод работы «The case for 4-bit precision: k-bit Inference Scaling Laws» (Dettmers, Zettlemoyer, 2022–2023), где на более чем 35 000 экспериментов в диапазоне 3–8 бит и 19M–176B параметров четырёхбитная точность оказалась почти всюду оптимальной по соотношению «качество на бит». Практически: 30B в Q4 (около 17 ГБ) предпочтительнее 14B в Q8 (около 16 ГБ), а спуск ниже четырёх бит оправдан только тем, что альтернатива — не влезть вовсе.
У правила есть существенная оговорка, и она свежее самого правила. Работа «Scaling Laws for Precision» (2024) обнаруживает, что деградация от послетренировочного квантования растёт с объёмом данных, на которых модель обучалась: чем дольше обучали, тем хуже модель квантуется, вплоть до того, что дополнительные данные предобучения становятся вредны для последующего сжатия. Современные модели обучаются на порядки большем числе токенов на параметр, чем те, на которых калибровались законы 2022 года, поэтому нижняя граница разумной разрядности со временем ползёт вверх, а не вниз. Выводы этой работы, надо честно сказать, подтверждены на моделях до 1,7 млрд параметров и 26 млрд токенов — экстраполяция на нынешние размеры остаётся экстраполяцией.
Вердикт: по умолчанию брать четырёхбитный квант самой большой модели, которая влезает вместе с нужным контекстом; проверять на своей задаче; на моделях свежих поколений при возможности предпочитать 5–6 бит четырём.
Квантование KV-кэша
Кэш квантуется независимо от весов и часто оказывается более выгодным рычагом, потому что на длинном контексте именно он определяет, влезет ли задача.
В llama.cpp это --cache-type-k и --cache-type-v (по умолчанию f16, из допустимых — q8_0, q5_1, q4_0, iq4_nl и другие). Переход с f16 на q8_0 сокращает кэш примерно вдвое, на q4_0 — примерно в три с половиной раза. В vLLM это --kv-cache-dtype fp8 (варианты fp8_e4m3, fp8_e5m2), дающий ровно двукратную экономию; документация предупреждает, что «some attention layer types (e.g. sliding-window) are more sensitive to KV-cache quantization» и для лучшей точности рекомендует калибровать масштабы, а не полагаться на умолчания.
Порядок предпочтений при нехватке памяти на длинный контекст такой: сначала восьмибитный кэш (потери обычно ниже порога заметности), потом более сильный квант весов, и только потом четырёхбитный кэш. Причина в асимметрии: ошибка в весах вносится один раз и одинаково для всех токенов, ошибка в кэше накапливается по мере роста контекста и бьёт по способности модели точно вспоминать то, что было в начале, — то есть ровно по тому, ради чего длинный контекст и нужен.
Расчёт бюджета памяти
Формула
память = веса + KV-кэш(контекст × параллельные запросы) + активации и буферы

веса   = параметры × бит на вес / 8
KV     = 2 × слоёв × KV-голов × размер головы × байт на элемент × токенов
буферы = 1–2 ГБ на движок, CUDA-графы, промежуточные тензоры
Числа для слоёв, голов и размера головы берутся из config.json модели — это не оценка, а арифметика, и сходится она с точностью до нескольких процентов. Оставшийся член, «активации и буферы», зависит от движка и размера батча; на потребительских картах разумно закладывать 1–2 ГБ и проверять по факту.
Ступени объёма
Ступени ниже посчитаны по той же формуле для четырёхбитных весов, fp16-кэша и гигабайта буферов; KV-кэш взят по типичной GQA-геометрии каждого класса: 144 КиБ на токен у 8B, 160 КиБ у 14B, 96 КиБ у 30B-MoE, 256 КиБ у 30B-dense, 320 КиБ у 70B. «Тесно» означает, что пара «модель плюс контекст» влезает впритык: остатка не хватит ни на второй процесс, ни на заметное удлинение контекста. Числа округлены, и конкретная модель может отличаться на десяток процентов в любую сторону — считать надо по её config.json.
| Видеопамять | Что помещается свободно | Что тесно | Где разрыв |
|---|---|---|---|
| 8 ГБ | 4B с 16k, 8B с 8k | 8B с 16k | 8B в Q4 — это 4,6 ГБ, и половина карты уже занята |
| 12 ГБ | 8B с 32k | 14B с 8k | появляется запас на кэш, но не на следующий класс модели |
| 16 ГБ | 8B в Q8 с 32k, 14B с 16k | 14B с 32k; 30B-MoE только с выгрузкой экспертов | 30B-dense не влезает никак |
| 24 ГБ | 30B-MoE в Q4 с 32k, 14B на весь свой контекст | 30B-dense в Q4 с 16k | первая ступень, где vLLM имеет смысл: пул на 16–17 ГБ |
| 32 ГБ | 30B-MoE с 64k, 30B-dense с 32k | 30B-MoE со 128k | промежуточная ступень, нового класса не открывает |
| 48 ГБ | 30B в Q8 с 32k, 70B в Q4 с 8k | 70B в Q4 с 16k | 70B в Q4 — это ~40 ГБ, кэш почти некуда положить |
| 96 ГБ | 70B в Q4 со 128k или в Q6 с 32k, 120B-MoE в MXFP4 | 70B в Q8 с 64k | верх одиночной карты |
| 128+ ГБ единой памяти | 120B-MoE с длинным контекстом | плотные модели больше 70B | упирается уже не в объём, а в пропускную способность |
Практический вывод из таблицы важнее самой таблицы. Разрывы проходят не там, где кончается ровное число гигабайт, а там, где перестаёт помещаться очередной класс моделей: 4,6 ГБ (8B), 9 ГБ (14B), 17–18 ГБ (30B), 40 ГБ (70B), 60 ГБ (120B-MoE в четырёхбитном формате). Добавка памяти, не переводящая через ближайшую границу, покупает только контекст — иногда это именно то, что нужно, но это другая покупка.
Выгрузка на процессор и её цена
Когда модель не помещается целиком, часть слоёв кладут в оперативную память и считают на процессоре. Цену даёт закрытая формула — это арифметика по паспортным пропускным способностям, а не результат замеров. Пусть r — отношение пропускной способности видеопамяти к пропускной способности системной памяти, а f — доля весов, оставшаяся в оперативной памяти. Тогда время на токен растёт примерно как
замедление ≈ 1 + (r − 1) × f
потому что каждая часть весов читается со своей скоростью, а времена складываются. Значение r стоит привязывать к конкретной паре чисел, потому что разброс у него больше, чем кажется: карта с памятью около 1 ТБ/с против двухканальной DDR5-6400 (102,4 ГБ/с) даёт r ≈ 10, а RTX PRO 6000 Blackwell с её 1792 ГБ/с против той же DDR5 — уже r ≈ 17,5. При r = 10 выгрузка 5 % весов стоит 1,45× времени, четверти — 3,25×, половины — 5,5×; при r = 17,5 те же доли стоят 1,8×, 5,1× и 9,3×, то есть чем быстрее карта, тем дороже обходится каждый выгруженный процент. Отсюда два практических следствия. Первое: «чуть-чуть не влезло» — это не катастрофа, потерять треть скорости ради того, чтобы взять модель классом выше, часто выгодно. Второе: выгрузка половины модели превращает видеокарту в дорогой ускоритель prefill, и на этом рубеже честнее сравнивать с чистым CPU-инференсом, а не с GPU.
Формула описывает выгрузку одного определённого вида — ту, где выгруженные слои процессором и считаются, как в llama.cpp. Через PCIe при этом ходят только активации между слоями, единицы-десятки килобайт на токен, и шина действительно не узкое место: расхожее объяснение «всё упирается в PCIe» к этому механизму не относится. Зато формула недооценивает prefill на процессорной части — это фаза, упирающаяся в вычисления, а не в память, и процессор в ней проигрывает видеокарте больше, чем в отношении пропускных способностей.
Второй механизм устроен наоборот, и объяснение про шину для него верно. Веса лежат в оперативной памяти, но считает их всё равно видеокарта, поэтому на каждый проход они переливаются в неё через PCIe. Так работает --cpu-offload-gb в vLLM, и документация говорит об этом прямым текстом: «this requires fast CPU-GPU interconnect, as part of the model is loaded from CPU memory to GPU memory on the fly in each model forward pass». Формула годится и здесь, только r в ней — отношение пропускной способности видеопамяти к пропускной способности шины: PCIe 4.0 x16 даёт около 32 ГБ/с в одну сторону, втрое меньше двухканальной DDR5, так что выгружать этим способом имеет смысл проценты весов, а не десятки процентов.
Отдельный случай — модели MoE, для которых в llama.cpp есть --n-cpu-moe N: «keep the Mixture of Experts (MoE) weights of the first N layers in the CPU». Приём работает потому, что у MoE веса экспертов составляют основную массу модели, но на каждый токен читается лишь малая их часть: маршрутизатор выбирает несколько экспертов и остальные не трогает. Внимание, маршрутизатор и общие слои при этом остаются на видеокарте, где от них больше пользы. Для 30B-MoE на карте в 16 ГБ это разница между «не запускается» и «работает с приемлемой скоростью», тогда как для плотной модели такой возможности нет в принципе.
Инференс целиком на процессоре
Осмыслен чаще, чем принято думать, и по той же арифметике: если задача упирается в пропускную способность памяти, то процессор с восьмиканальной DDR5 отстаёт от видеокарты не в сто раз, а во столько, во сколько отличаются пропускные способности. Двухканальный десктоп даёт около 100 ГБ/с и потому годится для моделей до 8B и для MoE; серверная платформа с восемью-двенадцатью каналами даёт 300–600 ГБ/с и приближается к младшим дискретным картам, зато позволяет поставить столько памяти, сколько на видеокарте не бывает.
Что при этом остаётся плохим: prefill. Обработка длинного промпта — вычислительная задача, и здесь процессор проигрывает по-настоящему. Гибрид «prefill на карте, decode на процессоре» звучит логично, но так движки не устроены: модель они делят по слоям, а не по фазам. Разнесение фаз существует (disaggregated serving в серверных движках), однако это распределение между ускорителями, а не передача decode процессору.
Несколько карт
Два способа разложить модель по картам различаются тем, что ходит по шине.
Послойное разделение (llama.cpp --split-mode layer, конвейерный параллелизм в серверных движках) отдаёт каждой карте свои слои. Между картами передаются только активации — килобайты на токен, — поэтому шина не важна, работает даже на PCIe x4. Плата: в каждый момент считает одна карта, остальные ждут. Суммарная пропускная способность памяти не складывается, скорость одного запроса не растёт; растёт только доступный объём.
Тензорный параллелизм режет каждый слой между картами по измерению матрицы. Все карты считают одновременно, пропускная способность складывается, скорость одного запроса действительно растёт. Плата: после каждого слоя нужна коллективная операция сведения, то есть обмен на каждый слой и на каждый токен, и здесь скорость межсоединения решает всё. Документация vLLM формулирует это прямо: тензорный параллелизм — внутри узла, конвейерный — между узлами, а «if the GPUs on the node do not have NVLINK interconnect (e.g. L40S), leverage pipeline parallelism instead of tensor parallelism for higher throughput and lower communication overhead».
Вердикт: две потребительские карты в обычных слотах PCIe — это плюс объём и почти ничего сверх того; рассчитывать на удвоение скорости от тензорного параллелизма без NVLink не стоит. Если цель — объём (запустить модель, которая не влезает), берите послойное разделение и не думайте про шину. Если цель — скорость одного запроса, нужен быстрый межсоединитель, и это уже другой класс оборудования.
Единая память: Apple, APU и коробки для инференса
Отдельный класс машин, где процессор и ускоритель делят одну физическую память. Он интересен тем, что переворачивает привычный компромисс: объём перестаёт быть дефицитом, а дефицитом становится пропускная способность.
Числа из спецификаций производителей показывают вилку. Apple M5 Pro — до 64 ГБ единой памяти при 307 ГБ/с, M5 Max — до 128 ГБ при 614 ГБ/с, M5 Ultra — до 512 ГБ при 1,2 ТБ/с. NVIDIA DGX Spark — 128 ГБ LPDDR5x при 273 ГБ/с. AMD Ryzen AI Max+ 395 — до 128 ГБ, из которых до 96 ГБ можно отдать под видеопамять через Variable Graphics Memory. Для сравнения: дискретная NVIDIA RTX PRO 6000 Blackwell — 96 ГБ при 1792 ГБ/с. То есть единая память даёт объём дискретной карты верхнего уровня при пропускной способности в три-шесть раз меньшей.
Отсюда прямое следствие: на таких машинах выигрывают MoE-модели. Плотная модель на 70B в четырёхбитном кванте на 273 ГБ/с упрётся в потолок около 7 токенов в секунду, а MoE сопоставимого размера с активными 5–10 % весов — в десятки. Продавцы этих машин обещают «модели на 200 миллиардов параметров», и обещание корректно по объёму, но по скорости оно верно только для разреженных архитектур.
Границы, до которых память достаётся ускорителю, задаются операционной системой и в этом смысле это чистая задача управления памятью.
На macOS предел выражен свойством recommendedMaxWorkingSetSize у устройства Metal; llama.cpp печатает его при старте. Доля от общего объёма, которую система отдаёт по умолчанию, Apple не документирует; в сообществе она оценивается примерно в 70–75 % и, судя по отчётам, зависит от объёма памяти машины, а поднимается тюнаблом iogpu.wired_limit_mb (sudo sysctl iogpu.wired_limit_mb=<МБ>). Ни доля, ни тюнабл в документации Apple не описаны: единственное, на что тут можно опереться, — обсуждение #2182 в llama.cpp, где этот приём и разошёлся. Здесь он не воспроизводился, поэтому относиться к нему стоит как к неподтверждённому факту, а ориентироваться — на число, которое печатает сам движок при старте: оно и есть действующий предел.
На Linux с APU AMD память ускорителю выдаётся через GTT — обычные страницы системной памяти, отображённые для GPU. Размер задаётся не BIOS, а ядром: параметр модуля amdgpu.gttsize документирован как «Restrict the size of GTT domain (for userspace use) in MiB for testing. The default is -1 (Use value specified by TTM). This parameter is deprecated and will be removed in the future», то есть реальный предел определяется подсистемой TTM. Её собственный параметр — ttm.pages_limit, объявленный в drivers/gpu/drm/ttm/ttm_tt.c как «Limit for the allocated pages» и считающий страницы, а не мегабайты; текущее значение видно в /sys/module/ttm/parameters/pages_limit. Если параметр не задан, TTM при инициализации устройства ставит его примерно в половину оперативной памяти («Limit the number of pages in the pool to about 50% of the total system memory» в ttm_device.c). Сам gttsize доживает своё. Практический смысл тот же, что у любого лимита ядра: увидеть текущее значение, изменить параметром загрузки, проверить. Про то, как параметры модулей задаются и где смотрятся, — Ядро: сборка, модули, параметры.
Эксплуатация
Пропускная способность против задержки
Батчинг — это обмен задержки на пропускную способность, и понимать надо, что именно меняется. Статический батчинг (собрать N запросов, посчитать, отдать) для генерации почти бесполезен: запросы заканчиваются в разное время, и короткий ответ ждёт самого длинного в батче. Ответ на это — итерационное планирование, предложенное в Orca (OSDI 2022): планировщик работает на гранулярности одной итерации, а не запроса, так что завершившийся запрос уходит немедленно, а пришедший подхватывается на следующем шаге. Это и есть continuous batching, и сегодня он включён по умолчанию везде, включая llama-server (--cont-batching, «default: enabled»).
Второй механизм — chunked prefill из Sarathi: длинный промпт режется на куски, и в тот же батч подсаживаются запросы на decode. Вычислители заняты префилл-куском, decode едет попутно почти бесплатно. В vLLM V1 chunked prefill включён по умолчанию, а планировщик вообще не различает фазы, оперируя бюджетом токенов на итерацию.
Что оптимизировать — зависит от того, кто ждёт. Интерактивная работа: минимизировать время до первого токена и держать межтокенную задержку ниже скорости чтения (грубый ориентир — около 10 токенов в секунду; дальше прирост почти не ощущается). Пакетная обработка: максимизировать суммарные токены в секунду, задирая размер батча и длину префилл-кусков, — задержка отдельного запроса не важна вовсе. Практическая ошибка, которую стоит назвать: настраивать сервер по суммарной пропускной способности, когда за ним сидит один человек. Все настройки, увеличивающие суммарную цифру, увеличивают и задержку одного запроса.
Что мерить
Четыре величины, и путать их не надо. Время до первого токена (TTFT) — от отправки запроса до первого полученного токена; отражает prefill и очередь. Межтокенная задержка (ITL, она же TPOT) — среднее время между соседними токенами, считается как (общее время − TTFT) / (число выходных токенов − 1); отражает decode. Пропускная способность по запросам — сколько запросов в секунду система доводит до конца. Суммарная пропускная способность по токенам — сколько выходных токенов в секунду выдаётся по всем одновременным запросам.
Ключевое: последние две растут с батчем, первые две от батча ухудшаются. Один график «токенов в секунду» без указания, чей это счёт — одного запроса или всей системы — не значит ничего, и именно на этой двусмысленности строится половина сравнений движков в сети.
Минимальный честный замер локально:
# скорость prefill и decode отдельно, без сервера и клиента в измерении
llama-bench -m model.gguf -p 2048 -n 128

# нагрузочный профиль с распределением TTFT и ITL по перцентилям
vllm bench serve --model <модель> --num-prompts 200 --request-rate 4
Форматы хранения весов
Три формата встречаются на практике, и различие между ними в первую очередь про безопасность, а не про удобство.
.bin/.pt — сериализация PyTorch поверх pickle. Документация Python говорит прямо: «The pickle module is not secure. Only unpickle data you trust. It is possible to construct malicious pickle data which will execute arbitrary code during unpickling». Загрузка такого файла из интернета — это исполнение чужого кода, а не чтение данных. В PyTorch 2.6 умолчание torch.load переключили на weights_only=True, что закрывает основную дыру ценой поломки части старых чекпоинтов; на более старых версиях защиты нет.
.safetensors — формат ровно для того, чтобы этой проблемы не было: заголовок в JSON плюс сырые тензоры, никакого исполняемого содержимого, плюс чтение без копирования и загрузка части тензоров. Это дефолт для весов на Hugging Face и правильный выбор для всего, что берётся извне.
.gguf — формат llama.cpp: тензоры и стандартизованный набор метаданных в одном файле, включая архитектуру, токенизатор и шаблон чата. Именно самодостаточность делает GGUF удобным для распространения: одного файла хватает, чтобы запустить модель, тогда как для safetensors нужна ещё папка с конфигурацией и токенизатором.
Вердикт: брать safetensors или GGUF, pickle-форматы не загружать из недоверенных источников даже на PyTorch 2.6+.
OpenAI-совместимый эндпоинт
Де-факто стандарт интеграции сложился сам: HTTP-эндпоинт с путями /v1/chat/completions, /v1/completions, /v1/embeddings, /v1/models реализуют llama.cpp (llama-server), vLLM, SGLang, LMDeploy, TensorRT-LLM (trtllm-serve), Ollama и Jan. Практическая ценность в том, что движок становится заменяемой деталью: клиент, написанный под этот интерфейс, переключается с локальной модели на облачную сменой базового URL и ключа.
# один и тот же запрос к любому из движков
curl -s http://localhost:8080/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"local","messages":[{"role":"user","content":"привет"}],"stream":true}'
Совместимость не полная, и расхождения предсказуемы: разные наборы поддерживаемых параметров сэмплирования, разное поведение при превышении контекста, разная поддержка вызова инструментов и структурированного вывода. Проверять стоит именно эти три места.
Контекстное окно: заявленное и используемое
Заявленная длина контекста — верхняя граница, при которой модель технически не откажется работать. Насколько она используема — отдельный вопрос, и ответ на него измерялся: бенчмарк RULER показал, что при заявленных 32 тысячах токенов и больше «only half of them can maintain satisfactory performance at the length of 32K», причём деградация видна на задачах сложнее, чем поиск иголки в стоге сена, — на многошаговом связывании и агрегации. Замер сделан в 2024 году на моделях того поколения, и переносить его цифры на нынешние модели нельзя; переносить стоит сам вывод — заявленную длину нужно проверять на своей задаче, а не принимать на веру.
К этому добавляется цена памяти (12 ГиБ кэша на 128 тысяч токенов у 30B-модели из примера выше) и цена времени: prefill растёт с длиной промпта, и на очень длинных входах время до первого токена измеряется десятками секунд. Отсюда практический подход: ставить контекст по фактической потребности, а не по паспорту модели, и на длинных документах предпочитать выборку нужных фрагментов запихиванию всего документа целиком. Если длинный общий префикс всё же неизбежен, его надо сделать действительно общим — тогда его подхватит префиксное кэширование и заплатить за prefill придётся один раз.
Нюансы и trade-off'ы
Локально или через API
| Ось | Локально | Облачный API |
|---|---|---|
| Стоимость | капитальная: железо и электричество независимо от загрузки | операционная: платишь за токены, простой бесплатен |
| Приватность | данные не покидают машину | данные уходят провайдеру, гарантии договорные |
| Задержка | нет сети; TTFT определяется своим железом | сеть плюс очередь, зато prefill на серверных ускорителях |
| Потолок качества | ограничен тем, что влезло в память | лучшие доступные модели |
| Предсказуемость | версия модели меняется, только когда вы её меняете | модель за именем может измениться без вашего участия |
| Доступность | зависит от одной машины | зависит от чужого SLA и лимитов |
Честный вердикт: по деньгам локальный инференс окупается только при высокой и постоянной загрузке — редкие запросы через API почти всегда дешевле, чем амортизация карты. Настоящие аргументы за локальный запуск — приватность, независимость от чужих решений (модель не устареет и не исчезнет по чужому расписанию) и возможность работать без сети. Разрыв в качестве между лучшими открытыми весами и лучшими закрытыми моделями обычно есть, хотя его величина меняется от поколения к поколению и здесь не измерялась; вопрос в том, достаточно ли открытых для конкретной задачи, а для суммаризации, извлечения структуры, классификации и черновиков кода — обычно достаточно.
Смешанная схема разумнее любой чистой: локальная модель как обработчик по умолчанию, облачная — для того, что локальная не тянет. Общий OpenAI-совместимый интерфейс делает такое переключение вопросом конфигурации.
Лицензии весов
«Открытая модель» — не то же самое, что открытый исходный код, и разброс здесь больше, чем в софте.
Часть весов выходит под обычными лицензиями свободного ПО — Apache 2.0 и MIT (так публикуются, в частности, gpt-oss и модели семейства Qwen). Здесь ограничений на использование нет.
Часть — под собственными лицензиями с содержательными ограничениями. Llama Community License требует запросить отдельную лицензию у Meta, если у продукта на дату релиза версии «greater than 700 million monthly active users», обязывает «prominently display “Built with Llama”» и включает по ссылке Acceptable Use Policy. Условия Gemma требуют передавать ограничения по цепочке: «You must include the use restrictions referenced in Section 3.2 as an enforceable provision in any agreement governing the use and/or distribution of Gemma or Model Derivatives».
Практический вывод: для персонального использования разница между этими лицензиями почти нулевая, для продукта — существенная, и особенно неприятны условия, которые надо тащить дальше по цепочке распространения. Проверять лицензию нужно на карточке конкретных весов, а не по названию семейства: дообученные версии и кванты наследуют условия оригинала, а иногда добавляют свои.
Что здесь устареет первым
Полезно знать заранее, какие утверждения статьи имеют короткий срок годности. Быстрее всего устаревают имена и статусы проектов: TGI прошёл путь от стандарта до архива за полтора года. Следом — умолчания движков: gpu_memory_utilization уже переезжал с 0,9 на 0,92, -ngl стал auto, KV-кэш в llama-server стал единым; каждое такое изменение делает неверными советы из сети, а не только из этой статьи. Затем — числа железа: объёмы и пропускные способности растут, и конкретные модели карт в разделе про ступени приведены как якоря арифметики, а не как рекомендация к покупке.
Медленнее всего меняются собственно механизмы: разделение prefill и decode, линейный рост KV-кэша, блочное управление памятью, переиспользование префикса, компромисс «резервировать или отдавать по требованию». Ради них статья и написана, и именно они позволяют разобраться в новом движке за полчаса, а не за неделю.
Источники
- Kwon et al. Efficient Memory Management for Large Language Model Serving with PagedAttention, SOSP 2023 — PagedAttention, блок в 16 токенов, доля полезно используемой памяти кэша 20,4–38,2 % в системах без пула
- Zheng et al. SGLang: Efficient Execution of Structured Language Model Programs и блог LMSYS о RadixAttention — префиксное дерево, LRU-вытеснение, до 6,4× пропускной способности
- Yu et al. Orca: A Distributed Serving System for Transformer-Based Generative Models, OSDI 2022 — итерационное планирование, непрерывный батчинг
- Agrawal et al. SARATHI: Efficient LLM Inference by Piggybacking Decodes with Chunked Prefills — prefill насыщает вычислители, decode их недогружает; chunked prefill
- Ainslie et al. GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints — сокращение числа KV-голов
- Dettmers, Zettlemoyer. The case for 4-bit precision: k-bit Inference Scaling Laws — четыре бита как оптимум по качеству на бит в диапазоне 3–8 бит
- Kumar et al. Scaling Laws for Precision — деградация от послетренировочного квантования растёт с объёмом обучающих данных; валидация до 1,7B параметров
- Dutta et al. Accuracy is Not All You Need — flips и KL-дивергенция вместо точности при оценке сжатия
- Hsieh et al. RULER: What's the Real Context Size of Your Long-Context Language Models? — заявленный контекст против используемого
- Micikevicius et al. FP8 Formats for Deep Learning — E4M3 и E5M2
- OCP Microscaling Formats (MX) Specification v1.0 и Microscaling Data Formats for Deep Learning — MXFP4: элементы E2M1, блок 32, общий масштаб E8M0
- Hugging Face: GGUF и таблица типов квантования — биты на вес для K-квантов и IQ-квантов
- llama.cpp: README HTTP-сервера — умолчания
-ngl auto,--kv-unified,--cache-type-k f16,--cont-batching,--n-cpu-moe, список OpenAI-совместимых эндпоинтов - llama.cpp: PR #24124,
--kv-unified-per-slot— ограничение контекста на слот при общем пуле - llama.cpp: спекулятивное декодирование —
-md,--spec-draft-n-maxпо умолчанию 3,--spec-typeс вариантами по n-граммам - llama.cpp: сборка и бэкенды — CUDA, HIP/ROCm, Vulkan, SYCL для Intel GPU, Metal
- llama.cpp: обсуждение #2182 о разделе памяти на Apple silicon —
sysctl iogpu.wired_limit_mb, оценки доли памяти по сообщениям пользователей - llama.cpp: инструмент perplexity —
--kl-divergenceи сравнение распределений с FP16 - vLLM: аргументы движка —
gpu_memory_utilizationпо умолчанию 0,92,--kv-cache-dtype,--cpu-offload-gbс оговоркой про быстрое межсоединение CPU и GPU - vLLM: спекулятивное декодирование — черновая модель, n-граммы, EAGLE и MTP, выигрыш при низком потоке запросов, сохранение распределения выхода
- vLLM: установка на GPU — перечень поддержанных ROCm-карт и бэкенд XPU для Intel
- vLLM: оптимизация и тюнинг — режим вытеснения
RECOMPUTEв V1, chunked prefill по умолчанию - vLLM: анонс V1 — префиксное кэширование включено по умолчанию, единый планировщик без разделения фаз
- vLLM: устройство префиксного кэширования — хеширование блоков, sha256 с версии 0.11
- vLLM: квантование KV-кэша —
fp8_e4m3,fp8_e5m2, чувствительность скользящего окна - vLLM: параллелизм и масштабирование — тензорный параллелизм внутри узла, конвейерный между узлами и без NVLink
- SGLang: аргументы сервера —
--mem-fraction-staticкак доля под веса и пул вместе, вычисляемое умолчание и 0,88 как запасное значение - TensorRT-LLM: release notes — в 1.2 удалён бэкенд TensorRT, PyTorch остался единственным
- Hugging Face TGI — режим поддержки с декабря 2025, архивация 21 марта 2026, рекомендованные замены
- Ollama: FAQ — контекст 4096 токенов по умолчанию, выгрузка модели через 5 минут
- Ollama: релизы — 0.33.3 от 2 сентября 2026, обновления llama.cpp и MLX, мультимодальность на MLX-движке
- LM Studio: free for use at work — с июля 2025 отдельная лицензия для работы не нужна
- Jan — llama.cpp в основе («built on the shoulders of giants»)
- ExLlamaV3 — формат EXL3 как вариант QTIP, 1,6 бит на 70B, ROCm числится в списке нереализованного
- MLX: единая память — массивы в общей памяти, устройство выбирается для операции
- Apple Newsroom: Mac Studio с M5 Max и M5 Ultra и MacBook Pro с M5 Pro и M5 Max — объёмы и пропускная способность единой памяти
- NVIDIA DGX Spark — 128 ГБ LPDDR5x, 273 ГБ/с
- NVIDIA RTX PRO 6000 Blackwell — 96 ГБ GDDR7, 1792 ГБ/с
- AMD: Ryzen AI Max+ 395 — до 128 ГБ единой памяти, до 96 ГБ под Variable Graphics Memory
- Документация ядра Linux: параметры модуля amdgpu —
gttsize, умолчание −1, пометка о признании устаревшим - Исходники TTM:
ttm_tt.c— параметрpages_limitи его описание,ttm_device.c— умолчание в половину оперативной памяти - Metal: recommendedMaxWorkingSetSize — документированный предел рабочего набора GPU на Apple silicon
- Python: модуль pickle — предупреждение о произвольном исполнении кода
- PyTorch 2.6 release blog —
torch.loadпо умолчанию сweights_only=True - safetensors — формат без исполняемого содержимого, чтение без копирования
- Llama 4 Community License и условия использования Gemma — порог 700 млн активных пользователей, «Built with Llama», передача ограничений по цепочке
- NVIDIA: метрики бенчмаркинга LLM — определения TTFT, ITL/TPOT и двух видов пропускной способности
- Конфигурации моделей, по которым считались примеры: Qwen3-8B, Qwen3-14B, Qwen3-32B, Qwen3-30B-A3B-Instruct-2507, gpt-oss-20b; геометрия 70B взята по Llama-3.1-70B-Instruct (зеркало без гейта: 80 слоёв, 8 KV-голов, размер головы 128)
Связанные заметки
- Linux — ядро: сборка, модули, параметры — параметры модулей и загрузки, которыми задаются лимиты памяти для GPU и APU
- Linux — контейнеризация — движки инференса чаще всего запускают в контейнере с проброшенным устройством
- SATA, SAS и NVMe — веса весят десятки гигабайт и читаются с диска при каждой загрузке модели
- yt-dlp: извлечение субтитров и подготовка текста для LLM — откуда берётся длинный текст, который потом упирается в контекстное окно
- Эксплуатация локальных ИИ-сервисов — продолжение: жизненный цикл сервиса, хранение весов, публикация, наблюдаемость и тепловой режим
- Страничная трансляция: таблицы, TLB, разрядность — оригинал идеи, которую PagedAttention переносит на KV-кэш: таблица отображения, блоки фиксированного размера, разделение и вытеснение
Из библиотеки института уносят только знания. Читателей здесь не считают: посещение не регистрируется, отметок в издании не остаётся, счётчиков нет ни у одного издания фонда.
Издание пополняется и пересверяется. Текст доступен на условиях CC BY-SA 4.0 — унесённое можно передавать дальше на тех же условиях.