Что здесь решено за автора
Первая статья цикла разбирала, зачем трансляция нужна, и заканчивалась выводом: на процессоре общего назначения выбора фактически нет — страницы. Эта статья разбирает, как страницы устроены, и начинается с того же наблюдения, повёрнутого другой стороной. Формат записи таблицы, число уровней, разрядность полей адреса, правила инвалидации TLB заданы системой команд, и код придётся писать ровно под них. Это единственный механизм цикла, который нельзя ни обойти, ни заменить своим: аллокатор бывает любым, планировщик бывает любым, а таблицы страниц обязаны выглядеть так, как их читает аппаратный обходчик, — иначе машина просто не начнёт транслировать.
Из этого не следует, что решать нечего. Железо задаёт формат записи и оставляет в ней биты, которыми распоряжается операционная система; задаёт число уровней и оставляет выбор разрядности; задаёт способ инвалидации и оставляет решение, когда её делать и над каким множеством адресов. Все дорогие решения в этой области — не «какой формат», а «когда платить»: за промах TLB, за рассылку инвалидаций, за поиск непрерывного куска физической памяти под большую страницу.
Три вещи стоит унести из статьи. Многоуровневая таблица — не единственный способ, и вытеснила она соперников по причинам, которые полезно знать: они объясняют, почему кэши промежуточных уровней вообще возможны. Настоящая цена виртуальной памяти лежит не в таблицах, а в TLB: попадание бесплатно, промах стоит обхода дерева, и вся инженерия последних тридцати лет — про то, как промахов было меньше. И почти все различия между x86-64, ARM64 и RISC-V сводятся к пяти-шести решениям, принятым по-разному; зная их, любую четвёртую архитектуру читаешь по диагонали.
Почему дерево, а не таблица и не хеш
Плоская таблица — массив записей, индексируемый номером виртуальной страницы. Она была совершенно разумной, пока адрес был 32-битным: 2²⁰ страниц по 4 байта на запись дают 4 МиБ на процесс, и это в худшем случае, когда отображено всё. С 48-битным адресом та же арифметика даёт 2³⁶ записей по 8 байт — 512 ГиБ на процесс, и это не «дорого», а бессмысленно: одна таблица не помещается в физическую память типичной машины, а нужна она каждому процессу. Для 57-битного пространства пятиуровневого режима x86-64 та же плоская таблица весила бы 256 ТиБ. Плоская таблица умерла не от неэффективности, а от разрядности.
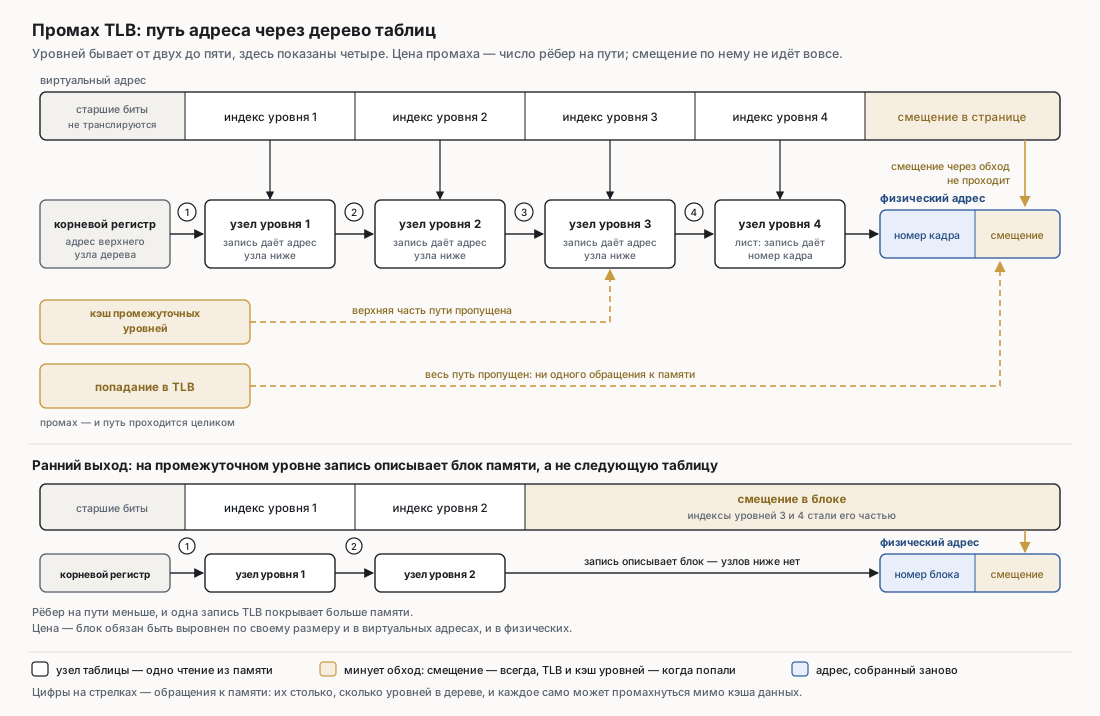
Дерево решает ровно одну задачу — разрежённость. Индекс режется на группы бит, каждая группа выбирает запись в узле своего уровня, и узел, все записи которого пусты, просто не существует. Процесс, отобразивший три области, платит за узлы вдоль трёх путей, а не за всё пространство. Дополнительная удача в том, что узел удобно сделать ровно размером со страницу: при 4 КиБ и 8-байтной записи в узел влезает 512 записей, то есть 9 бит индекса, и узел выделяется тем же аллокатором, что и всё остальное. Отсюда же берётся 4 × 9 + 12 = 48 бит на четырёх уровнях и 5 × 9 + 12 = 57 на пяти — числа, которые выглядят произвольными, пока не увидишь, откуда они.
Цена дерева — обращения к памяти. Промах TLB на четырёхуровневой таблице означает четыре чтения из памяти ради того, чтобы узнать адрес одного чтения из памяти; на пяти уровнях — пять. Каждое из этих чтений само может промахнуться мимо кэша данных. Именно из-за этой цены существует всё, о чём говорится дальше в статье.
Обратные и хеш-таблицы: одна запись на кадр и чем это кончилось
Есть противоположный подход, и он выглядит убедительнее дерева, пока не начнёшь его реализовывать. Обратная таблица (inverted page table) хранит по записи не на виртуальную страницу, а на физический кадр: её размер пропорционален установленной памяти, а не адресному пространству, и она одна на всю машину, а не одна на процесс. Для 16 ГиБ памяти при 4 КиБ это 4 миллиона записей; даже по 16 байт — 64 МиБ на систему целиком. Против 512 ГиБ на процесс аргумент кажется закрытым.
Проигрыш вышел по трём причинам сразу, и все три структурные. Первая: таблица индексируется физическим кадром, а искать по ней нужно виртуальный адрес, поэтому поверх неё обязательно оказывается хеш — либо отдельная таблица-якорь с цепочками, либо, как в варианте PA-RISC, хеш-таблица без якоря, но с раздутыми до 16 байт записями, потому что в записи теперь приходится хранить и номер кадра тоже. Вторая: одна запись на кадр физически не описывает разделяемую страницу, видимую по двум разным адресам, — а это и есть половина того, ради чего существует трансляция. Приходится либо заводить цепочки, либо переносить разделение на уровень сегментов, как сделано в PowerPC. Третья и самая тяжёлая: хеш уничтожает локальность. У дерева верхние уровни переиспользуются свирепо — одна запись верхнего уровня в x86-64 покрывает 512 ГиБ, — и потому их можно кэшировать. У хеш-таблицы соседние виртуальные адреса попадают в случайные места таблицы, кэшировать нечего, и обход превращается в проход по цепочке без всяких гарантий на её длину.
Симуляция Джейкоба и Маджа, на которую опиралась и первая статья, сравнивала эти организации на одинаковых трассах и дала прямой ответ: схема x86 — иерархическая таблица, обходимая от корня к листьям аппаратным обходчиком, — обгоняет остальные, несмотря на то что каждый поиск требует лишних обращений к памяти. Одну сильную сторону обратных таблиц там же отметили честно: их записи упакованы плотно и потому меньше вытесняют из кэша данные приложения, чем разрежённые записи дерева.
История закрыла вопрос ещё определённее. Хеш-таблицы страниц дожили в трёх местах — PA-RISC, Itanium с его длинным форматом VHPT и PowerPC с хеш-таблицей из групп по восемь записей и вторичным хешем, — и все три места мертвы. Показательнее всего последнее: IBM, главный пользователь хеш-таблиц, добавила в POWER9 режим радиксной трансляции — обычное дерево, обходимое от корня, — и приложила к нему кэш промежуточных уровней (Radix Page Walk Cache, четыре уровня от 256 до 2048 записей), который на хеш-таблице был бы невозможен. Хеш-таблица там осталась, но уже как второй режим: между ними переключаются на уровне раздела. Все три архитектуры этого цикла спецификацией задают дерево и ничего кроме дерева.
Вывод для автора ОС прост и неприятен: обсуждать организацию таблиц не приходится. Она выбрана за вас, и выбрана так, что железо умеет её кэшировать. Ценность разбора — в понимании, почему промежуточные уровни вообще можно закэшировать: потому что путь к соседним адресам совпадает в верхних битах, а хеш это свойство уничтожает.
Разрядность и уровни в трёх архитектурах
Общая форма одинакова везде: старшие биты адреса режутся на индексы, младшие 12 (при 4 КиБ) остаются смещением внутри страницы и через обход не проходят вообще. Различия начинаются с того, сколько корней у дерева и что происходит со старшими битами, которые в трансляции не участвуют.
x86-64: один корень и канонические адреса
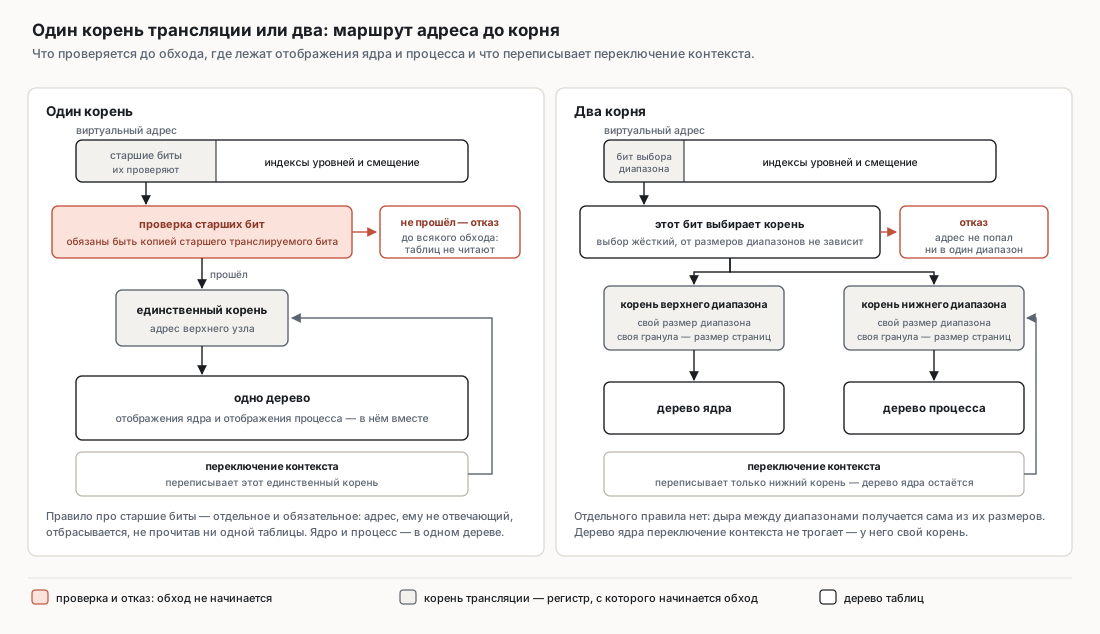
Корень один — физический адрес верхней таблицы лежит в CR3. Четырёхуровневый режим использует биты 47:12 адреса, то есть 48 бит; пятиуровневый (LA57) добавляет таблицу PML5, индексируемую битами 56:48, и доводит пространство до 57 бит. Включает его бит CR4.LA57, и менять этот бит процессор позволяет только вне длинного режима — то есть выбор разрядности принимается один раз, на раннем этапе загрузки, и передумать потом нельзя.
Биты выше просто не участвуют в трансляции, и Intel не оставила их безнадзорными: адрес обязан быть каноническим. В терминах SDM «линейный адрес каноничен, если биты 63:47 одинаковы», то есть биты 63:48 — знаковое расширение бита 47; при включённом пятиуровневом режиме проверка ослабляется до «биты 63:56 одинаковы». Неканонический адрес не транслируется вовсе — обращение по нему даёт отказ до всякого обхода таблиц, а попытка загрузить такой адрес в регистр, определённый как адресный, обычно даёт #GP.
Смысл требования — оставить возможность расширить адрес, не сломав софт, который успел занять старшие биты под своё. Цена в том, что оно есть и его нельзя обойти: адресное пространство разорвано посередине, между 2⁴⁷−1 и −2⁴⁷, и разрыв обязан быть учтён везде, где адрес считается арифметикой. Разрыв же и создаёт привычную картину «пользователь внизу, ядро вверху»: старшая половина — это в точности адреса с единичным знаковым расширением. Ядру Linux пришлось из-за LA57 принимать отдельное решение: «мы не собираемся по умолчанию выделять виртуальное адресное пространство выше 47 бит», потому что «как минимум некоторые JIT-компиляторы используют старшие биты указателей, чтобы кодировать в них свою информацию». Полное пространство отдаётся только тому, кто попросил его подсказкой адреса в mmap выше 47 бит.
ARM64: два корня вместо канонического трюка
ARM решил ту же задачу иначе, и разница не косметическая. Корней два: TTBR0_EL1 для нижнего диапазона, начинающегося с нуля, и TTBR1_EL1 для верхнего, заканчивающегося единицами. Выбор между ними делает бит 55 виртуального адреса — жёстко, по спецификации, независимо от того, какого размера сами диапазоны. Размеры задаются раздельно, полями TCR_EL1.T0SZ и TCR_EL1.T1SZ: нижний диапазон — от нуля до 2⁶⁴⁻ᵀ⁰ˢᶻ−1, верхний — симметрично от конца пространства. Адрес, не попавший ни в один из диапазонов, даёт отказ трансляции уровня 0.
Отсюда три следствия, каждое из которых экономит автору ОС работу. Проверки каноничности нет — она не нужна, потому что дыра посередине получается сама собой как «ни в один диапазон не попал», а не как отдельное правило про знаковое расширение. Таблицы ядра и таблицы процесса — разные деревья с разными корнями, поэтому переключение контекста переписывает только TTBR0_EL1, а верхняя половина остаётся неприкосновенной. И размеры половин настраиваются независимо: ядру можно отдать столько адресов, сколько оно использует, а не половину пространства.
Гранула тоже настраивается раздельно, полями TCR_EL1.TG0 и TCR_EL1.TG1 (у которых, к слову, разные кодировки — классическая ловушка). Гранул три: 4, 16 и 64 КиБ, и от неё зависит и разбиение адреса, и число уровней:
| Уровень | 4 КиБ | 16 КиБ | 64 КиБ |
|---|---|---|---|
| 0 | 512 ГиБ (биты 47:39) | 128 ТиБ (бит 47) | — |
| 1 | 1 ГиБ (38:30) | 64 ГиБ (46:36) | 4 ТиБ (51:42) |
| 2 | 2 МиБ (29:21) | 32 МиБ (35:25) | 512 МиБ (41:29) |
| 3 | 4 КиБ (20:12) | 16 КиБ (24:14) | 64 КиБ (28:16) |
Практический смысл таблицы — в последнем столбце: при 64 КиБ 48-битное пространство описывается тремя уровнями вместо четырёх, то есть промах TLB стоит на одно обращение к памяти меньше. Начальный уровень вычисляется из размера пространства: если старшие индексы заведомо нулевые, обход начинается ниже. 52-битные адреса на ARM64 существуют, но опциональны, и руководство Arm по управлению памятью (документ 101811, редакция 0105, сентябрь 2025) прямо отмечает, что «на момент написания ни один процессор Arm Cortex-A не поддерживает 52-битные виртуальные адреса».
RISC-V: один регистр на всё
RISC-V держит всё состояние трансляции в одном CSR — satp, где лежат режим, ASID и номер физической страницы корневой таблицы. Одна запись меняет и режим, и адресное пространство, и его тег; невозможно оказаться в состоянии, где корень уже новый, а тег ещё старый.
Режимов четыре: Sv32 (два уровня, 32 бита), Sv39, Sv48, Sv57 — три, четыре и пять уровней соответственно. Схема разрядности здесь скопирована не с ARM, а с x86: корень один, и спецификация требует знакового расширения ровно тем же образом — для Sv39 «биты 63:39 должны быть равны биту 38, иначе возникает исключение отказа страницы», для Sv48 — 63:48 равны биту 47, для Sv57 — 63:57 равны биту 56. То есть архитектура, спроектированная на двадцать лет позже x86-64, воспроизвела его развилку, а не решение ARM.
Насколько это заметно на практике, лучше всего видно в учебном ядре: xv6-riscv просто отказывается от половины пространства, определяя MAXVA на бит меньше разрешённого Sv39 — «чтобы не приходилось расширять знаком виртуальные адреса со взведённым старшим битом». Для реального ядра такой выход не годится, но он честно показывает, во что обходится единственный корень.
Что RISC-V мандатирует, а что оставляет опцией, стоит смотреть по профилю, а не по спецификации: в RVA23S64 — профиле для 64-битных прикладных процессоров под полноценные ОС, ратифицированном в октябре 2024 года, — обязателен Sv39, а Sv48 и Sv57 числятся расширяющими опциями.
Что из этого удобнее автору ОС
| x86-64 | ARM64 | RISC-V | |
|---|---|---|---|
| Корень трансляции | CR3 |
TTBR0_EL1 и TTBR1_EL1 |
satp |
| Корней на пространство | один | два, выбор по биту 55 | один |
| Старшие биты адреса | проверка каноничности | вне диапазонов — отказ | проверка каноничности |
| Разрядности | 48 (4 уровня), 57 (LA57) | зависит от TnSZ и гранулы |
Sv39/Sv48/Sv57 |
| Базовый размер страницы | 4 КиБ | 4, 16 или 64 КиБ (гранула) | 4 КиБ |
| Тег адресного пространства | PCID, 12 бит | ASID, 8 или 16 бит | ASID, до 16 бит, в satp |
| Обновление битов A/D | всегда железом | опция (FEAT_HAF/FEAT_HAFDBS) | по спецификации железом; RVA23S64 требует Svade, то есть исключение |
| Инвалидация на чужих ядрах | IPI; INVLPGB у AMD |
TLBI ...IS/OS в системе команд |
нет в ISA; IPI или прошивка (SBI) |
Вердикт по первой целевой архитектуре получается такой. Начинать проще всего с RISC-V Sv39: три уровня, одна запись в один регистр включает трансляцию, формат записи единственный, а глава спецификации про супервизор читается за вечер. Второй по удобству — ARM64, и именно из-за раздельных корней: код, написанный под два корня, сам собой получается таким, каким его хочется иметь, а обратный переход болезнен. x86-64 в этой тройке сложнее всех, но не из-за самих таблиц — они простые, — а из-за того, что в длинный режим нельзя войти, не построив таблицы заранее: страничная трансляция там обязана заработать раньше всего остального. Контрдовод в его пользу сильный и не технический: документации, разборов и отладочного инструментария вокруг x86-64 на порядок больше, чем вокруг двух других вместе, и первые недели на нём идут заметно быстрее. Перевешивает его то, где именно лежит сложность: у x86-64 она приходится на самое начало, на код, который ещё нечем отлаживать, а выигрыш от чужих туториалов приходит позже и распределён тонким слоем по всей работе.
Разница «один корень или два» — самая содержательная в этом списке, и она не про удобство записи кода. Два корня означают, что отображения ядра и процесса лежат в разных деревьях и переключение процесса верхней половины не касается; один корень означает, что они всегда в одном дереве, и переключение переписывает корень целиком.
Соблазнительно продлить эту мысль до «поэтому у ARM64 нет проблемы Meltdown», и это было бы неверно. Раздельные корни не мешают спекулятивно прочитать данные через отображения, установленные в TTBR1_EL1, пока исполняется код EL0, и Linux имеет KPTI и на arm64: CONFIG_UNMAP_KERNEL_AT_EL0 включён по умолчанию и работает переключением TTBR1_EL1 между полной и урезанной картой ядра через страницу-трамплин в таблице векторов. Нужен ли он на конкретном ядре, решается по ID_AA64PFR0_EL1.CSV3 и списку заведомо безопасных моделей. Что раздельность действительно дала — это возможность закрыть часть той же проблемы дешевле: расширение FEAT_E0PD полями TCR_ELx.{E0PD0,E0PD1} запрещает доступ из EL0 к целой половине карты, причём архитектура требует, чтобы время получения такого отказа не зависело от наличия адреса в TLB, «чтобы предотвратить использование этой информации для определения присутствия адреса в TLB». Собственное описание в ядре Linux честно очерчивает область применения: E0PD даёт «преимущества для KASLR, схожие с теми, что даёт KPTI, но с меньшими накладными расходами», то есть закрывает подбор адресов, а не утечку данных. Обратная сторона этой замены записана там же в коде: kaslr_requires_kpti() возвращает истину везде, где E0PD не реализован, и при включённом KASLR ядро форсирует KPTI даже на процессоре, признанном безопасным по CSV3.
Запись таблицы: что в ней есть и кто её меняет
Запись листового уровня во всех трёх архитектурах — 64 бита, из которых основную часть занимает номер физического кадра, а остальное делится на четыре группы: признак действительности, права, атрибуты кэширования и служебные биты, часть которых отдана операционной системе.
Права: что выражается, а что нет
Признак действительности — тот самый бит, который делает соответствие «адрес → память» частичным, а без частичности не работает ничего из перечисленного в первой статье. У него есть побочное свойство, на котором держится реализация свопа: когда бит сброшен, остальные биты записи железу не нужны. RISC-V говорит это прямым текстом — «если V равен 0, все остальные биты PTE безразличны и могут свободно использоваться программой», — и на x86-64 при P=0 действует то же правило. Отсюда и берётся приём, которым пользуются все ядра: у вытесненной страницы в записи лежит не адрес кадра, а закодированный номер устройства подкачки и смещение.
Права различаются сильнее, чем кажется, и различия видны по тому, чего в записи нет. У x86-64 три бита: R/W, U/S и XD (бит 63, работает при IA32_EFER.NXE=1); присутствие подразумевает чтение, поэтому страницу «только на исполнение» тут таблицами не выразить. RISC-V вместо этого держит три независимых бита R, W, X плюс U, и получает страницу «только на исполнение» как обычную комбинацию, а заодно экономит отдельный признак «блок или указатель»: запись с R=W=X=0 означает указатель на следующий уровень, всё остальное — лист. Комбинации с W без R зарезервированы. Разработчики RISC-V там же объясняют, почему не стали делать раздельные права для супервизора и пользователя: это «было бы во многом избыточно с механизмом SUM и потребовало бы больше кодового пространства в PTE». ARM64 стоит особняком: права задаются полем AP[2:1] и парой UXN/PXN (биты 54 и 53), причём запрет исполнения раздельный для привилегированного и непривилегированного уровня, а «блок или таблица» кодируется битами [1:0]. Всё перечисленное — прямые права: биты, которые железо трактует само. С расширением FEAT_S1PIE у ARM64 появились и косвенные, где те же биты дескриптора превращаются в индекс, а сама таблица из шестнадцати разрешений лежит в регистрах PIR_EL1 и PIRE0_EL1; дальше речь идёт про прямые.
До сих пор речь шла о листовой записи, и этого мало: права набираются вдоль всего пути, и набираются по-разному. x86-64 складывает ограничения логически: адрес считается супервизорным, если U/S равен нулю «хотя бы в одной из записей», запись разрешена, только если R/W равен единице «в каждой записи, управляющей трансляцией» (для доступа из ядра — при CR0.WP = 1), а выборка инструкций запрещена, если XD взведён хоть где-то. Поставить U на лист поэтому недостаточно: пока U/S равен нулю на любом уровне выше, страница для пользователя не существует. ARM64 даёт то же самое явно и отключаемо: табличный дескриптор несёт APTable, UXNTable и PXNTable, ужимающие права всего поддерева, а FEAT_HPDS позволяет их выключить битами TCR_ELx.HPD0 и HPD1, после чего они трактуются как нули. RISC-V не имеет этого вовсе: у нелистовых записей «биты D, A и U зарезервированы» и должны быть нулевыми, права берутся только из листа. Разница дороже, чем кажется в перечислении. На x86-64 и ARM64 промежуточный уровень — это и лишнее место, где можно ошибиться, и рычаг: одна правка APTable снимает права с целого поддерева, не трогая ни одного листа. На RISC-V нет ни того ни другого, и снятие прав всегда стоит прохода по листьям.
Практический вывод отсюда про W^X, и он про то, чего в записи x86-64 нет. Правило «страница либо записываемая, либо исполняемая» выражается везде, а вот более сильное «исполняемая и нечитаемая» на RISC-V и ARM64 записывается прямо в таблице, а на x86-64 — нет: бита «нечитаемая» в записи не существует. Из этого, однако, не следует, что execute-only на x86-64 недостижим. Linux строит его этажом выше: __execute_only_pkey() в arch/x86/mm/pkeys.c выделяет процессу ключ защиты памяти и ставит ему PKEY_DISABLE_ACCESS, так что на процессоре с PKU PROT_EXEC без PROT_READ даёт настоящую нечитаемую исполняемую страницу. Цена подмены — в том, где живёт запрет. Не в записи таблицы, которую может менять только ядро, а в регистре PKRU, который переписывается непривилегированной инструкцией WRPKRU: от чужого кода такая страница защищена, от собственного — нет, потому что процесс волен снять с себя ограничение одной инструкцией. Механизм ключей и его границы разобраны в первой статье цикла, в разделе про ключи защиты памяти.
Биты обращения и записи
Бит обращения (accessed, access flag) и бит записи (dirty) — вход для кода вытеснения: по первому выбирают, что выкидывать, по второму решают, надо ли перед этим писать на диск. Различие между архитектурами здесь в том, кто эти биты выставляет, и оно меняет устройство кода вытеснения целиком.
На x86-64 их выставляет процессор, и без вариантов: «всякий раз, когда процессор использует запись таблицы страниц в трансляции линейного адреса, он устанавливает в этой записи бит обращения», а при записи по адресу — устанавливает бит записи в той записи, которая даёт итоговый физический адрес. Биты «липкие»: сбросить их может только программа.
На ARM64 обе возможности опциональны и включаются раздельно: аппаратное обновление флага обращения требует FEAT_HAF и включается битом TCR_ELx.HA, аппаратное управление признаком записи — FEAT_HAFDBS и бита TCR_ELx.HD. Без них операционная система обязана делать это сама, и архитектура устроена так, чтобы это было дёшево: «дескрипторы с AF, равным нулю, никогда не могут быть закэшированы в TLB», поэтому выставление флага в обработчике не требует инвалидации TLB вообще. Признак записи, когда он аппаратный, реализован изящным трюком: страница помечается как «записываемая, но чистая» — права стоят на чтение (AP[2]), а бит DBM (бит 51) взведён, — и при первой записи железо само снимает AP[2], превращая её в «записываемую грязную».
RISC-V определяет обе схемы явно и, что важнее, различает их расширениями. При наличии Svade «когда к виртуальной странице обращаются с нулевым битом A или пишут с нулевым битом D, возбуждается исключение отказа страницы»; в отсутствие Svade биты обновляет железо, а расширение Svadu добавляет CSR-управление этим поведением через menvcfg.ADUE. Здесь легко ошибиться, потому что интуиция подсказывает обратное: спецификация даёт аппаратное обновление как поведение по умолчанию, но профиль RVA23S64 обязательным делает именно Svade, а Svadu числит расширяющей опцией. То есть на соответствующем профилю прикладном процессоре обработчик отказа для битов A и D писать придётся, и рассчитывать на аппаратное обновление нельзя.
Разница в коде получается принципиальная. При программной схеме первое обращение к странице и первая запись в неё — это исключения, то есть обработчик отказа оказывается на горячем пути, обязан быть реентерабельным и вызываемым из любого контекста, зато состояние таблиц меняет только ядро и гонок с железом нет. При аппаратной схеме гонки есть, и их придётся учитывать: обе спецификации требуют атомарного чтения-модификации-записи со стороны железа, а SDM отдельно предупреждает о случае, когда один процессор пишет в страницу, а другой в этот момент снимает у неё бит R/W, — на процессорах без CET результатом может оказаться запись с установленным dirty и снятым R/W.
Сбрасывать эти биты в любом случае дороже, чем ставить: сброс — это изменение записи, которая уже могла попасть в TLB, а значит инвалидация. Сканирование битов обращения ради вытеснения поэтому стоит не «прочитать бит», а «прочитать бит и сбросить его во всех TLB системы».
Биты, отданные операционной системе
Свободных бит в записи мало, и распоряжаются ими везде примерно одинаково. x86-64 щедрее всех: биты 10:9 игнорируются, бит 11 игнорируется при обычной трансляции (при HLAT он означает перезапуск), биты 58:52 тоже игнорируются, а 62:59 отданы под ключ защиты, если он включён. ARM64 резервирует «для использования программой» биты 58:55, а в некоторых состояниях безопасности ещё и бит 63. RISC-V выделяет два бита — RSW, биты 9:8, — и добавляет, что «реализация обязана игнорировать это поле».
Двух бит мало, и именно поэтому приём с недействительной записью так важен: настоящее хранилище для служебных данных ОС — это не свободные биты действительной записи, а вся запись целиком, когда она недействительна. В действительной записи держат то, что нужно знать, не ломая отображения: страница закреплена, страница особая, страница уже посчитана в такой-то статистике.
Кто обходит таблицы
Обходчик может быть аппаратным или программным, и это две радикально разные операционные системы вокруг одной идеи.
Аппаратный обходчик — конечный автомат в процессоре. Формат таблиц при нём фиксирован намертво, зато промах TLB не превращается в исключение: конвейер не сбрасывается, обход идёт параллельно с независимыми инструкциями, а результаты промежуточных уровней можно кэшировать. Так устроены все три архитектуры цикла.
Программно управляемый TLB — противоположное решение: промах вызывает исключение, а таблицы обходит код операционной системы и сам записывает результат в TLB. Так работали MIPS, SPARC и Alpha. Формат таблиц при этом целиком ваш, и это не теория: на одном и том же MIPS Ultrix держал двухуровневую таблицу, а Mach — трёхуровневую, и обе обходились снизу вверх. Обработчик получался коротким; классический MIPS-овый выглядел так:
mfc0 k0,tlbcxt   # регистр контекста уже содержит адрес нужной записи
mfc0 k1,epc
lw   k0,0(k0)
mtc0 k0,entry_lo
tlbwr
j    k1
rfe
Семь инструкций, если не считать выброшенных из листинга NOP'ов, — и это возможно только потому, что железо всё-таки помогает: регистр контекста заранее собирает адрес нужной записи из базы таблицы и номера страницы. Дальше начинаются неприятности, которые из листинга не видны. Обработчик и таблицы, которые он читает, обязаны лежать в неотображаемой памяти или быть закреплены в TLB, иначе промах случится внутри обработчика промаха. Точное исключение сбрасывает конвейер, выкидывая из него всё, что успело набраться. И если код обработчика вылетел из кэша инструкций, промах стоит на порядок дороже, чем при аппаратном обходе.
Между этими двумя полюсами есть третья точка, и её стоит знать, потому что она объясняет, почему выбор вообще выглядел открытым. Itanium имел и то и другое: аппаратный обходчик VHPT в одном из двух форматов на выбор — 8-байтные записи виртуальной линейной таблицы на регион или 32-байтные записи одной большой хеш-таблицы, — но обходчик был не обязательным элементом реализации и не обязан был находить трансляцию. Формулировка руководства не оставляет двусмысленности: «Операционные системы обязаны рассматривать обходчик VHPT строго как оптимизацию производительности и должны быть готовы обработать промахи TLB, если обходчик не справился». То есть у железа была роль кэша над таблицами, которые всё равно ведёт и заполняет операционная система. Ни одна из трёх современных архитектур этот компромисс не повторила: обходчик там обязателен и всегда доводит дело до конца или до отказа страницы.
Спор закрыт, и закрыт он в тексте самой молодой из трёх спецификаций. RISC-V пишет прямо: «Мы спроектировали раскладку таблиц страниц с расчётом на аппаратный обходчик. Программные заполнения TLB — узкое место производительности на высокопроизводительных системах и особенно неприятны при наличии отвязанных специализированных сопроцессоров». Дверь при этом оставлена приоткрытой — «реализация вправе сделать программное заполнение TLB через обработчик ловушек в машинном режиме как расширение M-режима», — но реализаций прикладного класса, которые бы этим воспользовались, я не нашёл.
Тот же вывод получен и измерениями: сравнение Джейкоба и Маджа отдало первое место схеме x86 именно за то, что она «не использует механизм точных исключений и потому избегает накладных расходов на прерывание при каждом промахе TLB», а заодно не тратит кэш инструкций на код обработчика.
Практическое следствие для автора ОС: под аппаратным обходчиком вы пишете не обходчик, а заполнитель чужого формата. Вся свобода — в том, когда и что в этот формат класть.
TLB: где на самом деле находится цена
Дальше идёт главное. Трансляция как таковая ничего не стоит: попадание в TLB — это чтение из маленькой ассоциативной памяти на пути обращения. Стоит промах, и стоит ровно столько, сколько занимает обход. Отсюда вся арифметика: четыре уровня — до четырёх обращений к памяти, пять — до пяти, а под гипервизором с двумя ступенями трансляции каждое из них само транслируется второй ступенью, и полный двумерный обход требует, по формуле из работы об ускорении двумерных обходов, nm + n + m обращений: при четырёхуровневой гостевой и четырёхуровневой вложенной таблице это 24 обращения вместо четырёх — «в шесть раз больше, чем у нативного четырёхуровневого обхода».
Это и есть ответ на вопрос, зачем нужен весь остальной раздел. Число уровней — параметр производительности, а не только разрядности: Sv39 против Sv48 — это одно лишнее обращение к памяти на каждый промах, навсегда.
Кэши промежуточных уровней
Верхние уровни дерева переиспользуются несоизмеримо чаще нижних: одна запись PML4 в x86-64 покрывает 512 ГиБ, одна запись PML5 — 256 ТиБ. Кэшировать их отдельно от готовых трансляций — очевидная идея, и все реализуют её по-своему; систематический разбор пространства этих решений — работа Барра, Кокса и Рикснера, показавшая, что выигрывают кэши частичных трансляций, позволяющие обходчику пропустить один или несколько уровней.
Intel документирует эти структуры под именем paging-structure caches: отдельные кэши для записей PML5, PML4, PDPTE и PDE, каждый индексируется префиксом линейного адреса (для PML5 это 9 бит 56:48, для PML4 при пятиуровневой трансляции — 18 бит 56:39) и хранит не только адрес следующей таблицы, но и свёрнутые права: логическое И флагов R/W и U/S по пройденным уровням и логическое ИЛИ флагов XD. ARM называет их «промежуточными структурами кэширования TLB» и обращается с ними как с частью TLB: «для целей обслуживания TLB записью TLB является любая структура, содержащая запись таблицы трансляции, включая промежуточные структуры кэширования TLB и временные рабочие регистры аппаратуры обхода таблиц». POWER9 имеет такой кэш под именем Radix PWC, и, что показательно, появился он там вместе с радиксной трансляцией.
Из этого следуют два правила, о которых легко забыть. Инвалидация листовой записи не обязана выбрасывать промежуточные — и наоборот, изменение записи промежуточного уровня требует инвалидации, покрывающей весь описываемый ею диапазон, а не один адрес. И промежуточные структуры на ARM могут быть проиндексированы физическим адресом хранилища записи, а не виртуальным адресом: узнать, так ли это, позволяет FEAT_nTLBPA, и без него приходится делать обслуживание, которое иначе не потребовалось бы.
Теги вместо полного сброса
Что происходит с TLB при записи нового корня, три архитектуры решают по-разному, и разница здесь не про скорость, а про корректность. x86-64 сбрасывает сам: MOV to CR3 при CR4.PCIDE = 0 «инвалидирует все записи TLB, связанные с PCID 000H, кроме относящихся к глобальным страницам», — наивное переключение контекста тут верно и просто дорого. RISC-V говорит обратное прямым текстом: «запись satp не подразумевает ни ограничений на порядок между обновлениями таблиц и последующими трансляциями, ни какой-либо инвалидации кэшей трансляции адресов», и если таблицы нового пространства менялись или ASID переиспользован, sfence.vma обязателен. ARM64 устроен так же: запись TTBR0_EL1 сама по себе не выбрасывает ничего, и руководство Arm прямо называет ASID средством «избавиться от необходимости инвалидации TLB при переключении контекста». То есть на двух архитектурах из трёх переключение контекста без тегов и без явной инвалидации — не медленный код, а неверный: процесс увидит трансляции предшественника. Теги здесь не оптимизация поверх работающего механизма, а способ не платить за инвалидацию, которую иначе обязан делать сам.
x86-64 называет тег PCID: 12 бит, включается CR4.PCIDE, доступен только в длинном режиме, значение берётся из младших бит CR3. Тонкость в том, сколько из этих 4096 значений реально используется: Linux заводит шесть на процессор, и комментарий в заголовке говорит, почему именно шесть — «6, потому что шести должно хватить с запасом и struct tlb_state уложится в две кэш-линии». Дефицита здесь нет: тег привязывается к процессу на конкретном процессоре, а не глобально. Зато KPTI съедает целый бит: каждому процессу при включённой изоляции нужны два адресных пространства (пользовательское и ядерное), различаются они битом 11 в PCID, и полезное пространство тегов уменьшается вдвое.
ARM64 называет тег ASID и делает его 8- или 16-битным (что именно — сообщает ID_AA64MMFR0_EL1). Тег живёт в том же регистре TTBRn_EL1, что и корень, поэтому одна запись меняет и таблицу, и её тег. Тегируются не все записи, а только помеченные битом nG: отображения ядра оставляют глобальными, и они годятся при любом ASID. Шестнадцати бит хватает, чтобы выдавать тег на процесс глобально, и Linux так и делает — с поколениями и общим сбросом при переполнении. RISC-V устроен так же: ASID лежит в satp рядом с режимом и корнем, бит G помечает глобальные отображения, а число реализованных бит ASID узнаётся записью единиц во всё поле и чтением обратно.
Глобальные страницы — отдельный механизм с той же целью: у x86-64 это бит G при CR4.PGE=1, и «логический процессор может использовать глобальную запись TLB для трансляции линейного адреса, даже если запись связана с PCID, отличным от текущего». Ровно поэтому KPTI с ними конфликтует: смысл изоляции в том, чтобы ядерных отображений в пользовательских таблицах не было, а глобальный бит делает их живучими через переключения. Документация ядра формулирует итог: «Глобальные страницы отключены для всех структур ядра, не отображённых одновременно в ядерные и пользовательские таблицы страниц».
Для гостей есть второй тег — VMID на ARM64, а на x86-64 два имени для одного и того же: VPID у Intel и ASID у AMD, — чтобы вход в гостя и выход из него не выбрасывали трансляции хозяина. SDM описывает VPID как способ «идентифицировать процессору адресные пространства разных „виртуальных процессоров“», позволяющий держать в TLB сведения о нескольких пространствах сразу, «даже когда ненулевые PCID не используются».
Инвалидация в многопроцессорной системе
Есть одно предложение, из которого следует весь этот подраздел, и ARM формулирует его без обиняков: «TLB и структуры кэширования TLB не гарантируют когерентности с изменениями записей таблиц трансляции и поэтому отличаются от кэшей данных». Кэши данных держит когерентными протокол, за TLB не отвечает никто. Значит, сняв отображение, ядро обязано само добиться, чтобы его выбросили из TLB всех процессоров, которые могли его закэшировать.
Классическое решение — рассылка межпроцессорных прерываний с ожиданием: инициатор шлёт IPI всем подозреваемым и ждёт подтверждения. Цена очевидна и не в самой инвалидации, а в том, что каждый адресат отвлекается от своей работы, а инициатор стоит.
Три архитектуры отвечают на это по-разному, и разница определяет масштабируемость ядра сильнее, чем выглядит.
ARM64 сделал широковещательную инвалидацию идиомой, а не оптимизацией: суффикс IS у TLBI рассылает операцию по внутреннему домену разделяемости, OS (с Armv8.4-A) — по внешнему, и снятие отображения выглядит как запись в таблицу, DSB ISH, TLBI, ещё DSB ISH и ISB. Обратная сторона проявилась с ростом числа ядер, и ответ на неё свежий: FEAT_TLBID из Armv9.7-A вводит домены инвалидации, позволяя рассылать операцию только тем ядрам, где нагрузка реально исполнялась, — на системе из четырёх кристаллов по 64 ядра разница между «всем» и «этому кристаллу» перестаёт быть теоретической.
x86-64 долго не имел ничего, и вся работа лежала на IPI. AMD добавила инструкции INVLPGB и TLBSYNC; в Linux поддержка появилась в 6.15. Устроены они по принципу «сравнить и выбросить»: биты в rax задают, какие компоненты — виртуальный адрес, PCID, ASID — участвуют в сравнении, инструкция слабо упорядочена, а TLBSYNC дожидается завершения инвалидаций, начатых на этом же процессоре. Интереснее всего то, что широковещание потребовало от ядра нового понятия: чтобы выбросить запись по тегу на всех процессорах сразу, тег обязан быть одним и тем же везде, — и рядом с шестью динамическими ASID появился класс глобальных, одинаковых на всю систему. Измерения из сопроводительного письма к серии патчей заодно показывают, как работает вытеснение узкого места: на 36-ядерной машине AMD Milan на тесте will-it-scale tlb_flush2_threads доля инвалидации TLB упала с 40 % процессорного времени примерно до 4 %, но пропускная способность при этом не сдвинулась вовсе — 527 тысяч итераций в секунду и до, и после, потому что нагрузка немедленно упёрлась в следующий замок. Выросла она только вместе со снятием этого замка: до 1157 тысяч.
RISC-V не имеет широковещательной инвалидации в системе команд вовсе. sfence.vma упорядочивает и инвалидирует только у своего харта, и спецификация это подчёркивает. Кого дёргать и чем — решает уже ядро, и вариантов у него два. Первый и самый известный — вызов прошивки: расширение RFENCE в SBI с функцией sbi_remote_sfence_vma, то есть те же IPI, только спрятанные под интерфейс, и стоимость их из S-режима действительно не видна и не управляема. Но он не единственный, и распространённая формулировка «на RISC-V всё уезжает в прошивку» неверна: Linux ходит через SBI только там, где через SBI идут и сами IPI, — это статический ключ riscv_use_sbi_for_rfence(), взводимый в arch/riscv/kernel/sbi-ipi.c, — а иначе рассылает инвалидацию обычным on_each_cpu_mask() в S-режиме, не заходя в прошивку вообще. На платформе с AIA/IMSIC, где прерываниями заведует само ядро, ключ остаётся выключенным. Так что оптимизировать путь рассылки можно; чего нельзя — выдать инвалидацию всем одной инструкцией. Из полезного там есть Svinval с раздельными sinval.vma, sfence.w.inval и sfence.inval.ir, позволяющее выдать пачку инвалидаций без барьера на каждой, и Svvptc, снимающее необходимость в инструкции синхронизации в самом частом случае — когда запись переводится из недействительной в действительную. Статус у них разный, и это существенно: Svinval в RVA23S64 обязательно, а Svvptc — расширяющая опция, там же, где Sv48, Sv57 и Svadu, так что рассчитывать на него в общем случае нельзя.
Про этот частый случай стоит сказать отдельно, потому что архитектуры расходятся именно здесь и расхождение стоит работы. На x86-64 и ARM64 недействительная запись в TLB не попадает: SDM пишет, что при переводе флага P из 0 в 1 «инвалидация не нужна, потому что ни запись TLB, ни запись кэша структур трансляции не создаётся по записи, у которой флаг P равен 0», а ARM перечисляет то же для отказов трансляции, размера адреса и флага обращения. Значит, отображение, которого не было и которое появилось, инвалидации не требует вообще. RISC-V так не устроен: спецификация прямо разрешает обратное — «в любой момент все записи таблицы страниц, достижимые исполнением алгоритма, могут быть загружены в кэш трансляции адресов», то есть недействительная запись тоже может осесть, и sfence.vma после её оживления обязателен. Ровно эту цену и снимает Svvptc.
Обратная сторона того же правила — Break-Before-Make: заменить живое отображение другим живым нельзя одной записью, надо сначала сделать его недействительным, провести инвалидацию и только потом записать новое, иначе разные процессоры будут какое-то время видеть разные трансляции одного адреса. ARM смягчает это расширениями FEAT_BBM, где уровень 2 и выше гарантируют корректность смены размера отображения без разрыва. И там же, где ослабление прав требует инвалидации всегда, послабление её иногда не требует: на x86-64 перевод R/W из 0 в 1 без инвалидации грозит «ложным» отказом страницы «не более одного раза на каждый затронутый линейный адрес» и ничем больше. Для U/S то же послабление SDM даёт с условием, которое нельзя терять: оно действует, только «если CR4.SMEP = 0». На любом современном ядре SMEP включён, а значит, оставленная в TLB запись с U/S = 0 на ставшей пользовательской странице — это не лишний отказ, а обход самого SMEP: страница уже пользовательская, но кэшированная трансляция считает её супервизорной, и выборка инструкций из неё в режиме ядра пройдёт — ровно то, что SMEP и существует запрещать. Из таких мелочей и складывается разница между наивным и быстрым кодом — и, если читать их невнимательно, между быстрым и дырявым.
Практический вывод: на ARM64 наивно написанный код снятия отображения масштабируется сам; на x86-64 пакетирование инвалидаций и порог «проще сбросить всё, чем перечислять адреса» придётся делать одними из первых; на RISC-V широковещательной инвалидации нет в принципе, и рассылку придётся написать самому — своими IPI или через SBI, смотря по платформе.
Большие страницы
Способов уменьшить давление на TLB ровно два, и они устроены по-разному.
Первый — остановить обход раньше: запись промежуточного уровня описывает не следующую таблицу, а сразу большой кусок памяти. Так получаются 2 МиБ и 1 ГиБ на x86-64 и на ARM64 с 4-килобайтной гранулой, «мегастраницы» и «гигастраницы» в терминах RISC-V (Sv48 добавляет к ним «терастраницы» по 512 ГиБ, Sv57 — ещё и «петастраницы» по 256 ТиБ). Требование одно и жёсткое: такой кусок «должен быть виртуально и физически выровнен по границе, равной его размеру». Это не произвол спецификации, а прямое следствие разбора адреса. Остановившись уровнем выше, обход не использует индексы оставшихся уровней, и эти биты целиком уходят в смещение внутри блока; закодировать ими сдвинутую базу нечем — в записи под номер кадра отведены только старшие биты физического адреса, младшие подразумеваются нулевыми. Отсюда же и выигрыш, ради которого всё затевается: различающая внутренность блока часть адреса в трансляции не участвует вовсе, поэтому одна запись TLB покрывает его целиком.
Второй способ тоньше: оставить листовой уровень как есть, но сообщить железу, что подряд идущие записи описывают непрерывный диапазон, и его можно держать в TLB как одну трансляцию. У ARM64 это бит Contiguous (бит 52): при 4-килобайтной грануле на третьем уровне он объединяет 16 записей в 64 КиБ, при 16-килобайтной — 128 записей в 2 МиБ. У RISC-V это расширение Svnapot и бит N (бит 63) с тем же смыслом. Разница с первым способом существенная: подсказка даёт промежуточный размер между страницей и блоком и не меняет структуру таблицы, зато требует от программы аккуратности — «архитектура не требует, чтобы дескрипторы со взведённым битом Contiguous кэшировались как одна запись TLB», поэтому обслуживание TLB надо делать по всему диапазону, а не по одной записи; неверно расставленный бит — это уже не ошибка производительности, а перекрывающиеся записи в TLB. У x86-64 аналога подсказки нет.
Платят за большие страницы дважды. Внутренней фрагментацией: 2 МиБ под отображение в 200 КиБ — это не только потраченная память, но и грязная целиком страница, которую при вытеснении придётся записать целиком. И трудностью выделения: чтобы собрать 2 МиБ, нужны 512 физически подряд идущих свободных кадров с правильным выравниванием, а их на живой системе может просто не быть.
Отсюда растёт главная проблема прозрачных больших страниц. Когда подходящего блока нет, у ядра три варианта: отдать обычные страницы, разбудить фоновое уплотнение или уплотнять прямо сейчас, в контексте обратившегося процесса. Последнее — это задержка на ровном месте, и документация Linux честно объясняет, откуда взялась развилка: «если мы тратим процессорное время на дефрагментацию памяти, мы вправе ожидать, что выиграем больше за счёт использования больших страниц вместо обычных. Но это не всегда гарантировано». Управляется поведение отдельной настройкой defrag, где always означает прямое высвобождение с остановкой приложения, defer — фоновое, madvise (умолчание) — прямое только там, где программа его попросила.
Свежий ответ на ту же проблему — многоразмерные прозрачные страницы (mTHP): вместо прыжка с 4 КиБ сразу на 2 МиБ ядро умеет отдавать промежуточные размеры — любую степень двойки от базовой страницы до PMD-размера (16, 32, 64 КиБ и дальше; какие именно доступны, зависит от системы), — каждый со своим переключателем в /sys/kernel/mm/transparent_hugepage/hugepages-<размер>kB/enabled; по умолчанию PMD-размер наследует общую настройку, остальные выключены. Это ровно то же, что делает подсказка о непрерывности на ARM64 и RISC-V, только средствами ядра. Для анонимной памяти страницы по 1 ГиБ прозрачными не бывают: гигабайт непрерывной физической памяти на работающей системе не собрать, поэтому их резервируют при загрузке. Механизм для PUD-размера в ядре при этом есть — x86_64 выбирает HAVE_ARCH_TRANSPARENT_HUGEPAGE_PUD, — но работает он там, где непрерывность дана по построению: ZONE_DEVICE и DAX, большие отображения по номеру кадра. Исключение подтверждает довод: препятствие не в размере, а в том, откуда берётся непрерывный физический диапазон.
Вердикт для своей ОС такой. Начинать надо с блочных отображений для собственной карты ядра — там физическую раскладку выбираете вы, память заведомо непрерывна, а выигрыш не требует доказательств. Прозрачные большие страницы для пользовательской памяти оставьте на потом: они дают проценты и требуют уплотнителя, дефрагментации и политики, которая сама по себе больше кода, чем весь остальной механизм.
Размер страницы как компромисс
Четыре килобайта выбирались, когда память измерялась мегабайтами, и с тех пор всё, что зависит от этого числа, изменилось на три порядка. От размера страницы линейно зависят три величины. Число кадров, а с ним и объём метаданных: Linux держит дескриптор на каждый физический кадр, и при 16 КиБ таких дескрипторов вчетверо меньше. Охват TLB: тысяча записей при 4 КиБ покрывает 4 МиБ рабочего множества, при 16 КиБ — 16 МиБ, и это без всяких больших страниц. И число уровней: 64-килобайтная гранула описывает 48 бит тремя уровнями вместо четырёх.
Против — внутренняя фрагментация, и она тоже линейна: файл в 100 байт занимает страницу, а тысяча таких файлов при 64 КиБ занимает 64 МиБ.
Никакой теории здесь нет, есть работающие точки. Apple выбрала 16 КиБ: XNU собирается под 16-килобайтную гранулу (__ARM_16K_PG__ включает ARM_PGSHIFT 14 в osfmk/arm64/proc_reg.h), и на машинах Apple silicon getconf PAGE_SIZE возвращает 16384 — последнее я наблюдал сам. Обещания в виде константы Apple при этом не даёт, а даёт прямо противоположное указание: в руководстве по переносу кода на Apple silicon размер страницы отнесён к тому, что нельзя зашивать в код, и его велено «получать из глобальной переменной vm_page_size» в рантайме. Android движется туда же и приводит измерения: загрузка системы быстрее «на 8 % (примерно 950 миллисекунд) в среднем», запуск приложения под давлением памяти «в среднем на 3,16 % ниже, а у некоторых приложений — до 30 %», холодный запуск камеры «в среднем на 6,60 % быстрее», — с оговоркой, что «устройства с размером страницы 16 КБ в среднем используют немного больше памяти». Срок обязательной поддержки в Google Play — из тех фактов, что стареют быстрее статьи, и его стоит сверять с документацией, а не с пересказами: на сентябрь 2026 года она называет 1 февраля 2027-го как момент, после которого обновление без поддержки 16 КиБ опубликовать не выйдет. На серверах ARM живёт третья точка: в RHEL 9 на aarch64 стандартным идёт ядро с 4 КиБ, а 64 КиБ вынесены в отдельный пакет kernel-64k, устанавливаемый только через Kickstart. Довод в пользу 4 КиБ Red Hat строит не от страницы, а от машины: их рекомендуют «для более эффективного расходования памяти в небольших окружениях» — edge и дешёвых облачных экземплярах, — где «наращивание физической памяти системы непрактично из-за ограничений по месту, питанию и цене». То есть 4 КиБ выбраны там, где памяти мало и добавить её нельзя, а не потому, что 64 КиБ плохи: тот же документ отдаёт им большие базы данных, HPC и высокую сетевую нагрузку. Это выбор в обе стороны.
Почему же 4 КиБ дожили? Не потому, что число удачное, а потому, что оно утекло в ABI. Размер страницы виден программе всюду, где есть отображение файла со смещением, выравнивание сегментов в ELF, mmap с MAP_FIXED, аллокатор, зашивший константу. Показательно, чем на самом деле является миграция Android на 16 КиБ: работы там не в ядре, а в том, чтобы пересобрать всю нативную часть приложений с правильным выравниванием сегментов. Ядро переключается флагом конфигурации; экосистема — годами.
Для автора своей ОС отсюда следует ровно одно, но раннее решение: размер страницы выбирается до того, как написан загрузчик программ, потому что он попадает в формат исполняемых файлов и в правила выравнивания, а поменять его потом — значит поменять ABI. Всё остальное — единицы аллокатора, число уровней, охват TLB — подстраивается механически.
Что именно выбрать, решает один вопрос: собираетесь ли вы исполнять чужие бинарники. Если да — 4 КиБ, и обсуждать нечего: на x86-64 другого базового размера просто нет, а на ARM64 под 4 КиБ выравнено всё, что собрано для распространённых дистрибутивов, и миграция Android показывает, чего стоит переучивать экосистему. Если нет — 16 КиБ. Из трёх работающих точек это лучшая: вчетверо меньше дескрипторов кадров и вчетверо больший охват TLB против 4 КиБ, а внутренняя фрагментация вчетверо мягче, чем у 64 КиБ, при котором тысяча стобайтных файлов стоит уже 64 МиБ. 64 КиБ окупаются на одном классе нагрузок — большие непрерывные рабочие множества — и потому годятся как вариант под задачу, а не как умолчание; ровно поэтому у Red Hat они и оформлены отдельным ядром.
Вердикт для своей ОС
Свести всё в один список стоит по признаку «где выбор есть, а где его нет».
Выбора нет в организации таблиц (дерево, и только дерево), в формате записи, в разбиении адреса на индексы, в том, кто обходит таблицы, и в необходимости инвалидации при изменении живого отображения. Всё это надо просто реализовать под целевую архитектуру и не пытаться улучшить.
Выбор есть, и вот он, с рекомендациями. Разрядность: берите минимальную из достаточных — Sv39 на RISC-V, три или четыре уровня на ARM64, четырёхуровневый режим на x86-64, потому что каждый лишний уровень оплачивается на каждом промахе TLB. Гранула на ARM64: 4 КиБ, пока нет измерений в пользу другого; 64 КиБ выигрывает уровень обхода и охват TLB, но ломает совместимость с чужими бинарниками. Теги адресных пространств: включайте сразу, а не «потом», и на ARM64 с RISC-V это не оптимизация. На x86-64 без тегов каждое переключение контекста стоит сброса TLB, но код при этом верен; на тех двух запись корня не инвалидирует ничего, и альтернатива тегам — явная инвалидация на каждом переключении, иначе процесс получит чужие трансляции. И в том и в другом случае приделывать это к готовому коду переключения поздно. Инвалидация: с самого начала пишите её как операцию над множеством процессоров и диапазоном адресов, даже если сейчас процессор один, — иначе интерфейс придётся переделывать вместе со всеми вызовами. Большие страницы: блоки в карте ядра сразу, прозрачные в пользовательской памяти — сильно потом.
И одно решение, которое стоит принять раньше всех остальных: размер страницы. Он уходит в ABI, а ABI не переигрывается. 4 КиБ, если вам нужны чужие бинарники; 16 КиБ, если нет.
Дальше карта памяти ядра — куда именно кладётся ядро, есть ли окно прямого доступа ко всей физической памяти и во что обошлось возвращение раздельных таблиц после Meltdown; физическая память и задача раскрутки, где для построения первых таблиц нужна память, которую ещё нечем выделять; и включение трансляции при загрузке, где инструкция, включающая MMU, исполняется по адресу, обязанному быть осмысленным в обеих картах сразу. Порядок и состав — в плане цикла.
Источники
- Intel 64 and IA-32 Architectures Software Developer's Manual, Volume 3A (253668-092US, июнь 2026), глава 5 «Paging» — формат записей и их игнорируемые биты (табл. 5-20), биты обращения и записи (5.8) и оговорка про CET, PCID (5.10.1), глобальные страницы (5.10.2, подраздел «Global Pages»), кэши структур трансляции (5.10.3), права, набираемые вдоль всего пути обхода (5.6.1), VPID (5.11.2), инвалидация при
MOV to CR3и необязательная инвалидация при послаблении прав — для R/W безусловно, для U/S только приCR4.SMEP = 0— и при переводе P из 0 в 1 (5.10.4, подразделы «Operations that Invalidate TLBs and Paging-Structure Caches» и «Optional Invalidation») - 5-Level Paging and 5-Level EPT White Paper (335252-002) —
CR4.LA57, PML5, определения 48- и 57-битной каноничности - 5-level paging — документация ядра Linux — почему ядро не выдаёт адреса выше 47 бит без явной подсказки в
mmap - Arm Architecture Reference Manual for A-profile (DDI 0487M.c), глава D8 — выбор
TTBR0/TTBR1по биту 55 и отказ вне диапазонов (D8.2.4), FEAT_E0PD, поля дескриптора (табл. D8-52), иерархические атрибуты табличных дескрипторовAPTable/UXNTable/PXNTableи их отключение через FEAT_HPDS, косвенные права FEAT_S1PIE, аппаратное обновление AF и признака записи (D8.5), бит Contiguous и его размеры (табл. D8-104), промежуточные структуры кэширования TLB и отсутствие когерентности (D8.16, D8.17) - Learn the architecture — AArch64 memory management (Arm 101811, редакция 0105_00, сентябрь 2025) — гранулы и размеры блоков по уровням, начальный уровень обхода, ASID и nG как способ обойтись без инвалидации TLB при переключении контекста, последовательность Break-Before-Make и FEAT_BBM, домены инвалидации FEAT_TLBID, замечание про отсутствие 52-битных VA у Cortex-A
- RISC-V Privileged Architecture, глава «Supervisor-Level ISA» (ратифицированная редакция v20260120) —
satpи отсутствие какой-либо инвалидации при его записи, требование знакового расширения для Sv39/Sv48/Sv57, кодирование прав и приём сV=0, зарезервированные биты D, A и U у нелистовых записей, выравнивание суперстраницы по её размеру, Svade и Svadu, Svnapot, Svinval, Svvptc,sfence.vma, обоснование ставки на аппаратный обходчик - RVA23 Profiles, версия 1.0 — в RVA23S64 обязательны Sv39, Svade, Svinval и Svnapot; Sv48, Sv57, Svadu и Svvptc — расширяющие опции
- A Look at Several Memory Management Units, TLB-Refill Mechanisms, and Page Table Organizations (Jacob, Mudge, ASPLOS '98) — сравнение иерархических и обратных таблиц на аппаратных и программных TLB, устройство хеш-таблицы PA-RISC, текст обработчика промаха на MIPS
- Translation Caching: Skip, Don't Walk (the Page Table) (Barr, Cox, Rixner, ISCA '10) — систематический разбор кэшей промежуточных уровней и вывод в пользу кэшей частичных трансляций
- Intel Itanium Architecture Software Developer's Manual, Volume 2: System Architecture (ред. 2.1) — VHPT в коротком и длинном форматах, необязательность обходчика и требование быть готовым к промаху TLB
- Accelerating Two-Dimensional Page Walks for Virtualized Systems (Bhargava et al., ASPLOS '08) — формула
nm + n + mи 24 обращения при четырёх уровнях в обеих ступенях - POWER9 Processor User's Manual (OpenPOWER, версия 2.1) — сосуществование хеш-таблицы и радиксной трансляции и устройство Radix Page Walk Cache
- Page Table Isolation (PTI) — документация ядра Linux — раздельные наборы таблиц, отключение глобальных страниц, оценка потерь
- Transparent Hugepage Support — документация ядра Linux — режимы
always/madvise/never, настройкаdefragи её обоснование, многоразмерные прозрачные страницы - Исходники ядра Linux:
arch/x86/include/asm/tlbflush.h—TLB_NR_DYN_ASIDSи комментарий про шесть тегов;arch/x86/mm/tlb.c— бит PCID, съедаемый KPTI, и класс глобальных ASID;arch/x86/include/asm/tlb.h— семантикаINVLPGBиTLBSYNC;arch/arm64/mm/context.c— 8 или 16 бит ASID и распределитель с поколениями;arch/arm64/Kconfig—UNMAP_KERNEL_AT_EL0с трамплином в таблице векторов иARM64_E0PDс формулировкой про «схожие с KPTI преимущества для KASLR»;arch/arm64/kernel/cpufeature.c— решение о KPTI поCSV3, списку безопасных моделей и принудительное включение при KASLR без E0PD (kaslr_requires_kpti());arch/x86/mm/pkeys.c—__execute_only_pkey()иPKEY_DISABLE_ACCESSпод execute-only;arch/riscv/mm/tlbflush.cиarch/riscv/kernel/sbi-ipi.c— выбор междуsbi_remote_sfence_vma_asid()иon_each_cpu_mask()по ключуriscv_use_sbi_for_rfence();arch/x86/Kconfig—HAVE_ARCH_TRANSPARENT_HUGEPAGE_PUDна x86_64. ПоддержкаINVLPGBотсутствует вv6.14и присутствует вv6.15 - AMD broadcast TLB invalidation — LWN.net — что решает широковещательная инвалидация
- PATCH v11 00/12 AMD broadcast TLB invalidation — сопроводительное письмо серии — доля инвалидации TLB, упавшая с 40 % до примерно 4 %, и цифры теста на 36-ядерной Milan
- RISC-V Supervisor Binary Interface Specification — расширение RFENCE и
sbi_remote_sfence_vma - Support 16 KB page sizes — Android Developers — измерения загрузки и запуска приложений, оговорка про расход памяти, срок 1 февраля 2027 года
- The 64k page size kernel — документация Red Hat Enterprise Linux 9 — стандартное ядро с 4 КиБ на aarch64, отдельный пакет
kernel-64kи установка его только через Kickstart, довод про непрактичность наращивания физической памяти в небольших окружениях, нагрузки в пользу 64 КиБ - XNU,
osfmk/arm64/proc_reg.h—__ARM_16K_PG__иARM_PGSHIFT 14 - Addressing architectural differences in your macOS code — Apple Developer — указание не зашивать размер страницы в код, а читать
vm_page_sizeв рантайме - xv6-riscv,
kernel/riscv.h— Sv39 иMAXVAна бит меньше разрешённого, чтобы не расширять адреса знаком
Связанные заметки
- Адресное пространство: зачем трансляция и какие есть альтернативы — первая статья цикла: зачем трансляция нужна и чем её пытались заменить; здесь разобрано, как она устроена
- Устройство ОС — план цикла статей — состав и порядок цикла; карта памяти ядра, физическая память и загрузка опираются на введённые здесь понятия
- Linux — справочник команд: память — наблюдаемая сторона тех же механизмов на живой системе Linux
- Локальный инференс LLM: движки, квантование, бюджет памяти — PagedAttention как прямой перенос страничной идеи в другую область: блочный пул, таблица отображения, вытеснение
- Linux — ядро: сборка, модули, параметры — параметрами загрузки задаются и режим трансляции, и поведение больших страниц
- Стеки: ядра, прерываний, пользовательские — четвёртая статья цикла: отказ страницы, который нельзя обработать, потому что кончился стек
- Ядро как программа: freestanding, компоновка, ABI, выбор языка — права в записи таблицы со стороны сборки: выравнивание секций и момент включения прав
- Карта памяти ядра: половины, прямое отображение, KASLR — третья статья цикла: что именно кладут в карту, построенную этими таблицами, и во что обошлось раздельное отображение после Meltdown
- Вход в ядро и переключение контекста — седьмая статья цикла: где теги адресных пространств и инвалидация превращаются в стоимость переключения контекста
- Физическая память: от карты firmware до аллокатора — пятая статья цикла: откуда берутся кадры под эти таблицы, чем платят за дескриптор на кадр и как добывают непрерывный диапазон под большую страницу
- Загрузка: от питания до первой инструкции ядра — шестая статья цикла: момент включения трансляции и то, как число корней меняет цену переходного отображения
- Структура ядра: монолит, микроядро и что между — девятая статья цикла: почему теги адресных пространств для микроядра важнее, чем для монолита
Из библиотеки института уносят только знания. Читателей здесь не считают: посещение не регистрируется, отметок в издании не остаётся, счётчиков нет ни у одного издания фонда.
Издание пополняется и пересверяется. Текст доступен на условиях CC BY-SA 4.0 — унесённое можно передавать дальше на тех же условиях.