Единственный код, который нельзя отладить
Загрузка — та часть операционной системы, к которой не применимы привычные средства. Печатать некуда, отладчик не подключён, память под его структуры не выделена, а половина кода исполняется в режиме, в который система больше никогда не вернётся. Поэтому раннюю загрузку принято брать целиком из чужого проекта и не трогать: она работает, а разбираться в ней дорого. Цена такого решения выясняется позже — когда что-то ломается, и оказывается, что чинить нужно ровно тот код, который никто не читал.
При этом именно здесь принимаются решения, которые дальше не переигрываются. Какой протокол загрузки — от этого зависит, в каком состоянии машина окажется в первой инструкции ядра и сколько ранней работы придётся написать самому. В каком режиме привилегий ядро оказалось — на двух архитектурах из трёх это не самый высокий уровень, и часть операций, которые на x86 ядро делает само, превращается в запрос к прошивке. Что уже отображено к моменту входа — от этого зависит, можно ли вообще исполнить следующую инструкцию после включения трансляции.
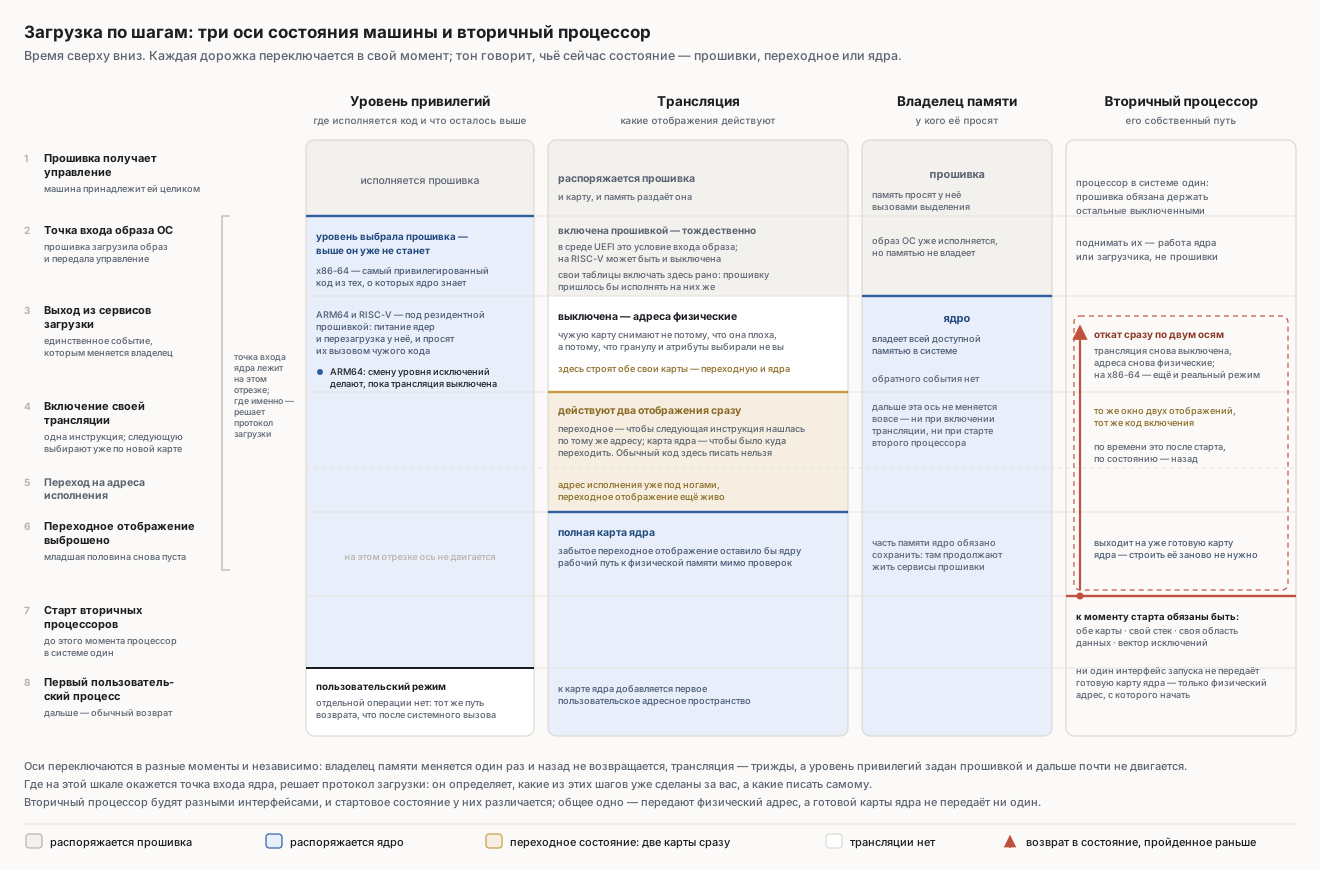
Статья разбирает эту последовательность как последовательность: что делает прошивка, что от неё остаётся, чем протоколы загрузки различаются по объёму взятой на себя работы, как включают трансляцию, как поднимают остальные процессоры и как ядро отдаёт управление первому пользовательскому процессу. Границы с соседями по циклу проведены по содержанию, а не по времени. Карту памяти от прошивки и раскрутку аллокатора разбирает пятая статья — здесь только то, откуда карта берётся и в каком виде приходит. Различие адреса загрузки и адреса исполнения, скрипт компоновки и модели кода — восьмая; здесь разбирается момент, в который ранний код перестаёт пользоваться первым и начинает пользоваться вторым. Куда прыгать — третья; здесь — как. Устройство входа в ядро и путь возврата — седьмая. Наконец, про эту же цепочку со стороны администратора — про загрузчики, порядок загрузки, обновление ядра и цепочку доверия в дистрибутиве — есть отдельная заметка, и жанр там другой: там настраивают то, что здесь устроено.
Прошивка: что она делает и что от неё остаётся
UEFI — не «новый BIOS», а среда исполнения
Разница между BIOS и UEFI обычно излагается как список возможностей: GPT вместо MBR, диски больше двух терабайт, графическое меню. Всё это верно и всё это следствия. Существенно другое: UEFI — не набор функций, вызываемых прерыванием, а полноценная среда исполнения программ со своим форматом исполняемых файлов, своим загрузчиком образов, своим соглашением о вызовах и своими правилами владения памятью.
Формат назван в спецификации прямо: «UEFI использует подмножество формата образов PE32+ с изменённой сигнатурой заголовка». Тип образа задаётся полем Subsystem, и от него зависят две вещи — в память какого типа прошивка загрузит образ и что произойдёт, когда точка входа вернёт управление: приложение выгружается всегда, драйвер — только если вернул ошибку. Загружает образ сервис LoadImage(), который «обязан загрузить в память все секции образа PE32+», применить перемещения и передать управление по AddressOfEntryPoint. То есть прошивка содержит внутри себя динамический загрузчик — ровно то, чего в freestanding-окружении из восьмой статьи нет.
Среда исполнения описана спецификацией отдельно для каждой архитектуры, и три из них дают три разных исходных состояния, которые полезно знать до того, как писать свой EFI-образ:
| x86-64 | AArch64 | RISC-V | |
|---|---|---|---|
| Режим | длинный, 64-битный | наивысший небезопасный EL: EL2 или EL1 | S-режим (HS, если есть расширение гипервизора и это не гость) |
| Трансляция | включена, вся память из карты отображена тождественно | MMU включён, тождественное отображение, гранула 4 КиБ, только TTBR0 |
может быть включена; если включена — тождественно |
| Прерывания | разрешены; из служб — только таймер сервисов загрузки | то же, плюс все прерывания UEFI направлены только на вектор IRQ | разрешены; из служб — только таймер сервисов загрузки |
| Стек | не меньше 128 КиБ, выравнивание 16 байт | не меньше 128 КиБ, выравнивание 16 байт | не меньше 128 КиБ, выравнивание 16 байт |
| Аргументы точки входа | RCX — дескриптор образа, RDX — системная таблица |
X0, X1 |
a0, a1 |
| Процессоры | один: «однопроцессорный режим» со ссылкой на руководство Intel | один; остальные выключены или удержаны в покое | один; остальные выключены или удержаны в покое |
Две строки этой таблицы стоят больше остальных. Первая: трансляция при входе в UEFI-приложение уже включена, так что расхожее «прошивка отдаёт машину с выключенным страничным преобразованием» описывает наследие x86, а не прошивку вообще. Вторая: спецификация обязывает прошивку исполняться на одном процессоре — причём в разделах про AArch64 и RISC-V прямо сказано, что остальные обязаны быть выключены или удержаны в покое, а раздел про x86-64 ограничивается словом «однопроцессорный» со ссылкой на руководство Intel. То есть многопроцессорность на этом этапе не существует, и весь подъём остальных ядер — работа ядра или загрузчика, а не прошивки.
Соглашение о вызовах на x86-64 при этом не System V, а майкрософтовское: первые четыре целочисленных аргумента в RCX, RDX, R8, R9, теневая область на стеке, другой набор энергонезависимых регистров. Ядро, которое собирается быть UEFI-приложением, обязано собирать хотя бы точку входа под этот ABI.
Отдельная тонкость касается тех, кто хочет включить свои таблицы страниц ещё до выхода из сервисов загрузки. Спецификация это разрешает, но с условием, которое обесценивает затею: «если UEFI-приложение пользуется собственными таблицами страниц, GDT или IDT, приложение обязано обеспечить, чтобы прошивка исполнялась с каждой подменённой структурой данных». Прошивка может получить управление двумя путями — по явному вызову и по вытеснению приложения таймерным событием, — так что альтернативную среду придётся восстанавливать вокруг каждого вызова и либо запрещать прерывания, либо перехватывать их и восстанавливать окружение перед вызовом обработчика прошивки. Практический вывод: свою карту памяти включают после выхода из сервисов загрузки, а не до.
ExitBootServices: момент смены владельца
Вызов ExitBootServices() — не «выключение прошивки», а передача владения. До него памятью распоряжается прошивка, и всякий образ обязан просить её вызовами выделения; после него, как говорит спецификация, «загрузчик ОС владеет всей доступной памятью в системе». Разбор карты памяти и типов регионов — материал пятой статьи, здесь важна другая половина того же события: что происходит со средой исполнения.
Умирают сервисы загрузки целиком: никаких дальнейших вызовов ни к ним, ни к протоколам, привязанным к дескрипторам устройств. Отключается сторожевой таймер. Несколько полей системной таблицы — консольный ввод, консольный вывод, поток ошибок и указатель на таблицу сервисов загрузки — обнуляются, а контрольная сумма таблицы пересчитывается. Прошивка сначала оповещает зарегистрированные обработчики двух групп событий, потом останавливает таймерные службы. Прямое следствие записано отдельной строкой в разделах и про AArch64, и про RISC-V: «после того как загрузчик ОС вызвал ExitBootServices(), ему следует немедленно настроить вектор исключений на подходящий код» — потому что обработчиков прошивки больше нет, а исключения никуда не делись.
Выживают сервисы времени исполнения: переменные прошивки, часы реального времени, перезагрузка, обновление капсулами. Они продолжают работать в памяти, которую ядро обязано сохранить, и работают по физическим адресам — пока ядро не вызовет SetVirtualAddressMap(). Этот вызов переселяет сервисы времени исполнения в виртуальное пространство ядра: прошивка оповещает свои компоненты, заново применяет перемещения к образам сервисов и переводит указатели в таблицах. Ограничение у него жёсткое и стоит того, чтобы его запомнить: «виртуальная карта адресов может быть применена только один раз», повторный вызов отвечает EFI_UNSUPPORTED. Ошиблись картой — исправлять негде.
Что остаётся: три модели резидентной прошивки
Дальше начинается расхождение между архитектурами, и оно глубже, чем разница в интерфейсах.
На x86-64 после выхода из сервисов загрузки от прошивки остаются сервисы времени исполнения — и всё, что видно операционной системе. Резидентный код более высоких полномочий на самом деле есть: режим управления системой (SMM) устроен именно так — по системному прерыванию процессор сохраняет контекст, переключается в отдельное адресное пространство и исполняет код прошивки в области SMRAM. Но спецификация описывает его как среду, работающую «прозрачно для операционной системы», предназначенную «только для системной прошивки, а не для прикладных программ и не для системного программного обеспечения общего назначения». То есть это не интерфейс: попросить у него ничего нельзя, и в модели ядра его нет.
На ARM64 всё наоборот: резидентная прошивка — это именно интерфейс. Цепочка загрузки Trusted Firmware-A состоит из стадий, и одна из них не заканчивается. BL1 в ПЗУ и BL2 загружают образы; BL31 остаётся в EL3 навсегда и обслуживает вызовы SMC, а «одна из служб времени исполнения, которые инициализирует BL31, — это PSCI»; BL33 — «недоверенная прошивка», то есть U-Boot или реализация UEFI, и BL31 «переходит к образу недоверенной прошивки на наивысшем доступном уровне исключений». Граница между двумя вариантами BL33 при этом размыта: U-Boot несёт собственную реализацию UEFI, намеренно неполную — он целится в требования EBBR, а «полноценная реализация UEFI противоречила бы принципу U-Boot „keep it small“». Ядро оказывается не на вершине: над ним живёт монитор, у которого спрашивают про питание процессоров и перезагрузку.
На RISC-V эта идея доведена до конца и стандартизована. Процессор имеет три режима — машинный, супервизорный и пользовательский; прошивка живёт в машинном режиме постоянно, а интерфейс к ней называется SBI и определён отдельной спецификацией. Формулировка спецификации точная: SBI «позволяет программам супервизорного режима быть переносимыми между всеми реализациями RISC-V, определяя абстракцию над функциональностью, специфичной для платформы», а слой, предоставляющий этот интерфейс, называется средой исполнения супервизора и может быть либо «прошивкой времени исполнения платформы, исполняющейся в машинном режиме», либо гипервизором. OpenSBI — эталонная реализация; собирается она тремя способами, и различие между ними — про то, кто загружает следующую ступень: fw_jump знает только адрес следующего образа, fw_payload содержит его внутри себя, fw_dynamic получает описание следующей ступени от предыдущей через регистр. UEFI на RISC-V при этом сам исполняется в S-режиме, то есть оказывается не под прошивкой, а над ней — слоёв становится три.
Обобщение, ради которого это сравнение и приведено: на x86-64 ядро — самый привилегированный код в системе из тех, о которых оно знает, и всё делает само. На ARM64 и RISC-V часть операций, которые на x86 являются записью в регистр, превращается в вызов чужого кода с определённым ABI. Для автора своей ОС это означает конкретную развилку в архитектуре: слой «попросить платформу» либо есть с самого начала, либо появляется позже переписыванием всего, что этого слоя не предполагало.
Secure Boot: ограничение на то, что вы вообще можете загрузить
Проверка подписи в UEFI устроена как отношение владения платформой. Ключ платформы PK связывает владельца с прошивкой; пока PK не установлен, переменная SetupMode равна единице и прошивка «не требует аутентификации для изменения ключа платформы, ключей обмена, порядка восстановления ОС и баз данных безопасности образов». После установки PK система переходит в пользовательский режим и требует аутентификации на изменение тех же переменных. Есть ещё режим аудита, в котором проверка не отвергает образы, а только протоколирует, и режим развёртывания, выход из которого требует либо платформенного механизма, либо удаления PK.
Проверяются при этом образы, которые загружает сама прошивка, — то есть PE32+. Ядро своей ОС, загружаемое сторонним загрузчиком в формате ELF, прошивка не видит вовсе: цепочка доверия обрывается на загрузчике. Дальше это забота загрузчика, и решения бывают разные. Limine, например, требует, чтобы при активном Secure Boot к каждому пути файла в конфигурации был приписан хеш: «когда Secure Boot активен, у всех путей к файлам обязан быть приписан хеш, иначе Limine аварийно завершится». Хеш отличается по длине — 64 шестнадцатеричные цифры означают обычный BLAKE3, 128 — BLAKE2b, 256 — BLAKE3 с расширенным выходом. Исключение из «обязан» ровно одно, и о нём стоит знать: обои и шрифты без хеша не роняют загрузчик, а «молча пропускаются с откатом на умолчания». Редактор конфигурации при активном Secure Boot отключается безусловно.
Для того, кто пишет свою ОС, отсюда следуют три варианта и один вердикт. Первый — выключить Secure Boot в прошивке на время разработки; это правильный ответ по умолчанию, потому что цикл «пересобрал — перезагрузил» с подписью занимает в разы больше. Второй — сгенерировать свои PK, KEK и db и прошить их, переведя платформу из режима настройки в пользовательский; это осмысленно, когда система едет на конкретную машину и подпись нужна на самом деле. Третий — воспользоваться прослойкой shim и механизмом пользовательских ключей MOK; это путь дистрибутива, он описан со стороны администратора и для своей ОС только добавляет звено. Начинать стоит с первого и переходить ко второму, когда система дойдёт до состояния, в котором её ставят на железо всерьёз.
Протоколы загрузки
Multiboot: минимализм и его цена
Multiboot — самый старый из живых протоколов и самый прямолинейный. Первая версия, спецификация 0.6.96, требует от загрузчика передать управление в 32-битном защищённом режиме с магическим числом 0x2BADB002 в EAX и физическим адресом структуры с информацией в EBX. Multiboot2 (спецификация версии 2.0) отличается магическим числом 0x36d76289 и тем, что информация от загрузчика стала списком тегов вместо структуры с битовой маской, — состояние машины осталось прежним.
Состояние это стоит выписать, потому что оно и есть содержание протокола. Сегменты кода и данных — плоские, 32-битные. Бит PG в CR0 сброшен, бит PE установлен: трансляции нет, защищённый режим есть. Флаги VM и IF сброшены. Вентиль A20 открыт. Дальше идёт перечисление того, чего нет: «образ ОС обязан создать себе стек, как только он ему понадобится»; регистр таблицы дескрипторов «может быть недействителен, так что образ ОС не должен загружать ни одного сегментного регистра (даже перезагружая те же значения!), пока не построит собственную таблицу»; «образ ОС обязан держать прерывания запрещёнными, пока не построит собственную таблицу дескрипторов прерываний». И отдельной строкой: «на EFI-системе сервисы загрузки должны быть завершены».
Последнее предложение и есть цена. Машина, описанная этим протоколом, на EFI-платформе не существует: прошивка отдаёт длинный режим с включённой трансляцией, и чтобы получить 32-битный защищённый режим без трансляции, загрузчику приходится эту среду разобрать. У Multiboot2 есть теги для обратного случая — если образ объявит тег сервисов загрузки (тип 7) и тег точки входа для EFI (тип 8 или 9), загрузчик передаст управление, не завершая сервисы, и состояние машины будет тем, которое описывает UEFI. Но это уже другой протокол, замаскированный под тот же.
Второе ограничение Multiboot2 — размещение: «загрузчик не должен загружать ни одну часть ядра, модулей, структуры с информацией и прочего выше 4 ГиБ − 1», и причина названа честно — «большинство определённых на сегодня тегов поддерживают только 32-битные адреса».
Linux boot protocol: ядро, научившееся быть UEFI-приложением
Протокол загрузки Linux на x86 сложился исторически и сохраняет следы каждого этапа. Образ bzImage начинается с заголовка настройки по смещению 0x1f1, унаследованного от времён, когда ядро само было загрузочным сектором; версии протокола нумеруются с 2.00 и отражают тридцать лет изменений — от появления bzImage и initrd в 1.3.73 до kernel_info в 5.5. Загрузчик заполняет структуру boot_params, известную как «нулевая страница», и передаёт управление одной из трёх точек входа: 16-битной с реальным режимом, 32-битной («процессор обязан быть в 32-битном защищённом режиме с выключенной трансляцией») или 64-битной («процессор обязан быть в 64-битном режиме с включённой трансляцией», причём диапазон ядра, нулевая страница и буфер командной строки отображены тождественно).
Существеннее для темы то, что произошло дальше. Ядро научилось быть UEFI-приложением само — при сборке с CONFIG_EFI_STUB образ имеет заголовок PE/COFF и загружается прошивкой напрямую, без всякого загрузчика. У этого решения есть побочный выигрыш, который объясняет, зачем оно нужно, лучше любых рассуждений о простоте: заглушка умеет попросить у прошивки начальный диск через протокол EFI_LOAD_FILE2, и, как говорит документация, «этот подход снимает с EFI-загрузчика всякую необходимость знать про внутреннее представление boot_params и всякие требования и ограничения на размещение командной строки и образа начального диска в памяти, а также на размещение самого образа ядра». Загрузчик перестаёт быть частью контракта.
Здесь же лежит ловушка для тех, кто читает старые тексты. Промежуточное решение — протокол передачи EFI, при котором загрузчик прыгал в заглушку по смещению handover_offset, — в документации помечено как устаревшее: «протокол передачи EFI объявлен устаревшим в пользу обычной точки входа PE/COFF».
На ARM64 и RISC-V ничего похожего на bzImage нет, и требования выражены короче. Образ ARM64 начинается с 64-байтного заголовка, первые два слова которого — исполняемый код, ветвящийся к точке входа; при загрузке через EFI они пропускаются, а поле res5 содержит смещение до заголовка PE, и после работы заглушки управление возвращается на них. Условия входа перечислены списком, и среди них те, что определяют всю раннюю часть: «MMU обязан быть выключен»; диапазон адресов загруженного образа обязан быть очищен в кэшах до точки согласованности; процессор в небезопасном состоянии, «либо в EL2 (рекомендуется, чтобы иметь доступ к расширениям виртуализации), либо в EL1»; все прерывания замаскированы; x0 содержит физический адрес блоба дерева устройств, остальные три регистра нулевые; устройства, способные к прямому доступу в память, приведены в спокойное состояние — «это сэкономит вам много часов отладки». На RISC-V требования ещё короче: a0 — идентификатор текущего харта, a1 — адрес дерева устройств, satp = 0, то есть «MMU, если он есть, обязан быть выключен».
Limine: протокол, забирающий почти всю раннюю работу
Limine устроен от противоположной идеи: не «минимум обязательств», а «максимум готовности». Ядро получает управление уже в целевом режиме, с построенными таблицами страниц, отображённым образом, готовым стеком и приведённым в порядок контроллером прерываний.
Конкретно на x86-64 это 64-битный режим с загруженными селекторами, включёнными PG, PAE, LME и LMA, открытым вентилем A20, замаскированными прерываниями старых контроллеров и стеком не меньше 64 КиБ, на который перед прыжком положен заведомо неверный адрес возврата. На aarch64 — MMU включён, TTBR1_EL1 указывает на таблицы верхней половины, TCR_EL1.{T0SZ, T1SZ} выставлены под выбранное число уровней, все прерывания замаскированы; уровень исключений начиная с шестой базовой ревизии зависит от того, как отдала управление прошивка: «если загрузчик работает на EL2 и оборудование поддерживает VHE, образ входит на EL2 с включённым VHE, иначе на EL1; на EL2 без VHE образ не входит никогда», — а на ревизиях младше шестой «образ всегда входит на EL1». На riscv64 — супервизорный режим, satp настроен на выбранный режим трансляции, sie обнулён.
Поверх этого протокол даёт то, ради чего его чаще всего и берут: отображение всей полезной физической памяти в верхнюю половину (HHDM) и нормализованную карту памяти — обе вещи разобраны в пятой статье со стороны того, что с ними делать. Вторичные процессоры протокол тоже поднимает, но не по умолчанию: «наличие этого запроса побудит загрузчик поднять вторичные процессоры; без запроса этого сделано не будет». Поднятые процессоры паркуются, и освобождает их атомарная запись адреса в поле goto_address соответствующей структуры.
Версионирование здесь стоит отдельного слова, потому что на нём легко обжечься. Кроме версий отдельных запросов у протокола есть базовые ревизии, которых на дату сверки семь — с нулевой по шестую, — и ревизии с нулевой по пятую объявлены устаревшими. Ревизия, которую образ запрашивает, объявляется тегом в самом образе; нулевая считается умолчанием для тех, кто тега не поставил. Различия между ревизиями не косметические: тождественное отображение — оно начинается с 0x1000 и покрывает «4 ГиБ − 0x1000 и любой дополнительный регион карты» — существует только в нулевой ревизии, а начиная с третьей безусловное прямое отображение снято и в верхнюю половину попадают только регионы разрешённых типов. Туториал, написанный под старую ревизию и предполагающий тождественное отображение, на новой просто не заработает. Скорость изменений тут стоит иметь в виду отдельно: стабильным выпуском на дату сверки была версия 12.8.0 от 5 сентября 2026 года, а предыдущие девять выпусков уместились в предшествовавшие ей десять недель. Любое утверждение про Limine, включая приведённые здесь, стоит сверять с протоколом, а не с текстом чужого возраста.
Что каждый протокол берёт на себя
| Multiboot2 | Linux (EFI stub) | Limine | UEFI-приложение своими руками | |
|---|---|---|---|---|
| Формат образа | ELF или свой заголовок с адресами | PE32+ поверх образа ядра | любой, рекомендован ELF | PE32+ |
| Режим при входе | 32-битный защищённый, трансляции нет | среда UEFI (см. таблицу выше) | целевой: 64 бита, EL1/EL2, S-режим | среда UEFI |
| Таблицы страниц | нет | тождественные, от прошивки | построены, образ в верхней половине, HHDM | тождественные, от прошивки |
| Стек | нет | от прошивки, ≥ 128 КиБ | ≥ 64 КиБ, настраивается | от прошивки, ≥ 128 КиБ |
| Карта памяти | сырой тег, без сортировки и слияния | карта UEFI как есть | нормализованная | карта UEFI как есть |
| Вторичные процессоры | нет | нет | по запросу | нет |
| Сервисы загрузки | завершены (кроме варианта с тегом 7) | ваш вызов и ваш момент | завершены | ваш вызов и ваш момент |
| Что писать самому | переход в длинный режим, таблицы, карта, SMP | всё после ExitBootServices() |
почти ничего | всё, включая загрузку своих файлов |
Вердикт: что выбрать
Компромисс здесь неудобный, и уклоняться от него бесполезно: Limine снимает почти всю раннюю работу, но ровно эту работу автор учебной ОС и хотел понять. Multiboot2 оставляет её себе, но платит тем, что описывает машину, которой на современном железе нет, и требует от загрузчика разобрать среду прошивки, чтобы эту машину получить.
Ответ зависит от того, что является целью проекта, и это не уклонение — из двух целей следуют два разных решения.
Если цель — понять устройство ОС и целевая архитектура x86, берите Multiboot2 через GRUB и пишите переход в длинный режим сами. Вы напишете сотню строк ассемблера, разберётесь в тождественном отображении на практике, а не по описанию, и получите работающую конструкцию, которую сможете чинить. Разбор карты памяти при этом придётся написать ровно тот же, что и для карты от прошивки: гарантий Multiboot2 не даёт никаких, и почему — разобрано в пятой статье.
На ARM64 и RISC-V первой опции нет: Multiboot2 этих архитектур не знает, а Limine и собственное UEFI-приложение снимают ровно ту работу, которую вы хотели проделать. Роль «минимального протокола» там играет собственный протокол архитектуры — сырой Image или ELF, отданный QEMU через -kernel. Условия входа при этом те же, что разобраны выше по документации ядра, а эмулятор берёт на себя только загрузку образа и передачу адреса дерева устройств: на aarch64 не-ELF образ грузится по протоколу ядра с адресом дерева в x0, а для ELF дерево лежит в начале ОЗУ; на riscv64 роль прошивки играет OpenSBI, подставляемый по умолчанию как -bios, и образ получает управление в S-режиме. Ранней работы здесь не меньше, чем под Multiboot2, а отлаживается она в том же QEMU.
Если цель — написать ОС, то есть добраться до планировщика, драйверов и пользовательского пространства, берите Limine и объявляйте свежую базовую ревизию. Ранняя загрузка — это не то, на чём стоит потратить первый месяц, а HHDM и нормализованная карта экономят ещё неделю.
Третий вариант — собирать ядро как UEFI-приложение — выглядит соблазнительно и заслуживает предупреждения. Он снимает загрузчик, но взамен требует писать код под чужой ABI, разбирать протоколы для чтения своих же файлов и вручную вести дисциплину «до ExitBootServices() можно одно, после — другое». Это разумный выбор для системы, которая уже работает и хочет избавиться от звена; плохая отправная точка для новой.
Отдельно: выбор протокола влияет на переносимость меньше, чем кажется. Multiboot2 нацелен на ПК — спецификация говорит об этом прямо и определяет ровно две архитектуры, 32-битный x86 и 32-битный MIPS, — а Limine покрывает все три архитектуры цикла паритетно, а собственное UEFI-приложение переносимо ровно настолько, насколько переносим ваш код точки входа. Если паритет архитектур в планах есть, это довод против Multiboot2, и довод сильный.
Включение трансляции
Задача целиком
Сформулируем задачу отдельно от архитектур, потому что в таком виде она одна и та же.
Инструкция, включающая трансляцию, исполняется по какому-то адресу. После её выполнения счётчик команд увеличивается — и обязан указывать на что-то осмысленное уже в новой карте. Если новая карта не содержит отображения для адреса следующей инструкции, процессору неоткуда будет взять следующую инструкцию, и произойдёт это в состоянии, где обработчиков исключений ещё нет.
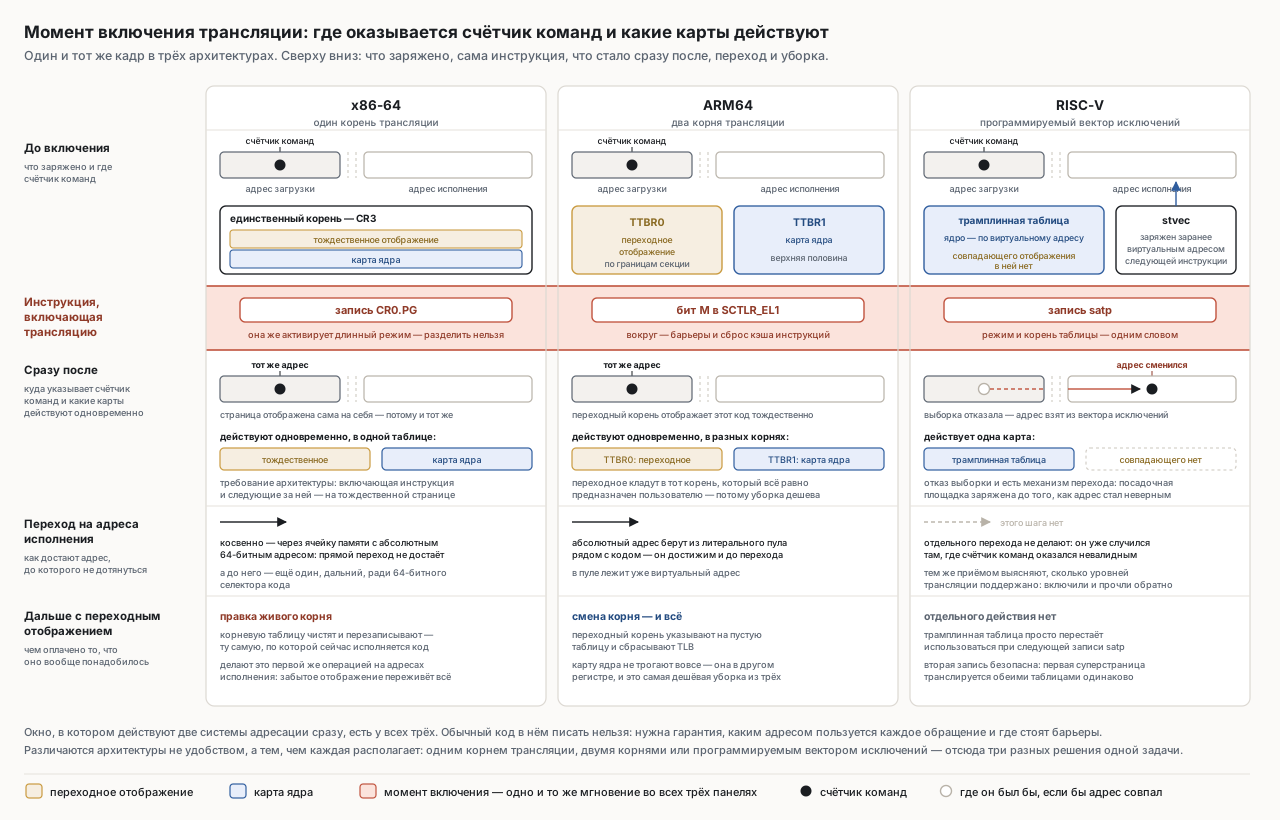
Отсюда три подзадачи, которые решаются по отдельности и в этом порядке. Первая: обеспечить, чтобы код, включающий трансляцию, продолжил исполняться после неё, — то есть построить переходное отображение. Вторая: перейти с этого адреса на адрес исполнения, под который ядро скомпоновано, — тот самый переход между адресом загрузки и адресом исполнения, момент которого восьмая статья отнесла сюда. Третья: избавиться от переходного отображения, как только оно перестало быть нужным.
«Переходное отображение» здесь и дальше означает роль, а не приём: это вторая карта, живущая только на время переключения. Самая распространённая её реализация — тождественное отображение, при котором код доступен по одному и тому же адресу до и после, но совпадающие адреса для этой роли не обязательны, и RISC-V ниже обходится без них. От реализации зависит и то, чем кончается третья подзадача: тождественное отображение приходится выбрасывать явным действием, потому что иначе оно оставит коду ядра доступ к младшим адресам, которых в готовой карте быть не должно; там, где совпадающих адресов нет, переходная карта просто перестаёт использоваться.
x86-64: три режима подряд
На x86-64 задача осложнена тем, что переход в длинный режим и включение трансляции — не два независимых действия, а одно. Последовательность записана в руководстве Intel и состоит из пяти шагов: выключить трансляцию, включить расширение физических адресов (CR4.PAE), загрузить CR3 физическим адресом корневой таблицы, установить IA32_EFER.LME, включить трансляцию установкой CR0.PG. Пятый шаг и активирует длинный режим: «это заставляет процессор установить бит IA32_EFER.LMA в единицу». Разделить их нельзя по построению: LME — это разрешение, а не включение, а без PAE попытка инициализировать длинный режим даёт #GP.
Требование к отображению записано там же и дословно: «инструкция MOV CR0, включающая трансляцию, и следующие за ней инструкции обязаны находиться на тождественно отображённой странице (до тех пор, пока не окажется возможным переход на нетождественно отображённые страницы)». Из того же места следует ограничение, которое объясняет, почему ранние таблицы кладут вниз: «таблицы страниц 64-битного режима обязаны находиться в первых 4 ГиБ физического адресного пространства до активации режима IA-32e», потому что MOV CR3 исполняется ещё в защищённом режиме и пишет только младшие 32 бита.
Дальше — второй переход, про который забывают. После установки CR0.PG процессор находится в длинном режиме, но в режиме совместимости: селектор кода остался 32-битным. Комментарий в ядре Linux описывает это точно: «когда переход выполнен, мы будем в длинном режиме, но в 32-битном режиме совместимости с EFER.LME = 1, CS.L = 0, CS.D = 1 (и, соответственно, EFER.LMA = 1); чтобы прыгнуть в 64-битный режим, мы пользуемся новыми GDT и IDT, где у __KERNEL_CS установлен CS.L = 1». Загрузить CS обычной записью нельзя — нужен дальний переход, и его собирают вручную, кладя селектор и адрес на стек и делая lret.
Минимальный вариант всей последовательности выглядит так. Фрагмент предполагает, что ранняя секция скомпонована по адресу загрузки — то есть что символы в ней и есть физические адреса; как это выражается в скрипте компоновки, разобрано в восьмой статье. И ещё одно требование, которое руководство проговаривает только про код, а стоит проговорить и про данные: в переходной карте обязана быть отображена не только страница с включающей инструкцией, но и страница стека. lret читает оба положенных на стек слова уже после установки CR0.PG, и если стек в новой карте не виден, машина встанет ровно на той инструкции, которая должна была завершить переход.
        # первого шага руководства — сбросить CR0.PG — здесь нет:
        # Multiboot2 отдаёт машину с уже выключенной трансляцией
        mov     %cr4, %eax
        or      $(1 << 5), %eax         # CR4.PAE
        mov     %eax, %cr4

        # ecx уже содержит физический адрес корневой таблицы (PML4),
        # в которой отображены сами на себя и страница с этим кодом,
        # и страница стека
        mov     %ecx, %cr3

        mov     $0xc0000080, %ecx       # IA32_EFER
        rdmsr
        or      $(1 << 8), %eax         # EFER.LME
        wrmsr

        pushl   $0x08                   # селектор 64-битного кода
        pushl   $long_mode_entry
        mov     %cr0, %eax
        or      $(1 << 31), %eax        # CR0.PG — здесь LMA становится 1
        mov     %eax, %cr0
        lret                            # дальний переход: CS.L = 1
Третий шаг — переход в верхнюю половину. Прямой переход jmp rel32 туда не достаёт: смещение 32-битное и знаковое, а расстояние измеряется терабайтами. Поэтому переход делают косвенным, через слот памяти с абсолютным 64-битным адресом. В ядре Linux это буквально две строки — комментарий «переход к общему стартовому коду по его виртуальному адресу ядра», инструкция jmp *.Lcommon_startup_64(%rip) и рядом восьмибайтовая ячейка с адресом. Почему так, а не иначе, следует из моделей кода, разобранных в восьмой статье.
Выбрасывают тождественное отображение отдельным действием, и на x86-64 это правка единственного корня. В Linux она стоит первой строкой первой же функции, исполняющейся по виртуальным адресам, и подписана комментарием «убить тождественно отображающий трамплин»: корневая таблица очищается целиком, кроме последней записи, а CR3 перезаписывается.
Пятиуровневая трансляция добавляет к этому сюжет, который стоит знать заранее. Переключить число уровней в длинном режиме нельзя — комментарий в ядре объясняет, что «установка или сброс CR4.LA57 в длинном режиме вызовет #GP», так что «нужно сначала выключить длинный режим и трансляцию». А для этого нужен трамплин в младшей памяти, «поскольку у нас нет способа загрузить 64-битное значение в CR3 в 32-битном режиме». То есть даже ядро, которое загрузчик передал уже в длинном режиме, может быть вынуждено выйти из него и вернуться обратно — и это тот же самый механизм переходного отображения, только на два шага позже.
ARM64: спуск по уровням и секция, которая обязана быть отображена
На ARM64 к задаче добавляется уровень исключений. Ядро может получить управление на EL2 или на EL1, и это не деталь: набор регистров, которые надо настроить, зависит от уровня. Linux решает это так, что решение стоит перенять целиком, — функция init_kernel_el смотрит на CurrentEL и в обоих случаях завершается инструкцией eret, но с разными настройками: с EL1 она возвращается сама в себя с выключенным MMU, а с EL2 сначала настраивает EL2 и потом спускается на EL1. Возврат наверх, если ядро хочет работать на EL2 с VHE, происходит отдельным шагом позже и требует, чтобы MMU был выключен, — проверка в коде так и подписана: «санитарная проверка: MMU обязан быть выключен». Требование симметрично, просто записано в разных местах: вверх — этой проверкой, вниз — условием входа в ядро («MMU обязан быть выключен»), которое eret из init_kernel_el и соблюдает. Причина одна: режим трансляции принадлежит уровню исключений, а не процессору, так что настроенная на одном уровне карта на другом ничего не значит.
Если прошивка была UEFI, MMU при входе уже включён, и первое, что делает ядро, — выключает его. Условие входа в ядро Linux сформулировано именно так, безусловно: «MMU обязан быть выключен». Причина не в том, что чужое отображение плохое, а в том, что оно чужое: его атрибуты, гранула и разрядность выбраны прошивкой, и продолжать на нём — значит зависеть от того, чего не контролируешь.
Дальше идёт настройка: MAIR_EL1 задаёт типы памяти, TCR_EL1 — разрядность обеих половин, гранулу, разделяемость и политику кэширования, TTBR0_EL1 получает корень переходного отображения, TTBR1_EL1 — корень карты ядра. Включение — установка бита M в SCTLR_EL1, и вокруг него нужны барьеры, потому что запись в системный регистр не влияет на уже выбранные инструкции. Макрос в ядре Linux показывает минимальный набор: запись, isb, инвалидация локального кэша инструкций, dsb nsh, ещё isb. Инвалидация здесь не перестраховка — комментарий объясняет, зачем: «инвалидировать локальный кэш инструкций, чтобы отбросить инструкции, спекулятивно выбранные до точки согласованности, поскольку они могли быть динамически пропатчены на уровне точки унификации».
Самое интересное — как обеспечивается непрерывность исполнения, и ответ здесь организационный, а не архитектурный. Функция __enable_mmu объявлена в собственной секции .idmap.text, а в комментарии над ней записано требование: «возвращает управление вызывающему через x30/lr; это требует, чтобы вызывающий тоже был покрыт секцией .idmap.text». То есть переходное отображение строится не «вокруг какого-то адреса», а вокруг именованной секции: компоновщик собирает её в одном месте, а код построения ранних таблиц отображает её целиком и тождественно. Условие «код, включающий MMU, обязан быть отображён по одному и тому же адресу до и после» превращается в свойство скрипта компоновки, которое можно проверить глазами.
Переход к адресу исполнения делается тем же приёмом, что на x86-64, — через абсолютный адрес, только вместо слота в памяти это литерал: ldr x8, =__primary_switched и br x8. Пул литералов лежит рядом с кодом и потому достижим до перехода, а значение в нём — уже виртуальный адрес.
Выбрасывание переходного отображения на ARM64 обходится дешевле, чем везде, и по причине, разобранной во второй статье: корней два. Функция cpu_uninstall_idmap() просто указывает TTBR0_EL1 на зарезервированную пустую таблицу и сбрасывает TLB. Карту ядра при этом трогать не нужно вовсе — она в другом регистре. На x86-64 и RISC-V то же действие означает правку той самой таблицы, по которой сейчас исполняется код.
RISC-V: вектор прерываний как посадочная площадка
RISC-V решает ту же задачу приёмом, которого нет больше нигде, и приём этот стоит разобрать целиком, потому что он объясняет что-то про архитектуру.
Включение трансляции здесь — одна запись в satp: режим, идентификатор адресного пространства и номер физической страницы корневой таблицы. Никакого разделения на «разрешить» и «включить», никакого второго перехода для смены разрядности. Соответственно и переходная проблема выглядит голее: после записи satp следующая инструкция выбирается уже по новой карте.
Ядро Linux пользуется тем, что отказ выборки инструкции — это исключение, а адрес обработчика задаётся регистром, который можно выставить заранее. Перед записью satp в stvec кладётся виртуальный адрес инструкции, следующей за записью. Дальше загружается трамплинная таблица, отображающая ядро по его виртуальному адресу, и комментарий объясняет замысел: «загрузить трамплинный каталог страниц, что заставит нас попасть в stvec, если виртуальный адрес не равен физическому, или просто провалиться дальше, если равен». То есть переход в верхнюю половину происходит не переходом, а отказом: счётчик команд оказывается невалидным, процессор берёт адрес из stvec, и это ровно тот адрес, куда нужно было попасть.
        # a1 — разница между виртуальным и физическим адресом ядра
        la      a2, 1f
        add     a2, a2, a1              # виртуальный адрес метки 1
        csrw    stvec, a2               # посадочная площадка на случай отказа

        sfence.vma                      # setup_vm() только что записал эти PTE
        csrw    satp, a0                # a0 — трамплинная таблица
.align 2
1:      # сюда попадают двумя путями: провалившись (VA == PA)
        # или через отказ выборки, доставленный по stvec (VA != PA)
Второй шаг — переключение с трамплинной таблицы на настоящую, и оно безопасно по причине, названной в том же коде: «выборка барьера гарантированно сработает, потому что первая суперстраница транслируется одинаково». Переходное отображение здесь, таким образом, не выбрасывается отдельным действием — оно просто перестаёт использоваться при следующей записи в satp.
Тем же механизмом решается совершенно другая задача, и это лучшая иллюстрация того, зачем вообще нужно тождественное отображение. Поддерживаемое число уровней трансляции ядро выясняет не чтением регистра, а экспериментом, и комментарий описывает его так: «установить тождественное отображение в режиме четырёхуровневых таблиц, затем прочитать SATP и посмотреть, была ли конфигурация принята». Функция, которая это делает, отображает тождественно саму себя — причём две смежные области, «на случай, если set_satp_mode пересекает границу двух таблиц среднего уровня», — включает трансляцию, читает satp обратно и по расхождению понимает, что режим не поддержан. Проверка возможна только потому, что код проверки продолжает исполняться после включения.
Требование к раннему коду выражено здесь ещё и на уровне сборки, и приём стоит перенять. В том же файле стоит директива препроцессора, останавливающая компиляцию: #error "setup_vm() is called from head.S before relocate so it should not use absolute addressing." — а рядом объяснение, что для этого «мы всегда используем cmodel=medany». Модели кода разбирает восьмая статья; здесь важно, что требование к раннему коду можно сделать проверяемым компилятором, а не комментарием.
Что общего и почему это пишут на ассемблере
Три архитектуры дают три разных ответа, и различие между ними — не про удобство, а про то, чем каждая архитектура располагает. x86-64 располагает единственным корнем трансляции и потому вынужден держать оба отображения в одной таблице и потом чистить её. ARM64 располагает двумя корнями и кладёт переходное отображение в тот, который всё равно предназначен пользователю, — выбрасывание становится бесплатным. RISC-V располагает программируемым вектором исключений и обходится вовсе без совпадающего отображения, превратив отказ в механизм перехода.
Общее у всех трёх — окно, в котором действуют две системы адресации одновременно, и в этом окне обычный код писать нельзя. Компилятор в любой момент может обратиться к глобальной переменной по адресу, вычисленному из символа; в этом окне такое обращение может оказаться правильным, а может — нет, и от какого флага оптимизации это зависит, заранее не известно. Отсюда и ассемблер: не потому, что нужны редкие инструкции, а потому, что нужна гарантия, какими адресами пользуется каждое обращение. Второй довод — порядок: барьеры вокруг включения трансляции обязаны стоять именно там, где стоят, а компилятор вправе переставлять то, что считает независимым.
Вердикт по переходному периоду
Для своей ОС порядок такой, и он же порядок цены ошибки.
Выделите код перехода в собственную секцию скрипта компоновки и стройте переходное отображение по её границам, а не по адресу конкретной функции. Это ровно то, что делает ARM64 с .idmap.text, и главный выигрыш не в аккуратности, а в проверяемости: границы секции — символы, их можно напечатать и проверить статическим утверждением.
Стройте переходное отображение минимальным. Соблазн отобразить тождественно первые несколько гигабайт велик — так проще, и первое время работает. Но это отображение переживёт загрузку, если про него забыть, и вы получите ядро, у которого младшая половина адресного пространства указывает на физическую память; поймается это не сразу и не там.
Выбрасывайте переходное отображение явно и как можно раньше — первой операцией кода, исполняющегося по адресам исполнения. Если архитектура даёт для этого отдельный корень, пользуйтесь им: правка живой таблицы, по которой вы сейчас работаете, — принципиально более хрупкая операция.
И проверяйте переход в отладчике, а не по симптомам. QEMU с GDB, разобранные в восьмой статье, позволяют поставить точку останова ровно на инструкцию включения и посмотреть, что стало со счётчиком команд. Это единственный способ отличить «карта неверна» от «переход не туда» — по симптому они неразличимы, потому что и то и другое выглядит как остановившаяся машина.
Подъём вторичных процессоров
x86-64: два способа разбудить процессор
Классический механизм на x86 продиктован тем, в каком состоянии оказываются процессоры после сброса. Руководство Intel описывает его прямо: аппаратный сброс «переводит процессор в реальный режим адресации», после чего процессоры выполняют протокол инициализации, один из них становится загрузочным, а остальные «переходят в состояние ожидания стартового межпроцессорного прерывания». В этом состоянии они и ждут, пока операционная система не пришлёт последовательность INIT — INIT — SIPI — SIPI.
Ограничение прячется в кодировании стартового прерывания. Адрес, с которого процессор начнёт исполнение, передаётся в нём восемью битами, и руководство поясняет, что это значит: «8-битный вектор задаёт адрес 4-килобайтной страницы в адресном пространстве реального режима (пространство в 1 МиБ); например, вектор 0BDH задаёт стартовый адрес 000BD000H». Отсюда требование, которое приходится соблюдать всем: код, с которого стартует вторичный процессор, обязан лежать в выровненной на страницу области ниже мегабайта.
Из этого следует всё остальное устройство трамплина. Процессор просыпается в реальном режиме, без стека, с IP равным нулю и неизвестным CS, — комментарий в ядре Linux начинается ровно с этого перечисления, а заканчивается требованием, объясняющим, почему трамплин собирают отдельным объектным файлом: «если вы работаете с этим файлом, проверьте объектный модуль через objdump --full-contents --reloc, чтобы убедиться, что записей перемещения нет». Дальше вторичный процессор проходит весь путь заново — реальный режим, защищённый, длинный, — и лишь потом прыгает в ядро по виртуальному адресу через косвенный переход, комментарий над которым говорит: «теперь прыгаем в ядро, пользуясь виртуальными адресами».
Второй способ на x86 моложе и по устройству ближе к тому, что делают другие архитектуры. Спецификация ACPI описывает структуру пробуждения многопроцессорной системы: «прошивка платформы публикует структуру пробуждения, чтобы загрузочный процессор мог будить прикладные процессоры через почтовый ящик», а сама прошивка «во время загрузки системы приводит прикладные процессоры в состояние проверки почтового ящика». Операционная система записывает в ящик идентификатор процессора и адрес пробуждения, потом команду; процессор, чей идентификатор совпал, прыгает по этому адресу. Среда исполнения при этом описана — с оговоркой «для процессоров Intel» — и она уже не реальный режим: «длинный режим включён; трансляция включена, и физическая память для вектора пробуждения отображена тождественно». Одноразовость снимается не одним условием, а двумя сразу: ящик используется для команды пробуждения каждого процессора единожды, «если только значение поля MailBoxVersion не больше нуля и поле ResetVector не содержит ненулевого значения». А вот происхождение механизма из конфиденциальных вычислений, где гость не вправе отдавать сырые межпроцессорные прерывания, в спецификации не названо — это реконструкция по косвенным признакам: работа с ящиком в ядре Linux отдельно оговаривает поведение под TDX.
ARM64: PSCI и spin-table
На ARM64 просить процессор нужно у резидентной прошивки. Интерфейс координации состояний питания определяет функцию CPU_ON с тремя аргументами — идентификатор целевого ядра в формате полей сходства регистра MPIDR, адрес точки входа и идентификатор контекста, — и вызывается она через SMC или HVC.
Требования к состоянию, в котором просыпается ядро, спецификация перечисляет явно, и они складываются в тот же вывод, что и на x86. Адрес точки входа «обязан быть корректным физическим адресом на ELNS» — на первом небезопасном уровне исключений, то есть на наивысшем реализованном из небезопасных. Оговорка не косметическая: под гипервизором вызов из EL1 требует либо выключенной трансляции второй стадии, либо перехвата вызова на EL2, который подставит адрес сам, — спецификация разбирает обе схемы отдельно. Состояние исполнения ядро получает то же, в котором был вызывающий. Асинхронные исключения замаскированы. И главное: «исполнение обязано начаться с выключенным MMU первой стадии и выключенными кэшами», то есть SCTLR_ELx.{I, C, M} равны нулю. Идентификатор контекста прошивка кладёт в X0.
То есть вторичный процессор на ARM64 не наследует ничего: ни трансляции, ни кэшей. Весь переход из предыдущего раздела он проходит заново — что в ядре Linux и видно, secondary_startup вызывает те же __cpu_setup и __enable_mmu, что и первичный путь.
Устаревшая альтернатива называется spin-table и полезна как пример того, чем PSCI лучше. Документация Linux описывает её так: у процессора в дереве устройств указан способ запуска spin-table и адрес освобождения; такие процессоры «должны крутиться вне ядра, в зарезервированной области памяти, опрашивая свой адрес освобождения», при этом «можно вставить инструкцию wfe, чтобы снизить накладные расходы холостого цикла», а первичный процессор выдаст sev. Когда по адресу появляется ненулевое значение, процессор прыгает по нему. Конструкция работает, но у неё нет обратной операции: выключить процессор обратно нечем, а значит нет ни горячего отключения, ни kexec. PSCI это умеет, потому что состояниями ядер управляет тот, кто управляет питанием.
RISC-V: SBI HSM и лотерея
RISC-V формализовал ту же идею расширением управления состояниями хартов. Функция sbi_hart_start(hartid, start_addr, opaque) просит прошивку запустить указанный харт в супервизорном режиме по указанному физическому адресу. Состояние на старте перечислено спецификацией: satp равен нулю, sstatus.SIE выключен, a0 содержит идентификатор харта, a1 — переданное значение opaque. Вызов асинхронный: он «может вернуться до того, как целевой харт начнёт исполнение». Харты живут в семи состояниях — запущен, остановлен, четыре переходных и приостановлен, — и это ровно та машина состояний, которой не хватает spin-table.
Более старый способ в ядре Linux сохранён и назван честно: при RISCV_BOOT_SPINWAIT «прошивка отпускает в ядро все харты, один харт выигрывает в лотерею и исполняет ранний загрузочный код, пока остальные харты припаркованы в ожидании завершения инициализации». Документация тут же говорит, чем это плохо и что предпочтительно: упорядоченная загрузка через расширение управления состояниями «предпочтительна, потому что она способна поддержать горячее подключение процессоров и kexec». Довод тот же, что против spin-table, и это не совпадение.
Что должно быть готово до старта второго процессора
Три интерфейса — межпроцессорное прерывание, вызов монитора, вызов прошивки — дают одну и ту же форму: «вот физический адрес, начни с него, трансляция выключена». Даже почтовый ящик ACPI, стартующий процессор уже в длинном режиме, передаёт физический адрес и тождественное отображение. Расходятся они в уровне привилегий: стартовое прерывание будит процессор в реальном режиме, CPU_ON отдаёт ядро на ELNS — наивысшем реализованном небезопасном уровне исключений, sbi_hart_start запускает харт в супервизорном. Различается и происхождение выключенной трансляции: на x86-64 это следствие семантики сброса, описанной в руководстве, а на ARM64 и RISC-V — обязательство интерфейса, потому что состояние гарантирует не архитектурный сброс, а прошивка. Ни один из них не передаёт вторичному процессору готовую карту ядра, и это стоит принять как свойство задачи, а не как недоработку: карта ядра — состояние операционной системы, а прошивка о нём ничего не знает.
Отсюда жёсткий порядок, в котором готовится всё остальное, и он жёсткий потому, что вторичный процессор начинает исполнять код сразу, а не тогда, когда вам удобно.
К моменту вызова обязаны существовать финальные таблицы страниц ядра и переходное отображение — вторичный процессор пройдёт весь путь включения трансляции заново. Переходное отображение при этом нужно ему своё: ранняя карта первого процессора к этому моменту либо выброшена, либо лежит в разделе инициализации, который скоро освободят, — поэтому под вторичных заводят отдельную, специально сохранённую структуру. В Linux это видно на всех трёх архитектурах: на arm64 secondary_startup берёт постоянный idmap_pg_dir, а не init_idmap_pg_dir, размещённый компоновщиком в .init.data; на riscv64 relocate_enable_mmu заряжает trampoline_pg_dir и для вторичных тоже; на x86-64 трамплин реального режима пишет в CR3 собственный trampoline_pgd, лежащий внутри его блоба, потому что ранняя карта уже убита reset_early_page_tables().
У вторичного процессора обязан быть свой стек, выделенный заранее: вторичный процессор не может выделить себе стек, потому что для этого нужен стек. Область данных на процессор обязана быть выделена и её база записана туда, откуда код умеет её читать, — регистр или массив по номеру процессора; иначе первое же обращение к данным текущего процессора уйдёт в чужие. И вектор исключений: до его установки любое исключение неотличимо от зависания.
Аллокатор при этом достаточно иметь на самой нижней ступени — стеки и области на процессор выделяются один раз при запуске, до появления страничного аллокатора; лестница раскрутки разобрана в пятой статье, а требования к стеку ядра — в четвёртой.
Вердикт для своей ОС: поднимайте вторичные процессоры позже, чем хочется. Многопроцессорность обесценивает почти все допущения, на которых держится ранний код, — от «эту переменную никто не читает параллельно» до «выделение не может произойти одновременно», — и отлаживать её вместе с ранней загрузкой означает отлаживать две незнакомые вещи сразу. Заложить надо только одно: интерфейс запуска должен принимать номер процессора и указатель на его состояние с самого начала, даже если процессор пока один.
Дальше в пользовательское пространство
initramfs: зачем понадобилась промежуточная корневая ФС
Промежуточная корневая файловая система существует из-за замкнутого круга, похожего на тот, что разбирает пятая статья про аллокатор. Чтобы смонтировать настоящий корень, нужен драйвер контроллера, файловой системы, а часто ещё и слоя поверх — тома, массива, шифрования, сети. Драйверы — модули, а модули лежат в корне, который ещё не смонтирован. Круг разрывают, положив в память архив, из которого ядро развернёт минимальное пользовательское пространство и отдаст ему задачу «найди и смонтируй настоящий корень».
Устройство описано документацией ядра коротко: архив в формате cpio, сжатый gzip, «разворачивается в rootfs при загрузке ядра; после разворачивания ядро проверяет, есть ли в rootfs файл init, и если есть, исполняет его как процесс с идентификатором 1». Различие с более старым механизмом initrd там же названо по пунктам, и два пункта существенны. Первое: initrd был образом файловой системы, для чтения которого нужен был драйвер, встроенный в ядро, а initramfs — архив, «и код разбора cpio в ядре не только чрезвычайно мал, он ещё и относится к разделу инициализации, который можно выбросить в процессе загрузки». Второе: программа из initrd делала своё дело и возвращала управление ядру, а init из initramfs «возвращаться в ядро не должен» — он передаёт управление, наложив новый корень и запустив другой init.
Здесь же лежит факт, который стоит проверить, прежде чем повторять общеизвестное. Классическое объяснение, почему из initramfs пользуются утилитой switch_root, а не системным вызовом pivot_root, звучало так: rootfs нельзя отмонтировать, потому что это корень всей иерархии. В Linux 7.0 это перестало быть верным: под rootfs подложили пустую неизменяемую псевдофайловую систему, и документация теперь описывает устройство так — «ядро использует неизменяемую пустую файловую систему nullfs как настоящий корень иерархии VFS, а изменяемая rootfs смонтирована поверх неё; это позволяет pivot_root() и отмонтированию initramfs работать нормально». Рекомендованная последовательность стала трёхстрочной, а прежняя названа в сопроводительном письме «хрупкой». Утверждение это свежее, привязано к версии намеренно и на системах со старым ядром неверно.
Первый процесс: возврат, которого не было
Остаётся вопрос, который выглядит парадоксом: как ядро запускает первую программу, если запускать программы умеет только execve, а execve вызывается процессом, которого ещё нет.
Ответ в том, что процесс создаётся раньше программы. Ядро Linux порождает задачу с идентификатором 1 обычным механизмом порождения, передав ей функцию kernel_init как тело; принципиально важно, чего при этом не делается — задача не помечается как поток ядра. Проверка в реализации execve объясняет, почему это принципиально: «потокам ядра вызывать execve бессмысленно», и попытка отвергается. То есть первый процесс с самого начала является пользовательским процессом, у которого просто ещё нет ни адресного пространства, ни пользовательского состояния регистров.
Дальше kernel_init доводит систему до пригодного состояния — ждёт готовности вспомогательных потоков, выполняет отложенную инициализацию, освобождает раздел инициализации, выставляет права на секции ядра, — и вызывает kernel_execve. Тот делает ровно то, что делает обычный execve: создаёт адресное пространство, загружает образ, заполняет кадр регистров начальными значениями — счётчик команд на точку входа, указатель стека на построенный стек с аргументами. И после этого функция просто возвращается.
Возврат приводит на общий путь выхода из ядра. На x86-64 это видно дословно: код, на который попадает вновь порождённая задача, вызывает C-функцию, а сразу за вызовом стоит комментарий «привести состояние стека к тому, которое ожидает целевая функция: в этой точке набор регистров должен быть корректным пользовательским набором», после чего идёт переход на обычную процедуру возврата в пользовательский режим. Никакой отдельной инструкции «перейти в пользовательское пространство» не исполняется — исполняется тот же возврат, что и после любого системного вызова, только кадр под него написан вручную.
FreeBSD делает то же самое и говорит об этом ещё прямее. В start_init кадр текущего потока обнуляется, вызывается kern_execve, и комментарий рядом объясняет ожидаемый исход: «в противном случае вернуться через fork_trampoline() всю дорогу до пользовательского режима как init!». Ассерт рядом требует, чтобы вызов вернул EJUSTRETURN, — то есть «ничего не делай, просто вернись», и этот возврат и есть запуск первого процесса.
Два независимо выросших ядра пришли к одной конструкции, и это хороший признак того, что она не случайна. Обобщение для того, кто пишет свою ОС: вход в пользовательское пространство — не операция, а состояние кадра. Если ваш путь возврата из ядра умеет восстанавливать произвольный сохранённый кадр, вы уже умеете запускать процессы; отдельного механизма писать не нужно. Устройство самого пути возврата — какие инструкции его выполняют, что проверяется перед ними и какая отложенная работа делается в этой точке — разбирает седьмая статья.
Что делает init дальше — монтирует, поднимает сервисы, разворачивает цели — к загрузке уже не относится и разобрано отдельно: systemd как реализация и управление загрузкой как практика.
Как это сделано в трёх системах
| Linux | FreeBSD | seL4 | |
|---|---|---|---|
| Кто загружает ядро | загрузчик или прошивка напрямую: образ содержит заголовок PE и является UEFI-приложением | трёхступенчатая цепочка; loader.efi — UEFI-приложение по стандартному пути ESP |
на ARM и RISC-V — отдельная программа elfloader, в которую ядро и начальный образ вложены архивом |
| Где живёт переход к трансляции | в самом ядре, ранним ассемблером на архитектуру | в самом ядре | вне ядра: elfloader строит начальные таблицы и включает MMU |
| Кто поднимает вторичные процессоры | ядро: IPI, PSCI или SBI | ядро | elfloader, до запуска ядра |
| Что получает первый пользовательский код | процесс с идентификатором 1, созданный до образа и получивший образ через execve |
то же, с обнулением кадра и возвратом через трамплин | начальная задача с мандатами на всю оставшуюся память — разбор в пятой статье |
| Промежуточный корень | initramfs, разворачиваемый в rootfs | модули и метаданные, загруженные loader заранее |
образ начальной задачи внутри архива elfloader |
Из таблицы стоит унести одно наблюдение. Три системы расходятся не в том, что делают, а в том, где проведена граница между «загрузчиком» и «ядром». Linux втянул загрузчик внутрь образа: заглушка EFI делает ядро самозагружающимся. seL4 вынес раннюю часть наружу целиком: elfloader «отвечает за подготовку оборудования для seL4 на ARM и RISC-V» — оговорка стоит в README первой строкой, и на x86 seL4 грузится иначе, — загружает ядро и образ пользователя из вложенного архива, «инициализирует вторичные ядра, если включена многопроцессорность, и настраивает начальный набор таблиц страниц для ядра», после чего включает MMU и запускает seL4. FreeBSD осталась посередине с полноценным отдельным загрузчиком.
Для автора своей ОС вариант seL4 — самый недооценённый. Ранняя часть, вынесенная в отдельную программу, отлаживается отдельно, собирается под свои правила и не тащит в ядро ни ассемблера перехода, ни знания про формат образа. Цена — ещё один артефакт сборки и ещё один контракт между ним и ядром.
Вердикт для своей ОС
Порядок ниже — порядок необратимости, а не порядок работы.
Протокол загрузки выбирайте исходя из цели проекта, и решение фиксируйте письменно, потому что через месяц причина забудется. Понимание механизма — Multiboot2, скорость до работающей системы — Limine со свежей базовой ревизией. Собственное UEFI-приложение — не отправная точка.
Слой «попросить платформу» закладывайте с самого начала, даже если целевая архитектура x86-64 и просить не у кого. Запуск процессора, выключение, перезагрузка на ARM64 и RISC-V — вызовы чужого кода, и функция с сигнатурой «попроси платформу сделать X», реализованная на x86 записью в регистр, стоит десяти строк. Дописать этот слой потом означает найти все места, где вы записали в регистр напрямую.
Код перехода к трансляции держите в отдельной секции скрипта компоновки и стройте переходное отображение по её границам. Это единственное место в ядре, где ошибка не диагностируется вообще: машина останавливается, и по остановке нельзя понять, неверна карта или неверен переход.
Переходное отображение выбрасывайте явно, первой операцией на адресах исполнения. Забытое тождественное отображение — не мелкая неаккуратность: оно оставляет ядру рабочий путь к физической памяти в обход всех проверок и переживёт всю загрузку.
Раздел инициализации заводите сразу, даже пустым. Весь код перехода, весь разбор карты, весь трамплин вторичных процессоров — одноразовые, и место для них в образе должно быть размечено раньше, чем они появятся; механика — в восьмой статье.
Вторичные процессоры откладывайте до тех пор, пока однопроцессорная система не станет скучной. Но интерфейс запуска — «номер процессора и указатель на его состояние» — пишите с первого дня, иначе состояние на процессор окажется глобальными переменными, и переписывать придётся всё.
Пользовательское пространство запускайте через тот же путь возврата, что и после системного вызова, собрав кадр вручную. Отдельный механизм «войти в пользовательский режим» — признак того, что путь возврата написан неправильно и второй раз его придётся написать заново.
Дальше в цикле остаётся структура ядра — единственное по-настоящему открытое решение, которое меняет и половину этой статьи тоже: у системы, отдающей раннюю работу наружу, значительная часть перечисленного просто не принадлежит ядру. Состав и порядок — в плане цикла.
Источники
- Unified Extensible Firmware Interface Specification 2.11 (декабрь 2024), раздел 2 «Overview» — PE32+ как формат образов UEFI и типы подсистем, загрузка образа через
LoadImage(), среда исполнения на x86-64, AArch64 и RISC-V (режим, трансляция, прерывания, стек, аргументы точки входа), требование единственного процессора во время сервисов загрузки (§2.3.4, §2.3.6, §2.3.7), соглашение о вызовах на x86-64, условия работы приложения с собственными таблицами страниц, требование настроить вектор исключений сразу послеExitBootServices()— оно записано и в разделе про AArch64, и в разделе про RISC-V - Unified Extensible Firmware Interface Specification 2.11, раздел 7 «Services — Boot Services» —
ExitBootServices(): передача владения памятью, прекращение сервисов и протоколов, отключение сторожевого таймера, обнуление полей системной таблицы и пересчёт контрольной суммы, порядок оповещения групп событий - Unified Extensible Firmware Interface Specification 2.11, раздел 8 «Services — Runtime Services» —
SetVirtualAddressMap(): переселение сервисов времени исполнения в виртуальные адреса, повторное применение перемещений и однократность вызова - Unified Extensible Firmware Interface Specification 2.11, раздел 32 «Secure Boot and Driver Signing» — ключ платформы, переменная
SetupModeи переход между режимом настройки, пользовательским режимом, режимом аудита и режимом развёртывания - Advanced Configuration and Power Interface Specification 6.6 (май 2025), раздел 5 «ACPI Software Programming Model» — структура пробуждения многопроцессорной системы: почтовый ящик в памяти ACPI NVS, поля команды, идентификатора и вектора пробуждения, среда исполнения вторичного процессора для процессоров Intel (длинный режим, тождественное отображение), однократность использования и условие её снятия —
MailBoxVersionбольше нуля вместе с ненулевымResetVector - Multiboot Specification version 0.6.96 — состояние машины при входе, магическое значение
0x2BADB002, отсутствие стека и возможная недействительность регистра таблицы дескрипторов - Multiboot2 Specification version 2.0 — состояние машины на i386 (
PGсброшен,PEустановлен,IFиVMсброшены, A20 открыт, стек создаёт сам образ), магическое значение0x36d76289, требование завершить сервисы загрузки на EFI-системах, теги сервисов загрузки и точек входа EFI и состояние машины при их использовании, запрет загружать что-либо выше 4 ГиБ − 1 - The Linux/x86 Boot Protocol — документация ядра Linux — история версий протокола, заголовок настройки и
boot_params, условия входа для 32-битного и 64-битного вариантов, объявление протокола передачи EFI устаревшим в пользу обычной точки входа PE/COFF, получение начального диска черезEFI_LOAD_FILE2 - Booting AArch64 Linux — документация ядра Linux — 64-байтный заголовок образа и его поля, роль
res5при загрузке через EFI, условия входа (MMU выключен, кэши очищены до точки согласованности, EL2 или EL1, прерывания замаскированы,x0— адрес дерева устройств, устройства приведены в покой), способы запуска вторичных процессоровspin-tableиpsciи требования к ним - RISC-V Kernel Boot Requirements and Constraints — документация ядра Linux —
a0иa1при входе, требованиеsatp = 0, два способа входа на многопроцессорных системах и довод в пользу упорядоченной загрузки - Документация QEMU по машинам
arm/virtиriscv/virt— загрузка образа через-kernel: не-ELF образ на aarch64 грузится по протоколу ядра с адресом дерева устройств вx0, для ELF дерево лежит в начале ОЗУ; на riscv64-kernel— это полезная нагрузка S-режима, а прошивкой по умолчанию подставляется OpenSBI - Ramfs, rootfs and initramfs — документация ядра Linux — устройство initramfs,
nullfsкак настоящий корень иерархии VFS и работающий из initramfspivot_root(), отличия от initrd, отношение кода разбораcpioк разделу инициализации - Пул-реквест «vfs nullfs» для Linux 7.0, LKML, февраль 2026 — версия, в которой появилась
nullfs, и мотивировка: невозможность отмонтировать rootfs и хрупкость последовательностиswitch_root - Intel 64 and IA-32 Architectures Software Developer's Manual, Volume 3 (325384-092US, июнь 2026) — раздел 12.8.5 «Initializing IA-32e Mode»: пятишаговая последовательность включения длинного режима, требование
PAE, установкаLMAпри включении трансляции, требование располагать инструкциюMOV CR0и следующие за ней на тождественно отображённой странице, ограничение на размещение таблиц ниже 4 ГиБ; раздел 12.1 «Initialization Overview»: сброс переводит процессор в реальный режим адресации, вторичные процессоры уходят в ожидание стартового прерывания; раздел 11.4 «Multiple-Processor (MP) Initialization»: последовательность INIT-SIPI-SIPI и кодирование стартового адреса восемью битами вектора; раздел 34.1 «System Management Mode Overview»: SMM как среда прошивки, прозрачная для операционной системы - Arm Power State Coordination Interface (DEN0022F.b, PSCI 1.3, 2024) —
CPU_ONи его аргументы; §6.4.1: ELNS как первый небезопасный уровень исключений; §6.4.2: требование к адресу точки входа быть корректным физическим адресом на ELNS и две схемы для систем с виртуализацией; §6.4.3: состояние ядра при старте (то же состояние исполнения,SCTLR_ELx.{I, C, M}равны нулю, маски асинхронных исключений, идентификатор контекста вX0) - RISC-V Supervisor Binary Interface Specification 3.0, введение — определение SBI и среды исполнения супервизора, прошивка машинного режима или гипервизор в роли этой среды
- RISC-V SBI Specification 3.0, расширение управления состояниями хартов —
sbi_hart_start()и его аргументы, состояние харта на старте (satpравен нулю,sstatus.SIEвыключен,a0иa1), асинхронность вызова, семь состояний харта - Trusted Firmware-A: Firmware Design — стадии BL1, BL2, BL31, BL32, BL33 и их уровни исключений, BL31 как резидентная прошивка EL3 и поставщик служб времени исполнения, включая PSCI, переход к недоверенной прошивке на наивысшем доступном уровне
- OpenSBI: README и документация по видам прошивки FW_JUMP, FW_PAYLOAD, FW_DYNAMIC — OpenSBI как реализация SBI для прошивки машинного режима и три способа связать её со следующей ступенью
- UEFI support in U-Boot — документация U-Boot — U-Boot как частичная реализация UEFI по требованиям EBBR, наличие сервисов загрузки и времени исполнения, исполнение чужих EFI-образов, оговорка о том, что полная реализация противоречила бы принципу «keep it small»
- Limine Boot Protocol — состояние машины при входе на трёх архитектурах, базовые ревизии с нулевой по шестую и объявление ревизий 0–5 устаревшими, изменение состава отображений по ревизиям и исчезновение тождественного отображения после нулевой, вход на EL2 с VHE начиная с шестой ревизии, размещение таблиц, стека и ответов протокола в возвращаемой памяти, запрос многопроцессорности и парковка вторичных процессоров через
goto_address - Limine: конфигурация — приписывание хеша к пути файла и три длины (64 — BLAKE3, 128 — BLAKE2b, 256 — BLAKE3 с расширенным выходом), обязательность хешей при активном Secure Boot и исключение для обоев и шрифтов, отключение редактора, список поддерживаемых протоколов
- Limine: выпуски — версия 12.8.0 от 5 сентября 2026 года как стабильный выпуск на дату сверки
- Исходники ядра Linux (выверялось на mainline 7.3-rc2; стабильной на дату сверки была 7.2.4):
arch/x86/boot/compressed/head_64.S— установкаEFER.LME, комментарий про режим совместимости и дальний переход радиCS.L = 1, комментарий про#GPпри сменеCR4.LA57в длинном режиме и трамплин в младшей памяти;arch/x86/kernel/head_64.S— косвенный переход к общему стартовому коду по виртуальному адресу и ячейка с абсолютным адресом рядом;arch/x86/kernel/head64.c—reset_early_page_tables()и комментарий «kill off the identity-map trampoline» первой операцией на виртуальных адресах;arch/x86/realmode/rm/trampoline_64.S— состояние вторичного процессора при входе, требование отсутствия записей перемещения, входtrampoline_start64для пробуждения прямо в 64-битный режим, собственныйtrampoline_pgd, который оба входа загружают вCR3;arch/x86/kernel/smpboot.c— последовательность INIT, снятия INIT и двух стартовых прерываний, вектор какstart_eip >> 12, выбор между тремя способами пробуждения;arch/x86/kernel/acpi/madt_wakeup.c— работа с почтовым ящиком ACPI и порядок записи полей;arch/x86/entry/entry_64.S—ret_from_fork_asmи комментарий о том, что набор регистров в этой точке должен быть корректным пользовательским набором;arch/arm64/kernel/head.S—init_kernel_elи спуск с EL2 на EL1 черезeret,__enable_mmuв секции.idmap.textи требование к вызывающему быть в той же секции, переход к адресу исполнения через литерал,secondary_startup, включающий MMU на постоянномidmap_pg_dir, тогда как первичный путь пользуетсяinit_idmap_pg_dir;arch/arm64/kernel/vmlinux.lds.S— размещениеidmap_pg_dirдо__initdata_begin, аinit_idmap_pg_dirпосле него;arch/arm64/include/asm/assembler.h— макросset_sctlrс барьерами и инвалидацией кэша инструкций и объяснение, зачем она нужна;arch/arm64/kernel/hyp-stub.S— переход к VHE и проверка, что MMU выключен;arch/arm64/include/asm/mmu_context.h—cpu_uninstall_idmap()как переключениеTTBR0на зарезервированные таблицы;arch/riscv/kernel/head.S—relocate_enable_mmu,stvecкак посадочная площадка, комментарии про трамплинную таблицу и про то, почему безопасна вторая запись вsatp, вызов той же функции сtrampoline_pg_dirна пути вторичных хартов;arch/riscv/mm/init.c—set_satp_mode()и определение поддерживаемого числа уровней через тождественное отображение самой проверяющей функции, директива#errorпро абсолютную адресацию в раннем коде;init/main.c— создание задачи с идентификатором 1 без пометки «поток ядра»,kernel_initиrun_init_process;kernel/fork.c— выставлениеPF_KTHREADтолько по явному признаку;fs/exec.c— отказkernel_execve()работать для потоков ядра - Исходники FreeBSD (ветка
mainна дату сверки):sys/kern/init_main.c—start_init, обнуление кадра потока передkern_execve, комментарий о возврате через трамплин «всю дорогу до пользовательского режима как init» и требование получитьEJUSTRETURN - boot(8) и uefi(8) — трёхступенчатая цепочка загрузки FreeBSD и передача управления
loader(8),loader.efiпо стандартному пути раздела EFI - seL4 elfloader — README — вынесение всей ранней работы в отдельную программу на ARM и RISC-V: загрузка ядра и образа пользователя из вложенного архива, построение начальных таблиц, подъём вторичных ядер, включение MMU и запуск seL4
Связанные заметки
- Физическая память: от карты firmware до аллокатора — пятая статья цикла: что ядро делает с картой памяти, которую получило здесь, и как поднимается аллокатор
- Ядро как программа: freestanding, компоновка, ABI, выбор языка — восьмая статья цикла: адрес загрузки против адреса исполнения, модели кода и разделы, выбрасываемые после загрузки, — здесь разбирается момент перехода между двумя видами адресов
- Карта памяти ядра: половины, прямое отображение, KASLR — третья статья цикла: куда именно ведёт прыжок в верхнюю половину и что должно быть в готовой карте
- Вход в ядро и переключение контекста — седьмая статья цикла: путь возврата в пользовательское пространство, которым запускается и первый процесс
- Страничная трансляция: таблицы, TLB, разрядность — вторая статья цикла: один корень трансляции против двух, из-за чего выбрасывание переходного отображения стоит по-разному
- Стеки: ядра, прерываний, пользовательские — четвёртая статья цикла: стек, который обязан существовать до старта вторичного процессора
- Адресное пространство: зачем трансляция и какие есть альтернативы — первая статья цикла: ядро начинает жизнь в модели без трансляции, и загрузка — это переход из неё
- Устройство ОС — план цикла статей — состав и порядок цикла
- Linux — обновление и управление загрузкой — та же цепочка со стороны администратора: загрузчики, порядок загрузки, цепочка доверия в дистрибутиве
- Linux — ядро: сборка, модули, параметры — initramfs и параметры командной строки с той стороны, где их настраивают
- Linux — systemd: init, сервисы, таймеры — что делает первый процесс после того, как ядро передало ему управление
- FreeBSD — архитектура, философия и базовые принципы — устройство базовой системы, частью которой является трёхступенчатый загрузчик
- Структура ядра: монолит, микроядро и что между — девятая статья цикла: почему монолит втягивает раннюю работу внутрь себя, а микроядро выносит её наружу
Из библиотеки института уносят только знания. Читателей здесь не считают: посещение не регистрируется, отметок в издании не остаётся, счётчиков нет ни у одного издания фонда.
Издание пополняется и пересверяется. Текст доступен на условиях CC BY-SA 4.0 — унесённое можно передавать дальше на тех же условиях.