Четыре решения, которые обычно копируют
Карта адресного пространства ядра выглядит как соглашение: ядро наверху, пользователь внизу, где-то посередине окно во всю физическую память, всё это слегка сдвинуто случайным числом при загрузке. Так устроены Linux, FreeBSD и seL4, так требует загрузочный протокол Limine, и человек, пишущий свою ОС, обычно перерисовывает эту картинку целиком, не спрашивая, откуда взялась каждая линия.
На самом деле здесь четыре независимых решения, и каждое чинит или ломает вполне конкретную вещь. Отображено ли ядро в адресное пространство каждого процесса — от этого зависит стоимость системного вызова и то, устоит ли система перед Meltdown. Есть ли окно прямого доступа ко всей физической памяти — от этого зависит, можно ли вообще написать virt_to_phys одним вычитанием, и заодно то, дотянется ли ошибка в ядре до чужой страницы. Где лежит образ ядра — это диктует не вкус, а модель кода компилятора. Рандомизируется ли всё перечисленное — и что эта рандомизация на самом деле даёт.
Статья опирается на вторую статью цикла и не переобъясняет введённое там: корни трансляции (CR3, пара TTBR0_EL1/TTBR1_EL1, satp), разбор адреса на индексы, каноничность и знаковое расширение, теги адресных пространств, правила инвалидации, блочные отображения. Отсылки по ходу текста ведут туда, а не пересказывают.
Верхняя половина: почему ядро отображено в каждый процесс
Причина ровно одна, и она сформулирована в документации ядра Linux про highmem прямым текстом: «на архитектуре i386, например, мы отображаем ядро в пространство каждого процесса, чтобы не платить полную стоимость инвалидации TLB при входе в ядро и выходе из него». Всё остальное — следствия. Раз ядро уже отображено, системный вызов не требует записи в регистр базы трансляции; раз запись не нужна, не нужен и сброс TLB, который на x86-64 эту запись сопровождает; раз TLB цел, пользовательский код после возврата продолжает работать на прогретом кэше трансляций.
Цена решения — половина адресного пространства, отданная ядру у каждого процесса. На 32 битах это было болезненно и в конце концов стало нерешаемым; на 64 битах адресов столько, что цена не читается вовсе.
Механика на трёх архитектурах
Реализуется это по-разному, и различие ровно то, что разбиралось в статье про трансляцию, — сколько у пространства корней.
На x86-64 корень один, поэтому «отображено в каждый процесс» приходится обеспечивать копированием: у каждого нового каталога верхнего уровня верхние записи берутся из ядерного каталога. В Linux это буквально одна строка в конструкторе pgd_ctor(), копирующая хвост swapper_pg_dir в новый pgd. Записи копируются один раз при создании адресного пространства, а не поддерживаются синхронно, поэтому изменение карты ядра на уровне верхних записей после этого требует отдельной возни — Linux держит список всех живых каталогов именно для этого.
На ARM64 копировать нечего: корней два, и разделение половин сделано железом. Документация по раскладке памяти формулирует это так: «swapper_pg_dir содержит только (глобальные) отображения ядра, тогда как пользовательский pgd содержит только (неглобальные) пользовательские отображения. Адрес swapper_pg_dir записывается в TTBR1 и никогда не записывается в TTBR0». Дерево ядра существует в единственном экземпляре и не размножается вместе с процессами.
На RISC-V всё как на x86-64: единственный satp, и карта ядра живёт в тех же таблицах, что и карта процесса. Разницу видно в цене ошибки: на ARM64 забыть скопировать записи ядра невозможно, на двух других — можно, и результат будет отказом страницы в первой же инструкции обработчика.
Почему сверху
Верх — не эстетика, а следствие устройства адреса. На x86-64 и RISC-V адрес обязан быть каноническим, то есть старшие биты — знаковым расширением; старшая половина пространства — это в точности адреса с единицами в знаковом расширении, и ничего между половинами не существует. На ARM64 старшая половина ещё жёстче: бит 55 выбирает регистр базы, так что «наверху» буквально означает «через TTBR1». Побочная выгода одинаковая везде и стоит больше, чем кажется: по одному взгляду на адрес видно, чей он, и проверка «пользовательский указатель или ядерный» становится сравнением, а не поиском по таблице областей.
Что это именно следствие режима трансляции, а не закон природы, лучше всего видно у seL4. В обычном режиме её ядро сидит в старшей половине через TTBR1, как все. В режиме гипервизора, где есть только TTBR0_EL2 и адреса всегда лежат в диапазоне от нуля, ядро скомпоновано в младшей половине — и комментарий в исходниках честно объясняет, что пришлось из-за этого подвинуть окно физической памяти, потому что адреса, которые в старшей половине «заворачивались» и оставались каноническими, в младшей стали неканоническими и невалидными.
Отдельное пространство для ядра: 4G/4G и микроядра
Альтернатива существует и была реализована. В 2003 году Инго Молнар выпустил для 32-битного Linux патч 4G/4G, дающий ядру полное собственное четырёхгигабайтное пространство. Мотив был не про безопасность: массив дескрипторов физических страниц выделялся из гигабайта ядерной памяти, и на 64 ГиБ ОЗУ «один только mem_map[] занимает почти 1 ГиБ, из-за чего ядро не может загрузиться». Цена названа там же: «типичная стоимость 4G/4G на типичных x86-серверах — плюс 3 микросекунды к задержке системного вызова» при примерно одной микросекунде у пустого вызова, а в терминах реального времени работы «от 0 % до 30 % в зависимости от нагрузки».
Два обстоятельства из этого патча важнее самих чисел. Первое: полностью раздельные таблицы всё равно требуют кусочка общей памяти — Молнар поднял GDT, IDT, TSS, LDT и стек ядра в верхние 16 МиБ, и это «единственная область, разделяемая между пользовательскими и ядерными таблицами». Ровно эта конструкция вернётся через четырнадцать лет под именем KPTI. Второе: раз ядро больше не видит пользовательскую память, copy_to_user перестаёт быть разыменованием указателя, и патчу пришлось вводить «косвенные примитивы uaccess». Это самая дорогая часть отказа от общей карты, и обходят её только асимметрией: пусть ядерная таблица отображает всё, а урезана будет только пользовательская.
Микроядра приходят к отдельному пространству с другой стороны: сервер, живущий в пользовательском режиме, по определению сидит в своём адресном пространстве, и переход к нему — полноценная смена карты. Но само ядро микроядра ведёт себя как все: у seL4 оно отображено в старшую половину каждого пространства, и вход в него сменой корня не сопровождается — пока не включено урезанное окно, о котором в следующем разделе.
Вердикт для своей ОС: общая карта, ядро в старшей половине. Отдельное пространство для ядра осмысленно ровно в двух ситуациях — когда адресов физически не хватает (32 бита с большой памятью) и когда вы сознательно платите за изоляцию, о чём следующий раздел. Ни та ни другая не является отправной точкой для новой 64-битной системы.
KPTI: цена, которую вернули обратно
Изоляция таблиц страниц пришла не с Meltdown, а раньше и за другим. KAISER, представленный в 2017 году, защищал от атак на KASLR: процессор отвечает на обращение по адресу по-разному в зависимости от того, отображён ли адрес в таблицах, — независимо от того, разрешено ли текущему коду его читать. Отсюда следовало, что расположение ядра можно нащупать по таймингам, не имея к нему доступа. Meltdown, опубликованный в январе 2018-го, поднял ставку: спекулятивное исполнение позволяло не только определить, что адрес отображён, но и прочитать по нему данные. Допущение «отображено, но помечено как недоступное — значит защищено» перестало быть верным, и готовое лекарство от KASLR-атак пришлось включать всем.
Что именно делает изоляция
Механизм — два набора таблиц на процесс. Полный набор действует в режиме ядра и отображает и ядро, и пользователя (иначе copy_to_user пришлось бы переписывать, как в 4G/4G). Пользовательский набор отображает пользователя и минимальный кусок ядра — тот, без которого нельзя войти и выйти. Вход в ядро становится переключением корня трансляции, выход — обратным переключением.
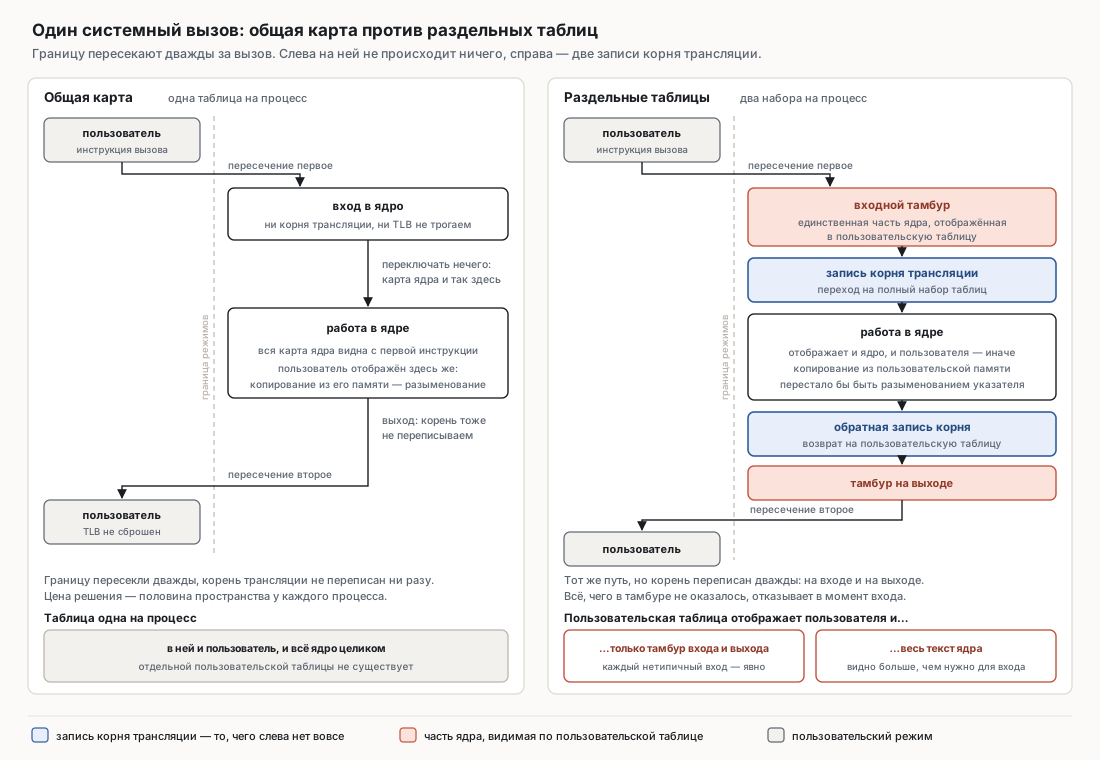
Насколько «минимальный» — это и есть главная развилка между реализациями, и она видна невооружённым глазом. Linux отображает в пользовательскую таблицу только структуру cpu_entry_area, лежащую по адресу, известному на этапе компоновки; документация перечисляет содержимое поимённо — код входа и выхода да таблица дескрипторов прерываний, — и отдельно оговаривает, что попутно туда попадает пара строго не необходимых вещей. Кроме того, ядерная часть пользовательской таблицы «искалечена установкой бита NX на верхнем уровне», чтобы пропущенное переключение корня немедленно убивало процесс, а не тихо продолжало работу. FreeBSD решила иначе: комментарий в sys/amd64/amd64/pmap.c говорит, что пользовательская таблица отображает «пользовательское пространство и трамплин ядра», причём «трамплин ядра включает весь текст ядра целиком и только те данные ядра, которые нужны для перехода из пользовательского режима в режим ядра».
Разница здесь — это выбор между двумя разными рисками, и оба реальны. Meltdown читает данные, а текст ядра секретом не является: он публично известен по образу дистрибутива, так что отображение всего текста Meltdown не помогает. Зато оно оставляет отображённым намного больше кода, чем нужно, — и, как видно из следующего подраздела, отображённый код измеряется по таймингам, то есть выдаёт адреса. Урезанный тамбур Linux эту поверхность сужает, но платит за это тем, что каждый нетипичный путь входа в ядро обязан быть учтён явно: всё, чего в тамбуре не оказалось, отказывает в момент входа. Для своей ОС начинать стоит с урезанного тамбура, и довод здесь про срок, а не про безопасность: пути входа перечислимы, пока их пять, а не пятьдесят, и вести список с самого начала дешевле, чем восстанавливать его по факту. Вариант FreeBSD — разумный способ добавить изоляцию ядру, у которого этих путей накопилось за десятилетия, но плохая отправная точка для нового.
Сколько это стоит
Стоимость складывается из трёх слагаемых, и они по-разному чувствительны к нагрузке. Сами записи в регистр корня — «порядка сотни тактов» на каждый вход и каждый выход, по оценке документации Linux. Потеря глобальных страниц: смысл изоляции в том, чтобы ядерных отображений в пользовательских таблицах не было, а глобальный бит делает их переживающими переключение (механизм разобран во второй статье); та же документация оценивает потерю от этого как «очень небольшую, никогда не превышающую 1 %». И работа с тегами: на x86-64 KPTI съедает бит PCID, потому что каждому процессу теперь нужны два тега.
Сводных чисел стоит остерегаться, потому что разброс огромен и определяется профилем нагрузки. Измерения Брендана Грегга дают рабочую модель: до 5 тысяч системных вызовов в секунду на процессор — меньше полупроцента, свыше 100 тысяч — порядка двух-трёх процентов, но рабочее множество больше 10 МиБ добавляет расходы на сбросы TLB и «превращает 1 % в 7 %». Тег адресного пространства смягчает главное — на процессоре без PCID каждая запись корня сбрасывает TLB целиком, и это уже другой порядок величины. Формулировка из обсуждения KAISER остаётся лучшей краткой оценкой: «5 % — хорошее круглое число для типичного случая», при худших примерно тридцати процентах на сетевых тестах.
Кто включает и по какому признаку
Решение принимается во время загрузки по свойствам процессора, и три системы делают это тремя разными способами — что само по себе полезно как образец.
| Умолчание сборки | Признак, по которому отключается | |
|---|---|---|
| Linux, x86-64 | CONFIG_MITIGATION_PAGE_TABLE_ISOLATION=y |
список безопасных моделей cpu_vuln_whitelist плюс бит ARCH_CAP_RDCL_NO; вручную — nopti или pti= |
| Linux, ARM64 | CONFIG_UNMAP_KERNEL_AT_EL0=y |
ID_AA64PFR0_EL1.CSV3 либо попадание в список безопасных моделей kpti_safe_list[] |
| FreeBSD, amd64 | тунабл vm.pmap.pti |
pti_get_default(): ноль для AMD и Hygon и для процессоров с IA32_ARCH_CAP_RDCL_NO |
| seL4, x86-64 | KernelSkimWindow=ON |
выключается вручную при сборке под заведомо безопасный процессор |
Строка про seL4 стоит отдельного слова, потому что решение там третье, а не одно из двух. Вместо второго набора таблиц seL4 держит урезанное окно ядра: описание опции говорит про «сокращённый статический образ ядра и окно микросостояния вместо того, чтобы держать всё состояние ядра в окне ядра». Идея та же — по ту сторону границы из пользовательского режима видно только то, без чего не войти, — а конструкция другая: не два дерева, а одно, но маленькое.
Мысль, что раздельные TTBR на ARM64 сами по себе снимают проблему, неверна, и почему именно — разобрано во второй статье вместе с ролью FEAT_E0PD — аппаратного запрета обращаться из EL0 к целой половине карты. Здесь достаточно двух добавлений. Первое: раздельность корней делает переключение дешевле по механике — на arm64 KPTI реализован переключением TTBR1_EL1 между полной и урезанной картой через страницу-трамплин в таблице векторов, то есть меняется только дерево ядра, тогда как на x86-64 переписывается единственный корень со всеми последствиями для тегов. Второе: из этого не следует, что изоляция на ARM64 обходится дешевле, — сравнительных измерений я не нашёл, и утверждать это без них нельзя.
EntryBleed: тамбур, который сам себя выдаёт
У конструкции есть структурный изъян, и он бьёт ровно по той задаче, ради которой KAISER задумывался. Тамбур входа обязан остаться отображённым в пользовательской таблице — иначе входить некуда, — а его адрес жёстко связан с адресом остального ядра. Атака EntryBleed (CVE-2022-4543) этим и пользуется: обработчик entry_SYSCALL_64 лежит на постоянном смещении от базы KASLR, несколько системных вызовов гарантированно затягивают его страницу в TLB инструкций, и запись эта переживает возврат в пользовательский режим, потому что помечена глобальной: pti_clone_pgtable() выставляет _PAGE_GLOBAL всему, что копирует в пользовательскую таблицу, и оговорка документации об отключении глобальных страниц «для всех структур ядра, не отображённых в обе таблицы» тамбура как раз не касается. Дальше дело техники: по времени выполнения инструкции предвыборки перебирается диапазон возможных адресов. Автор описания оценивает надёжность как «почти полную точность при усреднении по ста итерациям» и укладывает всё в сотню строк на C. Уязвимы процессоры Intel; для AMD автор отдельно отмечает, что там работает не этот приём, а более ранняя атака на предвыборку.
Вывод для того, кто проектирует свою ОС, получается двухслойный. Изоляция таблиц — рабочая защита от чтения данных ядра спекуляцией, и её стоит закладывать как возможный режим с самого начала: приделывать два набора таблиц к готовому коду входа дороже, чем предусмотреть их сразу. Но защитой расположения ядра она не является и никогда не была, и строить на этом ничего нельзя.
Окно прямого отображения
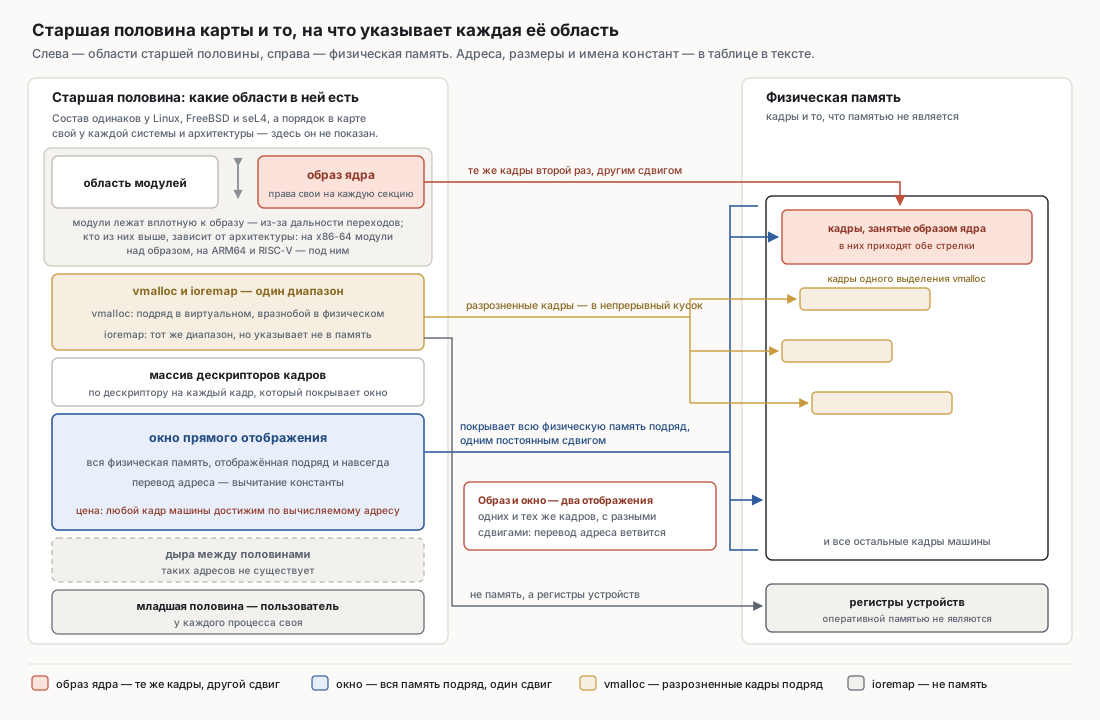
Это центральное решение всей карты. Ядру постоянно нужен доступ к произвольной физической странице: к таблицам страниц, которые оно только что выделило; к страницам файлового кэша, о которых оно знает только номер кадра; к буферам, которые сейчас уйдут в DMA. Заводить под каждое такое обращение временное отображение — это правка таблиц, инвалидация и блокировка вокруг общего пула слотов, то есть дорого и в горячем пути неприемлемо.
Ответ один и тот же у всех: отобразить всю физическую память подряд, одним куском, навсегда. Linux зовёт это direct map на x86-64 и linear map на ARM64, FreeBSD — DMAP, загрузочный протокол Limine — HHDM (higher half direct map), seL4 — окном физической памяти между PPTR_BASE и PPTR_TOP. Показательно последнее: даже формально верифицированное микроядро, у которого драйверов в ядре нет вовсе, окно держит и отображает его большими страницами.
Что оно даёт и чем ограничено
Даёт оно арифметику вместо структуры данных: virt_to_phys — вычитание константы, phys_to_virt — сложение, обе операции без обращений к памяти и без блокировок. Из этого растёт всё остальное — аллокатор страниц может выдавать адрес сразу, а не отображение; дескриптор кадра можно перевести в указатель на его содержимое.
Ограничение прямое и арифметическое: сколько физической памяти влезает в окно, столько система и адресует. У Linux на x86-64 это 64 ТиБ при четырёхуровневой трансляции и 32 ПиБ при пятиуровневой; на ARM64 под линейное отображение отдана вся нижняя половина диапазона TTBR1, то есть 128 ТиБ при 48-битных адресах; на RISC-V Sv39 — 128 ГиБ, и это уже величина, о которую можно удариться. У FreeBSD на amd64 при 48-битных адресах окно занимает 4 ТиБ. У seL4 вся карта ядра — одна запись верхнего уровня, 512 ГиБ, и окно занимает её целиком за вычетом верхнего гигабайта-двух, отданных образу и устройствам.
Платят за окно тем, что вся физическая память достижима из ядра по вычисляемому адресу. Это не абстрактный риск, а готовый примитив эксплуатации, описанный в работе про ret2dir: страница, которую атакующий контролирует из пользовательского процесса, одновременно видна ядру по адресу в окне, и перенаправление испорченного указателя ядра туда обходит SMEP, SMAP и всё, что запрещает ядру прыгать в пользовательские адреса, — потому что прыжок происходит не в пользовательский адрес.
Альтернатива первая: временные отображения
Первый способ отказаться от окна — отображать только часть физической памяти постоянно, а до остального добираться временными отображениями. Так жил 32-битный Linux с highmem, и разбирать это стоит внимательно, потому что это лучший из существующих аргументов в пользу окна.
Устройство было такое: при разделении 3:1 ядру доставался верхний гигабайт, из которого под постоянное отображение уходило около 896 МиБ, а всё, что выше, объявлялось «высокой памятью» и отображалось по требованию. Цена видна по трём местам. Массив дескрипторов кадров обязан лежать в постоянном отображении, и документация выводит потолок прямо: 896 МиБ, делённые на размер дескриптора, — а ведь ядру нужно хранить в этой памяти не только дескрипторы. Интерфейсы временных отображений расслоились на три с разной семантикой: kmap() годится для долгих отображений, но защищён глобальной блокировкой и требует полной инвалидации TLB, когда пул слотов заворачивается; kmap_atomic() дешёв, но создаёт непреемптивную секцию и запрещает отказы страниц; kmap_local_page() — нынешний рекомендованный вариант, а первые два объявлены устаревшими. И, наконец, локальность: отображение, полученное через kmap_local_page(), действительно только в том потоке и на том процессоре, где получено, — то есть указатель нельзя передать никому, и код приходится проектировать под это ограничение.
Механизм жив: 32-битные архитектуры его используют, а на 64 битах те же вызовы вырождаются в арифметику над окном. Но область применения сузилась: в Linux 6.15 удалили CONFIG_HIGHMEM64G, и с тех пор 32-битный x86 не работает с памятью больше четырёх гигабайт вовсе. То есть конструкция, ради которой всё это строилось, официально признана не стоящей поддержки. Для новой ОС это готовый вердикт: временные отображения — не альтернатива окну, а то, чем занимаются, когда адресов не хватает.
Альтернатива вторая: вырезать страницы из окна
Второй способ — окно оставить, но убрать из него отдельные страницы, чтобы ядро не могло дотянуться до того, до чего не должно.
Исследовательский вариант — XPFO: каждая страница, отданная пользовательскому процессу, снимается с отображения в окне и возвращается туда при освобождении, обнулённой. Это прямо закрывает ret2dir. В апстрим он не попал ни за несколько лет, ни за несколько раундов RFC; из возражений содержательнее прочих то, что защита частичная — другие способы эксплуатации остаются, — а из измеримого стоимость около 3 % в худшем случае и 2,5 % на сборке ядра, которую разбор 2016 года объяснял отказом от больших страниц. Объяснение не устояло — чем его заменили, видно в следующем подразделе.
Доехавший до апстрима вариант — memfd_secret(), появившийся в Linux 5.14. Он делает то же самое, но по явной просьбе процесса и только для страниц, которые тот объявил секретом: «область памяти удаляется из таблиц страниц ядра, и соответствующую физическую память отображают только таблицы процессов, держащих файловый дескриптор». Отсюда и его настоящая ценность, сформулированная в man-странице: атакующему, захватившему исполнение в ядре, «пришлось бы либо обойти таблицы страниц и создать новые, либо породить привилегированный процесс», потому что готового примитива для чтения этой памяти в ядре просто нет. В обмен область блокируется в памяти по правилам mlock(), а гибернация запрещается на всё время существования таких дескрипторов. Реализация ограничена архитектурами, где ядро умеет менять права отдельной страницы окна: вызов проверяет can_set_direct_map() и без него отвечает ENOSYS.
Фрагментация окна и что с ней выяснилось
Ходовое объяснение, почему вырезать страницы дорого, звучит так: окно отображено гигабайтными и двухмегабайтными блоками, вырезанная из середины страница дробит блок на мелкие, и давление на TLB растёт для всего ядра сразу. Механика описана верно — на x86-64 гигабайтные отображения окна включаются по умолчанию при наличии соответствующей возможности процессора и отключаются параметром nogbpages, а изменение прав одной страницы вынуждает разломать блок. Неверна оценка последствий, и это тот случай, когда общеизвестное успело устареть.
Майк Рапопорт в 2023 году измерил эффект на процессорах Intel и AMD, сравнивая окно из больших страниц с полностью раздробленным, и получил результаты, которые сам назвал «странными»: улучшения от больших страниц в лучшем случае оказывались много меньше шума измерений, а деградация даже в предельном случае — окно целиком из базовых страниц — держалась в пределах однозначных процентов. Вывод, который LWN передаёт следом, стоит того, чтобы его привести: значительная часть подсистемы управления памятью, возможно, построена для мира, которого больше нет. Практическое следствие видно в ядре: memfd_secret() до Linux 6.5 был выключен по умолчанию и требовал параметра загрузки secretmem.enable=1, а начиная с 6.5 включён по умолчанию — переменная в mm/secretmem.c инициализируется единицей.
Задним числом это разъясняет и цену XPFO. Когда Халид Азиз в 2019 году довёл серию до девятой редакции, счёт предъявили не дроблению карты, а инвалидации: полная защита от ret2dir требует сбрасывать устаревшие записи TLB на всех процессорах, и с честным сбросом системное время параллельной сборки ядра росло в 2,61 раза на четырёхъядерной машине и в 26,37 раза на девяностошестиядерной — тем сильнее, чем больше процессоров рассылают друг другу IPI. Отложенный и групповой сброс вернул это к 1,27 и 1,28 раза соответственно. Ранние оценки, те самые проценты, получены до того, как сброс появился в серии, — а без него защита неполна.
Вторая свежая новость — с той же стороны. В Linux 6.18 arm64 научился разбивать блочные отображения линейной карты по требованию (split_kernel_leaf_mapping()) на тех процессорах, которые умеют менять отображение без разрыва — то самое расширение FEAT_BBM из второй статьи, только выясняемое комбинацией ID_AA64MMFR2_EL1 и списка моделей. До этого режим rodata=full вынуждал отображать всю линейную карту страницами по 4 КиБ с самого начала, просто чтобы иметь возможность когда-нибудь поменять права одной странице. Это и есть настоящая цена фрагментации: не в TLB, а в том, что раньше за возможность вырезать страницу приходилось платить авансом и за всю карту.
Отсюда и ответ на вопрос, вырезать ли страницы в своей ОС. Вырезать — но по явной просьбе, как memfd_secret(), а не поголовно под каждую пользовательскую страницу, как XPFO: дробление карты обходится дёшево, а инвалидация на каждом снятии и возврате — нет, и дорожает она с числом процессоров. Закладывать при этом надо не сам механизм, а возможность его добавить: право менять атрибуты одной страницы окна. Это решение о структуре окна, и принимается оно при построении карты — arm64 до 6.18 показывает цену опоздания, отображая всю линейную карту страницами по 4 КиБ ради правки прав, которой, может, и не случится.
Вердикт для своей ОС: прямое отображение — почти безальтернативный первый шаг, и закладываете вы вместе с ним ровно две вещи. Во-первых, потолок физической памяти, равный размеру окна, — выбирайте его с запасом, потому что менять потом придётся вместе с virt_to_phys. Во-вторых, то, что любой испорченный указатель в ядре дотягивается до всей памяти машины; механизма, который чинил бы это целиком, у вас не будет — вырезание по просьбе закрывает отдельные страницы, а не общий случай, — и рассчитывать придётся на то, что таких указателей нет.
Где лежит образ ядра и почему отдельно от окна
Образ ядра — отдельная область карты, а не часть окна, хотя физически это те самые кадры, которые окно и так покрывает. То есть одни и те же страницы отображены дважды, по двум разным адресам и с двумя разными сдвигами.
Стоимость этого решения видна в самой базовой функции всей подсистемы. Перевод виртуального адреса в физический перестаёт быть вычитанием константы и становится ветвлением: на x86-64 __phys_addr_nodebug() использует флаг переноса, чтобы отличить адрес в образе от адреса в окне, на ARM64 __virt_to_phys_nodebug() проверяет попадание в линейную карту макросом __is_lm_address(), на RISC-V __va_to_pa_nodebug() спрашивает is_linear_mapping(). Все три выглядят одинаково по смыслу:
/* Для адреса из окна вычитание базы образа заворачивается, и y выходит
   больше x; условие x > y и есть проверка «адрес принадлежит образу» */
static __always_inline unsigned long __phys_addr_nodebug(unsigned long x)
{
	unsigned long y = x - __START_KERNEL_map;

	x = y + ((x > y) ? phys_base : (__START_KERNEL_map - PAGE_OFFSET));

	return x;
}
Рядом во всех трёх живёт __pa_symbol() — вариант для адресов, про которые заранее известно, что это символы образа. Существование двух функций вместо одной и есть плата за раздельность.
Модель кода диктует раскладку
Причина, по которой платят, у x86-64 жёсткая и лежит вне ядра — в компиляторе. Ядро Linux собирается с -mcmodel=kernel, и описание этой модели в документации GCC состоит из одной фразы: «Ядро работает в отрицательных двух гигабайтах адресного пространства». Смещения в инструкциях 32-битные и знаковые, поэтому весь код и все данные образа обязаны уместиться в верхние 2 ГиБ, и никакой KASLR не может вынести образ за эти пределы. Отсюда же берётся размер окна для рандомизации: KERNEL_IMAGE_SIZE равен гигабайту при включённом KASLR и половине гигабайта без него, а остаток верхних двух гигабайт отдан модулям.
На ARM64 ограничение другое и мягче, и его легко спутать с моделью кода. Модель по умолчанию адресует данные парой adrp+add в пределах ±4 ГиБ от счётчика команд — этого хватает всегда, и раскладку она поэтому не задаёт (модели кода трёх архитектур сведены в статье про ядро как программу). Связывает раскладку дальность прямого перехода: комментарий над module_init_limits() в arch/arm64/mm/init.c говорит, что перемещения CALL26/JUMP26 имеют дальность ±128 МиБ, «поэтому без PLT мы обязаны обеспечить, чтобы весь текст ядра и весь текст модулей попадал в 128-мегабайтное окно», а «с PLT это окно можно расширить до 2 ГиБ». Сам образ при этом собран перемещаемым и обрабатывает свои релокации при загрузке, поэтому в карте он не привязан ни к какому конкретному адресу — область модулей просто ставится под ним.
На RISC-V ограничение снова в модели кода: 64-битное ядро собирается с medany, дающей двухгигабайтное окно где угодно относительно счётчика команд, 32-битное — с medlow, привязанной к нулю. Раскладка получается прямым следствием: комментарий в arch/riscv/include/asm/pgtable.h над определением KERNEL_LINK_ADDR гласит «оставляем 2 ГиБ под ядро и BPF в конце адресного пространства», а над определением области модулей — «модули всегда живут перед ядром», в двух гигабайтах ниже.
Практическое следствие этой тройки стоит того, чтобы его назвать: соглашение, порождённое одной моделью кода одной архитектуры, стало межархитектурным. Загрузочный протокол Limine требует, чтобы исполняемый образ был отображён «по адресу 0xffffffff80000000 или выше», и требует этого одинаково на x86-64, aarch64 и riscv64 — не потому, что так велит железо, а потому, что все три модели кода туда попадают, и один общий адрес дешевле трёх разных. Та же константа стоит в seL4: на x86-64 PPTR_TOP равен 0xffffffff80000000, а образ отображается сразу за ним — KERNEL_ELF_BASE там определён как PPTR_TOP + KERNEL_ELF_PADDR_BASE. Окно физической памяти заканчивается ровно на этой границе, за которой начинаются верхние два гигабайта, отданные образу и устройствам.
Права на секции и когда они выставляются
Вторая причина держать образ отдельно — права. Окну нужны одни и те же права на всё, образу — разные на каждую секцию: текст исполняемый и только для чтения, .rodata только для чтения и неисполняемая, данные записываемые и неисполняемые.
Момент, когда права появляются, стоит знать точно, потому что до него открыто всё. В Linux функция mark_readonly() вызывается из kernel_init() — после free_initmem(), то есть после того, как отработал весь код инициализации, и непосредственно перед запуском пользовательского процесса. Всё раннее ядро исполняется по записываемому тексту; ARM64 здесь аккуратнее прочих и отображает текст как PAGE_KERNEL_ROX сразу при построении карты, ослабляя это только по явной просьбе rodata=off ради аппаратных отладчиков. Сразу за mark_readonly() идёт debug_checkwx() — проверка, не осталось ли в карте отображений, одновременно записываемых и исполняемых.
Здесь же прячется ловушка, о которой легко забыть: закрыть текст ядра от записи в его собственном отображении недостаточно, потому что те же кадры видны через окно, и там они записываемы. Как это чинится, видно у ARM64 явно: линейный псевдоним диапазона [_text, __init_begin) отображается отдельно и заранее, чтобы права с него можно было снять, не разламывая блочные отображения соседей, а mark_rodata_ro() заканчивается вызовом, объявляющим линейный псевдоним данных и .bss недействительным. Своя ОС, где про псевдоним забыли, получит защиту, которая обходится одним сложением.
Остальные области
Всё, что осталось в карте, существует потому, что окно и образ покрывают не всё.
Область vmalloc даёт виртуально непрерывную память из физически разрозненных кадров. Вопрос «зачем она, если есть окно» имеет ответ из трёх частей. Большие выделения, которым непрерывность физической памяти не нужна, при работе через окно упирались бы в поиск непрерывного диапазона, которого на живой системе может не быть. Права здесь свои на каждую страницу, а не общие на весь блок. И сторожевые страницы получаются бесплатно — между соседними выделениями просто оставляют неотображённую дыру. Плата тоже из трёх частей: адрес из vmalloc нельзя передавать в virt_to_phys (комментарий в arch/x86/include/asm/io.h ограничивает её применимость «адресами из прямого отображения либо полученными через kmalloc»), нельзя отдавать под DMA по той же причине, и отображение по умолчанию идёт базовыми страницами — хотя все три архитектуры умеют и большие, по явному флагу VM_ALLOW_HUGE_VMAP.
Стеки ядра при включённом VMAP_STACK живут именно здесь, и ради той самой сторожевой страницы: переполнение стека ловится немедленно, а не портит соседнюю структуру. Все следствия этого решения — от невозможности сделать DMA из буфера на стеке до того, что стек больше не физически непрерывен, — разбираются в статье про стеки.
Область модулей отделена от vmalloc именно из-за дальности переходов, разобранной выше. На x86-64 она примыкает к образу сверху; на ARM64 и RISC-V вычисляется при загрузке от фактического адреса образа.
Массив дескрипторов физических кадров (vmemmap в терминах Linux) — отдельная область, размер которой пропорционален размеру окна: по дескриптору на каждый кадр, который окно способно покрыть. Это самая крупная статья постоянного расхода виртуального пространства после самого окна.
Фиксированные отображения (fixmap) — набор слотов, виртуальные адреса которых известны на этапе компоновки. Смысл именно в этом: слот нужен коду, работающему до того, как появился аллокатор виртуальных адресов, — раннему выводу на консоль, ранним отображениям таблиц ACPI. Из той же потребности выросла и cpu_entry_area, та самая структура, которая одна остаётся видимой при включённом KPTI: ей нужен адрес, известный на этапе компоновки, и на x86-64 под неё выделена собственная запись верхнего уровня (CPU_ENTRY_AREA_PGD), а не место в fixmap, о котором говорит документация про PTI. Документация при этом не устарела, а описывает 32-битное устройство: там база области действительно отсчитывается от края fixmap. «Верхнего уровня» тоже верно не всегда — база считается как CPU_ENTRY_AREA_PGD << P4D_SHIFT, так что при пяти уровнях трансляции это запись уровня P4D.
Отображения устройств (ioremap) технически живут в диапазоне vmalloc, но отличаются тем, куда указывают: не на оперативную память, а на регистры, и с атрибутами кэширования, запрещающими объединение и переупорядочение обращений.
Области на процессор — не столько область карты, сколько дисциплина адресации. Память под них берётся обычным способом, а обращение идёт как «базовый адрес текущего процессора плюс смещение переменной», где базу хранит регистр: сегментный GS на x86-64, TPIDR_EL1 (или TPIDR_EL2 под VHE) на ARM64. На RISC-V выделенного регистра базы нет — своего asm/percpu.h у архитектуры не заведено, и работает общий механизм: смещение берётся из массива __per_cpu_offset[] по номеру процессора, а номер лежит в структуре текущей задачи, на которую указывает tp. То есть там, где две другие архитектуры читают регистр, RISC-V идёт в память. Отдельного диапазона адресов под это не резервируется нигде.
Теневая память санитайзеров (KASAN) занимает фиксированную долю ядерного пространства — по байту на несколько байт отслеживаемой памяти. Занимает столько, что на x86-64 её включение отключает KASLR: перекрытие диапазонов иначе неизбежно.
Итоговая карта
Числа ниже — для Linux; порядок областей у FreeBSD и seL4 другой, а состав тот же. У x86-64 и RISC-V раскладка задокументирована в дереве ядра; у ARM64 таблицы в документации больше нет, и значения в колонке посчитаны из констант arch/arm64/include/asm/memory.h при 48-битных адресах, странице 4 КиБ и 64-байтном дескрипторе кадра.
| Область | x86-64, 4 уровня | ARM64, 48 бит | RISC-V Sv39 |
|---|---|---|---|
| Прямое отображение | 64 ТиБ | 128 ТиБ — вся нижняя половина TTBR1 | 128 ГиБ |
vmalloc/ioremap |
32 ТиБ | от образа до массива дескрипторов | 64 ГиБ |
| Массив дескрипторов кадров | 1 ТиБ | 2 ТиБ, у верхнего края | 4 ГиБ |
| Теневая память KASAN | 16 ТиБ | 1/8 ядерного пространства (1/16 в режиме тегов); при включении сдвигает вниз конец линейной карты | 32 ГиБ |
| Область модулей | 1520 МиБ (1 ГиБ при KASLR) | 128 МиБ без PLT или 2 ГиБ с PLT | 2 ГиБ под образом |
| Образ ядра | верхние 2 ГиБ, окно 512 МиБ или 1 ГиБ | произвольное место в vmalloc |
верхние 2 ГиБ |
fixmap |
около 0,5 МиБ у верхнего края | у верхнего края | 6 МиБ |
Посмотреть настоящую карту работающей системы можно через debugfs, если ядро собрано с CONFIG_PTDUMP_DEBUGFS. Имена файлов различаются: ARM64 и RISC-V отдают один файл, x86-64 — каталог с несколькими, причём current_user в нём появляется только тогда, когда ядро собрано с поддержкой изоляции таблиц.
# ARM64, RISC-V
sudo cat /sys/kernel/debug/kernel_page_tables

# x86-64: kernel — эталонная карта, current_kernel и current_user —
# два набора таблиц текущего процесса, второй только при KPTI
sudo ls /sys/kernel/debug/page_tables/
sudo cat /sys/kernel/debug/page_tables/current_user
Смотреть тут стоит не адреса, а два столбца справа: размер отображения и права. По ним сразу видно, каким блоком отображено окно, где оно раздроблено на базовые страницы и не осталось ли записываемо-исполняемых участков.
KASLR
Рандомизируются области независимо друг от друга, и набор рандомизируемого различается по архитектурам сильнее, чем принято думать.
На x86-64 Linux двигает и образ, и три крупные области карты — прямое отображение, vmalloc и массив дескрипторов, — сохраняя их взаимный порядок и меняя базы; за это отвечает отдельная опция CONFIG_RANDOMIZE_MEMORY, включённая вместе с основной. Область модулей смещается своим маленьким сдвигом от одной до 1024 страниц. На ARM64 двигаются образ и область модулей, причём вторая независимо от первого — при CONFIG_RANDOMIZE_MODULE_REGION_FULL в двухгигабайтном окне вокруг ядра, ценой переходов через PLT. На RISC-V двигается только образ. Аналога RANDOMIZE_MEMORY нет ни на той архитектуре, ни на другой: крупные области карты стоят на месте.
Различается и то, откуда берётся энтропия, и это существенно для того, кто пишет свою ОС. На x86-64 ядро добывает случайность само, инструкцией RDRAND с примешиванием RDTSC, а при отсутствии обеих — с таймера; опция включена по умолчанию. На ARM64 и RISC-V опция по умолчанию выключена, и обе Kconfig-справки говорят одно и то же: «Работа загрузчика — предоставить энтропию, передав случайное 64-битное значение в /chosen/kaslr-seed при входе в ядро». Справки, однако, отстали от кода. На ARM64 kaslr_early_init() при пустом kaslr-seed пробует добыть зерно сам, инструкцией RNDR из FEAT_RNG, и сдаётся, только если расширения нет. На RISC-V порядок и вовсе обратный написанному: setup_vm() сначала спрашивает расширение Zkr через __pi_get_kaslr_seed_zkr() и лишь при нулевом ответе идёт в device tree. То есть на процессоре с аппаратным источником случайности обе архитектуры самосеются ровно как x86-64 с RDRAND, а договорённость с загрузчиком обязательна там, где такого источника нет. Что действительно отличает эти две архитектуры от x86-64 — выключенное умолчание сборки: KASLR там надо сначала включить.
Сколько энтропии на самом деле
Разброс между архитектурами оказывается порядковым, и причина у него та же, что задавала раскладку образа, — модель кода.
На x86-64 виртуальный адрес образа «рандомизируется от 16 МиБ до 1 ГиБ (9 бит энтропии)», как прямо написано в справке CONFIG_RANDOMIZE_BASE. Там же названа и причина потолка: «полезная энтропия ограничена тем, что ядро собрано с двухгигабайтной адресацией, и тем, что PHYSICAL_ALIGN не может быть меньше 2 МиБ, поэтому теоретически возможны только 10 бит». Девять бит — это 512 вариантов; полный перебор с перезагрузкой тут не нужен, хватает одной удачной утечки. Крупные области карты рандомизируются гораздо щедрее: комментарий в arch/x86/mm/kaslr.c обещает «в среднем 30 000 возможных виртуальных адресов для каждой области» в лучшей конфигурации.
На RISC-V ограничение видно в коде дословно: число позиций считается как (PUD_SIZE - kernel_size) / PMD_SIZE, и комментарий объясняет почему — «мы ограничены ранней таблицей страниц, у которой всего один PUD, и обязаны быть выровнены по PMD_SIZE». То есть меньше 512 позиций, и тем меньше, чем крупнее ядро.
На ARM64 картина другая, и в лучшую сторону: образ помещается «в среднюю половину области vmalloc», а гранулярность — 2 МиБ, минимальное выравнивание образа. Формула в kaslr_early_init() короткая: range = (VMALLOC_END - KIMAGE_VADDR) / 2, смещение внутри неё — range / 2 плюс заданная зерном доля от range, а вызывающий код в map_kernel.c маскирует результат до MIN_KIMG_ALIGN, то есть до тех же 2 МиБ. При 48-битных адресах range измеряется десятками терабайт, и деление на гранулярность даёт порядка двадцати пяти бит; это моя арифметика из констант asm/memory.h, а не документированное число. Причина преимущества ровно та, что разбиралась выше: перемещаемый образ ARM64 не обязан оставаться в верхних двух гигабайтах, а образ x86-64 обязан.
Что её сводит на нет
Энтропия здесь — не главная величина, потому что защита пробивается не перебором.
Любая утечка одного ядерного указателя раскрывает базу целиком: смещения внутри образа известны из общедоступного бинарника, и по одному адресу восстанавливаются все остальные. Дальше идут атаки по времени, не требующие никакой утечки: описанная выше EntryBleed добывает базу через тамбур KPTI за секунды. И, наконец, конфигурации, где KASLR выключается сам: включённый KASAN отключает его на x86-64, потому что диапазоны не помещаются рядом.
Обратное тоже верно и полезно как пример связности механизмов: на ARM64 KASLR умеет принудительно включать KPTI. Функция kaslr_requires_kpti() возвращает истину везде, где нет FEAT_E0PD, и тогда изоляция таблиц включается даже на процессоре, признанном безопасным по CSV3, — не ради данных, а ради адресов.
Мелкогранулярный KASLR
Идея очевидна из предыдущего абзаца: если одна утечка раскрывает всё, надо сделать так, чтобы не раскрывала. FGKASLR собирал ядро с -ffunction-sections, разбирал ELF при распаковке и раскладывал функции по случайным местам, правя релокации. Тогда знание адреса одной функции не даёт адреса другой.
Стоимость авторы измерили: около секунды к загрузке, примерно 15 % к размеру сжатого образа, около 1 % к времени работы за счёт промахов кэша инструкций. До апстрима серия не доехала: последняя редакция, девятая, датируется концом 2021 года, а в mainline на дату сверки нет ни одной опции с этим именем — в дерево попали только подготовительные правки вроде расширения диапазона таблицы раскрутки на весь _etext - _stext.
Вердикт называть своими словами стоит прямо: KASLR — не защита, а подорожание эксплойта. Он не мешает атаке, у которой есть утечка указателя, и не мешает атаке по времени; он мешает атаке, у которой нет ни того ни другого, и заставляет искать лишнюю уязвимость. Включать его надо — сдвиг базы при загрузке стоит почти ничего, — но проектировать в расчёте на то, что адреса ядра секретны, нельзя ни в одном месте.
Три системы, четыре решения
| Linux | FreeBSD (amd64) | seL4 | |
|---|---|---|---|
| Ядро в пространстве процесса | да, старшая половина | да, старшая половина | да, старшая половина; в режиме гипервизора — младшая |
| Изоляция таблиц | по признакам процессора; в пользовательской таблице только тамбур входа | по признакам процессора; в пользовательской таблице весь текст ядра | по решению при сборке; вместо второго дерева — урезанное окно ядра |
| Окно физической памяти | direct/linear map, 64 ТиБ на x86-64 | DMAP, 4 ТиБ при 48-битных адресах | окно между PPTR_BASE и PPTR_TOP, большими страницами |
| Образ ядра | отдельная область, отдельный сдвиг | отдельная область, KERNBASE — константа сборки |
отдельная область над окном |
| Рандомизация | образ везде, крупные области только на x86-64 | нет: раскладка выбирается между двумя вариантами сборки | нет |
Одну клетку стоит оговорить отдельно. «Нет» у FreeBSD — вывод отрицательный и сделанный по косвенным признакам: KERNBASE на amd64 константа сборки, kva_layout выбирает один из двух статических вариантов под LA48 и LA57, поиск по истории src ничего не находит. Отсутствие механизма доказывается хуже, чем его наличие, и относится это «нет» к базовой системе, а не к семейству: у NetBSD, например, KASLR ядра есть с версии 9.0 на amd64, отдельной сборкой GENERIC_KASLR.
Из таблицы стоит унести две вещи. Первая: разброс проходит не по «монолит против микроядра». Верифицированное микроядро держит окно физической памяти, отображает ядро в каждое пространство и прячет его от пользователя после Meltdown ровно по тем же причинам, что и монолит, — это решения про стоимость входа, про доступ к произвольному кадру и про спекуляцию, а не про структуру ядра. Вторая: единственное решение, по которому системы реально расходятся, — рандомизация, и расходятся они потому, что это единственное из четырёх, которое ничего не даёт бесплатно и мало что даёт вообще.
Вердикт для своей ОС
Порядок действий получается такой, и он же порядок необратимости.
Начинайте с общей карты и ядра в старшей половине — альтернативы у 64-битной системы нет, а выигрыш (вход в ядро без смены корня и без сброса TLB) виден с первого системного вызова. Прямое отображение стройте сразу, размер окна выбирайте с запасом относительно памяти, которую рассчитываете адресовать: это единственное число в карте, изменение которого потом тянет за собой virt_to_phys и всё, что через неё написано.
Образ ядра кладите отдельной областью, а не внутрь окна, даже если в начале это выглядит лишней работой. Иначе вы не сможете ни выставить права по секциям, ни сдвинуть образ рандомизацией, ни собрать его моделью кода, отличной от той, что диктует окно. Заводите __pa() и __pa_symbol() двумя функциями с самого начала — переделывать вызовы потом придётся по всему дереву.
Права на секции и снятие прав с линейного псевдонима планируйте вместе. Псевдоним — единственная часть этой работы, которую легко забыть, и его пропуск обесценивает всё остальное.
Изоляцию таблиц закладывайте как возможный режим, даже если включать её не собираетесь: конструкция обязывает иметь отдельный вход, работающий по урезанной карте, и вписать это в готовый код входа дороже, чем сразу написать вход так, чтобы он это допускал. Асимметрию соблюдайте с самого начала — полный набор таблиц отображает и пользователя, чтобы копирование из пользовательской памяти оставалось разыменованием указателя. В пользовательскую таблицу кладите только тамбур: пока путей входа немного, перечислить их ничего не стоит, а потом будет стоить.
Рандомизацию делайте последней. Она требует перемещаемого образа и обработки релокаций при загрузке, а даёт ровно подорожание эксплойта. Если целевая архитектура ARM64 или RISC-V, зерно придётся откуда-то взять: аппаратный источник (RNDR, Zkr) есть не на всяком процессоре, и без него остаётся договорённость с загрузчиком.
Дальше — стеки, где решается, свой ли стек у каждого потока или один на процессор, и почему стек ядра нельзя растить по отказу страницы; ядро как программа, где модели кода из этой статьи встречаются со скриптом компоновки; физическая память и задача раскрутки, где для построения первых таблиц нужна память, которую ещё нечем выделять; и вход в ядро, где разбирается уже не карта, а то, что происходит на границе в момент её пересечения. Порядок и состав — в плане цикла.
Источники
- Memory Management — раскладка виртуальной памяти x86-64, документация ядра Linux — полные таблицы для четырёх- и пятиуровневой трансляции, размеры окна прямого отображения,
vmalloc, массива дескрипторов и теневой памяти KASAN, отображение образа по адресу −2 ГиБ, оговорка проCONFIG_RANDOMIZE_MEMORYи про то, что KASAN отключает KASLR - Memory Layout on AArch64 Linux — документация ядра Linux — выбор
TTBRпо биту 55,swapper_pg_dirтолько в TTBR1, 52-битные адреса и требование к образу быть инвариантным к разрядности; таблицы раскладки в этом документе отсутствуют - Virtual Memory Layout on RISC-V Linux — документация ядра Linux — таблицы для Sv39, Sv48 и Sv57; область модулей и BPF под образом, образ в верхних 2 ГиБ
- High Memory Handling — документация ядра Linux — почему ядро отображают в каждое пространство, разделение 3:1 и предел около 896 МиБ, потолок числа дескрипторов кадров, семантика
kmap(),kmap_atomic()иkmap_local_page()и объявление первых двух устаревшими - Page Table Isolation (PTI) — документация ядра Linux — два набора таблиц, содержимое
cpu_entry_area, бит NX на верхнем уровне пользовательской таблицы, стоимость записи вCR3порядка сотни тактов, потеря глобальных страниц «не более 1 %», расход на каталог порядка 1,cpu_entry_area«вfixmap» — описание 32-битного устройства - memfd_secret(2) — man-страница Linux — удаление страниц из таблиц ядра, появление в 5.14, выключенное по умолчанию состояние до 6.5 и параметр
secretmem.enable, блокировка в памяти и запрет гибернации,ENOSYSтам, где механизм недоступен - Исходники ядра Linux (проверялось на mainline 7.3-rc1, стабильным на дату сверки был 7.2.3):
arch/x86/include/asm/page_64_types.h—KERNEL_IMAGE_SIZE1 ГиБ при KASLR и 512 МиБ без него,__START_KERNEL_map, объяснение зазора под LDT и гипервизор;arch/x86/include/asm/page_64.h—__phys_addr_nodebug()и__phys_addr_symbol();arch/x86/mm/pgtable.c— копирование записей ядра в новый каталог вpgd_ctor();arch/x86/mm/kaslr.c— «30 000 возможных виртуальных адресов» и список рандомизируемых областей;arch/x86/mm/pti.c—pti_clone_pgtable(), выставляющий_PAGE_GLOBALвсему, что копирует в пользовательскую таблицу;arch/x86/Kconfig— 9 бит энтропии образа и потолок в 10 бит,RANDOMIZE_MEMORY,X86_DIRECT_GBPAGES,MITIGATION_PAGE_TABLE_ISOLATION, отсутствиеHIGHMEM64Gи комментарий «wait for LASS» уADDRESS_MASKING;arch/x86/mm/init.c—gbpages/nogbpagesи область модулей со сдвигом от 1 до 1024 страниц;arch/x86/mm/debug_pagetables.c— файлыpage_tables/{kernel,current_kernel,current_user}и условие появления последнего;arch/arm64/include/asm/memory.h—PAGE_OFFSET,PAGE_END,MODULES_VADDR,KIMAGE_VADDR,__is_lm_address()и__virt_to_phys_nodebug();arch/arm64/mm/init.c— комментарий надmodule_init_limits()про дальностьCALL26/JUMP26в 128 МиБ и расширение до 2 ГиБ через PLT; вarch/arm64/kernel/module.cэтого кода больше нет, он уехал вместе с переводом на execmem;arch/arm64/mm/mmu.c—split_kernel_leaf_mapping(),force_pte_mapping()и объявление линейного псевдонима данных недействительным вmark_rodata_ro();arch/arm64/mm/pageattr.c—can_set_direct_map();arch/arm64/kernel/pi/kaslr_early.cиarch/arm64/kernel/pi/map_kernel.c— зерно изkaslr-seedс откатом наRNDRпри наличии FEAT_RNG, формулаrange = (VMALLOC_END - KIMAGE_VADDR) / 2, размещение образа в средней половинеvmallocи маскирование смещения доMIN_KIMG_ALIGNв 2 МиБ;arch/arm64/kernel/cpufeature.c—kpti_safe_list[]иkaslr_requires_kpti();arch/arm64/Kconfig—UNMAP_KERNEL_AT_EL0по умолчанию включён,ARM64_E0PD, KASLR по умолчанию выключен и его справка требует зерна от загрузчика;arch/riscv/include/asm/pgtable.h— «оставляем 2 ГиБ под ядро и BPF» и «модули всегда живут перед ядром»;arch/riscv/Makefileиarch/riscv/Kconfig—medanyпо умолчанию на 64 битах,medlowна 32;arch/riscv/mm/init.c— порядок источников зерна KASLR вsetup_vm()(расширение Zkr первым, device tree запасным), число позиций и объяснение про единственный PUD;mm/secretmem.c— включение по умолчанию иset_direct_map_invalid_noflush();init/main.c—mark_readonly()послеfree_initmem()иdebug_checkwx();arch/x86/include/asm/io.h— область применимостиvirt_to_phys();arch/x86/kernel/cpu/common.c— выставлениеX86_BUG_CPU_MELTDOWNпоcpu_vuln_whitelistиARCH_CAP_RDCL_NO;arch/x86/include/asm/pgtable_64_types.h—CPU_ENTRY_AREA_PGDкак собственная запись верхнего уровня и её база какCPU_ENTRY_AREA_PGD << P4D_SHIFT;include/asm-generic/percpu.h—__my_cpu_offsetчерез массив__per_cpu_offset[]там, где у архитектуры нет своего механизма (у RISC-V нет). ОпцияCONFIG_HIGHMEM64Gприсутствует вv6.14и отсутствует вv6.15;split_kernel_leaf_mapping()отсутствует вv6.17и присутствует вv6.18 - Исходники FreeBSD:
sys/amd64/include/vmparam.h— карта для LA48 и LA57, 4 ТиБ DMAP,KERNBASE,PHYS_TO_DMAP;sys/arm64/include/vmparam.hиsys/riscv/include/vmparam.h— границы DMAP на этих архитектурах;sys/amd64/amd64/pmap.c— устройство PTI и его взаимодействие с PCID, весь текст ядра в трамплине,kva_layoutкак выбор из двух вариантов сборки без рандомизации;sys/x86/x86/identcpu.c—pti_get_default(). Штатной рандомизации карты ядра в базовой системе я не нашёл:KERNBASEна amd64 — константа сборки,kva_layout— выбор из двух статических вариантов под LA48 и LA57, а поиск по истории коммитовsrcпо слову KASLR не даёт ничего - Исходники seL4:
include/arch/arm/arch/64/mode/hardware.h,include/arch/riscv/arch/64/mode/hardware.hиinclude/plat/pc99/plat/64/plat_mode/machine/hardware.h— окно физической памятиPPTR_BASE…PPTR_TOPбольшими страницами, образ и устройства в верхнем гигабайте-двух, совпадениеPPTR_TOPс0xffffffff80000000на x86-64, объяснение переноса окна в младшую половину в режиме гипервизора;src/arch/x86/config.cmake— опцияKernelSkimWindow, включённая по умолчанию, и её формулировка про сокращённый статический образ и окно микросостояния - Using KASLR — вики NetBSD — KASLR ядра в NetBSD с версии 9.0 на amd64 и отдельная сборка
GENERIC_KASLR - Limine Boot Protocol — требование грузить образ по адресу
0xffffffff80000000или выше на всех архитектурах, HHDM и его смещение, рандомизация базы окна загрузчиком - 4G/4G split on x86, 64 GB RAM (and more) support — анонс Инго Молнара, LWN, июль 2003 — мотив (массив дескрипторов в гигабайте нижней памяти), трамплин в верхних 16 МиБ как единственная общая область, косвенные примитивы uaccess, плюс 3 микросекунды к системному вызову и от 0 до 30 % по времени работы
- KAISER: hiding the kernel from user space — LWN, ноябрь 2017 — исходная задача (атаки по сторонним каналам на KASLR, а не Meltdown), устройство теневых таблиц, оценка «5 % — хорошее круглое число» и худшие около 30 %
- KPTI/KAISER Meltdown Initial Performance Regressions — Brendan Gregg, февраль 2018 — модель стоимости по частоте системных вызовов, влиянию рабочего множества и наличию PCID
- EntryBleed: Breaking KASLR under KPTI with Prefetch (CVE-2022-4543) — разбор автора находки, блог Will's Root — утечка адреса
entry_SYSCALL_64через тайминг предвыборки, роль оставшегося отображённым тамбура, разница между Intel и AMD - ret2dir: Rethinking Kernel Isolation (Kemerlis, Polychronakis, Keromytis, USENIX Security '14) — окно прямого отображения как готовый примитив обхода SMEP, SMAP и программных защит от ret2usr
- Exclusive page-frame ownership — LWN, сентябрь 2016 — устройство XPFO, стоимость около 3 % в худшем случае и 2,5 % на сборке ядра, возражения о частичности защиты
- Add support for eXclusive Page Frame Ownership — сопроводительное письмо девятой редакции серии, Халид Азиз, апрель 2019, копия на LWN — цена XPFO как цена инвалидации TLB, а не дробления карты: 2,61x и 26,37x системного времени параллельной сборки ядра при честном сбросе устаревших записей, 1,27x и 1,28x после отложенного и группового сброса
- Reconsidering the direct-map fragmentation problem — LWN, май 2023 — измерения Рапопорта на Intel и AMD, вывод об отсутствии значимой деградации и предложение включить секретную память по умолчанию
- Solutions for direct-map fragmentation — LWN, май 2022 — перечень источников фрагментации (BPF, секретная память, SNP и TDX) и идея сводить вырезанные страницы в уже разломанный блок
- Function Granular KASLR — сопроводительное письмо серии v3, Кристен Карлсон Аккарди, июнь 2020, копия на LWN — почему одной утечки достаточно, устройство перемешивания функций, около секунды к загрузке, 15 % к размеру сжатого образа и около 1 % к времени работы
- x86 Options — документация GCC, AArch64 Options, RISC-V Options — формулировки моделей кода: «ядро работает в отрицательных двух гигабайтах», диапазоны
tiny/small/largeдля AArch64,medlowиmedanyдля RISC-V
Связанные заметки
- Страничная трансляция: таблицы, TLB, разрядность — вторая статья цикла: корни трансляции, каноничность, теги адресных пространств и инвалидация, на которые опирается эта карта
- Адресное пространство: зачем трансляция и какие есть альтернативы — первая статья цикла: зачем трансляция вообще нужна и чем её пытались заменить
- Стеки: ядра, прерываний, пользовательские — четвёртая статья цикла: стеки ядра в области
vmalloc, сторожевые страницы и что из этого следует - Ядро как программа: freestanding, компоновка, ABI, выбор языка — восьмая статья цикла: модели кода и скрипт компоновки с другой стороны — со стороны сборки образа
- Устройство ОС — план цикла статей — состав и порядок цикла
- Linux — безопасность: hardening, SELinux/AppArmor — те же механизмы со стороны эксплуатации: что включено в дистрибутиве и чем это проверяется
- Linux — ядро: сборка, модули, параметры — параметрами загрузки и конфигурацией задаются
nopti,nokaslr,rodataи размещение модулей - Linux — справочник команд: память — наблюдаемая сторона тех же механизмов на живой системе
- Вход в ядро и переключение контекста — седьмая статья цикла: как выглядит пересечение границы, за которое платит изоляция таблиц
- Физическая память: от карты firmware до аллокатора — пятая статья цикла: чем заполняют эту карту — разбор карты от прошивки, раскрутка аллокатора и дескрипторы кадров, под которые здесь отведена отдельная область
- Загрузка: от питания до первой инструкции ядра — шестая статья цикла: как ядро попадает в эту карту — включение трансляции, переходное отображение и прыжок в верхнюю половину
- Структура ядра: монолит, микроядро и что между — девятая статья цикла: кому нужно окно прямого отображения и почему серверу микроядра оно не выдаётся
Из библиотеки института уносят только знания. Читателей здесь не считают: посещение не регистрируется, отметок в издании не остаётся, счётчиков нет ни у одного издания фонда.
Издание пополняется и пересверяется. Текст доступен на условиях CC BY-SA 4.0 — унесённое можно передавать дальше на тех же условиях.