Единственное открытое решение цикла
Восемь предыдущих статей разбирали механизмы, в которых выбор был или иллюзорным, или очень узким. Растить стек ядра по отказу страницы нельзя не потому, что так решили, а потому, что обработчик отказа исполняется на том самом стеке, которого не хватило. Ядро отображают в старшую половину каждого процесса потому, что иначе каждый системный вызов оплачивает смену корня трансляции. Точку входа пишут на ассемблере потому, что до формирования кадра состояние не описывается никаким соглашением о вызовах. Железо задавало вопрос и почти всегда подсказывало ответ.
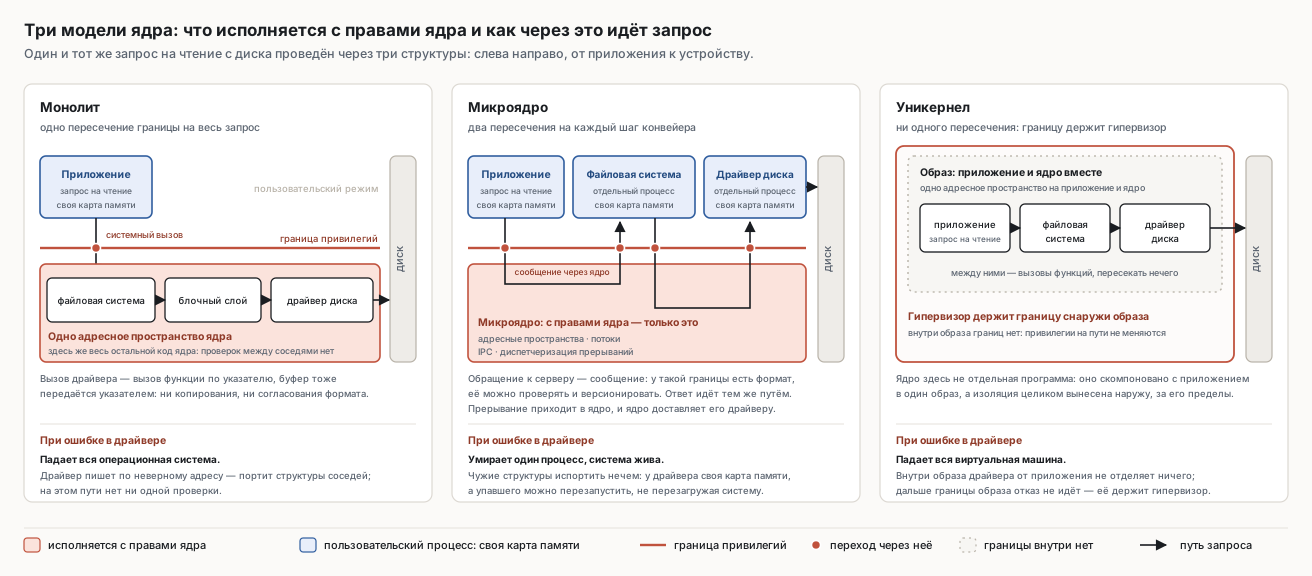
Здесь не так. Структура ядра — решение, которое принимает автор, и принимает его один раз. Оно определяет, чем является обращение к драйверу: вызовом функции по указателю в той же карте памяти или сообщением, которое пересекает границу привилегий дважды и приходит процессу с собственным адресным пространством. От этого зависит, что происходит при ошибке в драйвере, что попадает в доверенную базу, можно ли ядро верифицировать, и — как показывает последний раздел — почти всё, что разбирали предыдущие восемь статей. Переделать это потом невозможно: смена модели переписывает не подсистему, а способ, которым подсистемы разговаривают друг с другом.
Вокруг этого решения выросла мифология, и разбирать её приходится отдельно от предмета. «Микроядра медленные» — тезис с конкретной историей: конкретные измерения на конкретном железе тридцать лет назад, конкретный вывод, который из них сделали, и другой вывод, который из них следовал. Статья восстанавливает эту цепочку по первоисточникам, потому что иначе выбор делается по фольклору. К системе команд предмет не привязан, поэтому паритета трёх архитектур здесь нет — единственное место в цикле, где он не нужен.
Что значит «в ядре»
Привилегия и адресное пространство
«В ядре» — не место в дереве исходников и не способ сборки. Это сочетание двух свойств: уровня привилегий, на котором код исполняется, и адресного пространства, в котором он живёт. Точнее всего это сформулировано в документации Microsoft для авторов драйверов, и формулировка стоит того, чтобы её привести целиком: «весь код, исполняющийся в режиме ядра, разделяет единое виртуальное адресное пространство. Поэтому драйвер режима ядра не изолирован от других драйверов и от операционной системы. Если драйвер режима ядра по ошибке пишет по неверному виртуальному адресу, он может испортить данные, принадлежащие операционной системе или другому драйверу. Если драйвер режима ядра падает, он роняет всю операционную систему».
Это описание монолита, сделанное вендором в справочнике для разработчиков, а не в полемике. И оно же — определение: две подсистемы находятся «в одном ядре» ровно тогда, когда одна может испортить структуры другой обычной записью в память, без единой проверки на пути.
Модуль не меняет модель
Самая частая подмена в этом разговоре — считать модульность разновидностью микроядерности. Загружаемый модуль связывается с ядром при загрузке: разрешаются символы, экспортированные ядром, выделяется память, вызывается функция инициализации (статья про ядро Linux разбирает этот путь со стороны администратора). После этого его код исполняется с теми же правами и в той же карте памяти, что и остальное ядро. Модульность отвечает на вопрос «когда код связывается с ядром», изоляция — на вопрос «где он исполняется», и это два независимых вопроса. Ровно поэтому подпись модулей — механизм безопасности: загрузить модуль означает исполнить произвольный код в ядре, и другого способа это ограничить, кроме как проверять происхождение файла, нет.
Есть и третья ось, которую тоже путают с первыми двумя: внутри дерева исходников код или снаружи. Она про сопровождение, а не про исполнение, и документ ядра Linux о том, почему стабильного внутреннего API не будет, объясняет разницу лучше любого пересказа: раскладка структур зависит от версии компилятора и набора опций сборки, «драйверы в бинарном виде с одной архитектуры не заработают на другой», а рекомендуемый выход — «затащить свой драйвер в основное дерево ядра», после чего при изменении интерфейса «его поправит тот, кто это изменение и сделал». Три оси, три разных вопроса; смешивать их — верный способ решить не ту задачу.
TCB — единственная честная метрика
Доверенная вычислительная база (TCB) определяется как «подмножество системы, которое обязано работать правильно, чтобы система была безопасна». Метрика неудобная — её нельзя измерить одним числом из головы, — но она единственная, по которой две модели сравниваются честно, потому что все остальные различия из неё выводятся: и что случится при ошибке в драйвере, и какова поверхность атаки, и поддаётся ли ядро верификации.
Считать её надо аккуратно, и здесь легко ошибиться в обе стороны. TCB — это не размер дерева исходников: в вашем ядре исполняется то, что собрано в образ, плюс загруженные модули, а не все драйверы мира. Но TCB — это и не только ядро: в неё входит всё, чему приходится доверять, включая компилятор, если нет доказательства соответствия бинарника исходнику. Порядок величин тем не менее не оставляет пространства для спора. seL4 в статье 2009 года — 8700 строк на C и 600 строк на ассемблере. Ядро Linux по оценке в вводной части документа seL4 Foundation — порядка двадцати миллионов строк, и оттуда же вывод: разница в три порядка, а плотность ошибок с ростом кода растёт, вероятно, быстрее линейного.
Дальше вся статья — про то, чем за эти три порядка платят и в каких задачах платить стоит.
Монолит
Так устроены Linux и FreeBSD: файловая система, блочный слой, сетевой стек и драйверы живут в одном адресном пространстве и вызывают друг друга напрямую.
Главная выгода измеряется в тактах, и лучшее известное мне измерение — из работы про UnderBridge (USENIX ATC '20, Xeon Gold 6138): вызов между компонентами монолитного ядра — это косвенный call/ret, и полный оборот занимает 24 такта. На той же машине оборот межпроцессного вызова между двумя серверами в seL4 — 1450 тактов. Шестьдесят раз. Это и есть цифра, вокруг которой строится весь спор, и держать её в голове полезно с самого начала, потому что дальше выяснится, что она почти ничего не решает.
Вторая выгода менее заметна, но на практике весит больше: структуры данных общие. Страничный кэш, который наполняет файловая система, — тот же массив дескрипторов кадров, которым оперирует блочный слой; передать буфер драйверу означает передать указатель. Ни сериализации, ни копирования, ни согласования форматов между версиями. Именно поэтому монолитное ядро можно писать эволюционно: новая подсистема сразу видит всё, что уже есть.
Платят за это тремя вещами, и они разного свойства.
Первое — отказоустойчивость, точнее её отсутствие: процитированный выше абзац из документации Microsoft и есть счёт. Мировая демонстрация этого счёта случилась в июле 2024 года, когда неудачное обновление к продукту безопасности, работавшему драйвером режима ядра, вывело из строя, по оценке самой Microsoft, «8,5 миллиона устройств Windows, то есть менее одного процента всех машин Windows». Меньше процента — и этого хватило, чтобы через год компания начала строить платформу, позволяющую антивирусам работать вне ядра; об этом ниже.
Второе — поверхность атаки размером с ядро. Любая ошибка в любом драйвере даёт полные права, а не права драйвера, и никакого механизма, который ограничил бы её последствия, в модели нет.
Третье и самое неочевидное: внутренние интерфейсы невозможно зафиксировать. Причина не в политике проекта, а в том, что граница подсистемы здесь — сигнатура функции и раскладка структуры, а не протокол. Стабилизировать такую границу означает заморозить раскладку структур ядра и семантику каждого экспортированного символа во всех конфигурациях сборки; документ ядра Linux на эту тему перечисляет, почему это невыполнимо технически, и заканчивает единственным работающим ответом — держать драйвер в общем дереве. Разница между двумя моделями видна на двух строчках:
/* монолит: граница — вызов по указателю, аргумент — указатель на буфер;
   у неё нет ни формата, ни версии, ни способа проверить аргументы */
ssize_t n = disk->ops->read(disk, lba, buf, len);

/* микроядро: граница — сообщение, у которого формат есть по построению,
   а вызов возвращается только после четырёх пересечений границы привилегий */
struct disk_request req = { .op = DISK_READ, .lba = lba, .len = len };
send_and_wait(disk_endpoint, &req, sizeof req);   /* данные — в общей области */
Второй фрагмент схематичен: конкретные интерфейсы у seL4, QNX и Zircon разные. Существенно в нём одно — раскладка struct disk_request описана явно, и потому её можно версионировать, проверять на входе и сохранить при смене реализации по обе стороны. Микроядро избавляет от проблемы стабильного интерфейса не потому, что дисциплинированнее, а потому, что у его границы формат есть по построению. За это оно, разумеется, платит: у второго фрагмента цена не 24 такта.
Микроядро
Что выносится и что остаётся
Наружу выносятся драйверы, файловые системы и сетевой стек — то есть почти вся операционная система в обычном понимании слова. Внутри остаётся минимум, необходимый, чтобы безопасно раздать оборудование: адресные пространства, потоки, механизм передачи управления и данных между ними, диспетчеризация прерываний. Критерий, по которому проводится граница, Лидтке сформулировал в 1995 году как принцип минимальности: «понятие допускается внутри микроядра, только если его вынос наружу, то есть разрешение конкурирующих реализаций, помешал бы реализовать требуемую функциональность системы». Определяющий признак — функциональность, а не производительность: это прямо оговорено в той же фразе.
MINIX 3 описывает себя ровно этими словами: «крошечное микроядро, работающее в режиме ядра, а вся остальная операционная система — набор изолированных, защищённых процессов в пользовательском режиме». Практическое следствие видно в его сервере перезапуска (reincarnation server), который следит за драйверами и поднимает упавший заново. Судьба проекта при этом поучительна вдвойне: как система общего назначения он остановился — на официальной странице загрузки стабильным релизом до сих пор значится 3.3.0, — а как встроенное ядро разошёлся тиражом, которого не достигал никто: модифицированный MINIX работает внутри управляющего движка процессоров Intel, о чём его автор узнал, по собственному рассказу, уже после того, как чип разошёлся «почти по всем современным настольным и портативным компьютерам». QNX формулирует то же самое как свойство продукта: «каждый процесс — даже драйвер устройства — работает в своём виртуальном адресном пространстве», «сбойный драйвер вряд ли уронит ОС» и «обычно можно остановить и перезапустить драйвер, не перезагружая систему».
Это и есть главный практический выигрыш, ради которого модель выбирают в проде: отказ компонента перестаёт быть отказом системы. Счёт в промышленных внедрениях подтверждает, что выигрыш реален: по пресс-релизу самой компании от 16 декабря 2025 со ссылкой на Counterpoint Research, QNX работает более чем в 275 миллионах автомобилей. Семейство L4 накопило не меньше: в вводном документе seL4 Foundation перечислены OKL4 на «миллиардах» модемных чипов Qualcomm и ядро L4-embedded в защищённом анклаве устройств iOS.
Существующую систему при этом не переписывают целиком, и способ, которым её переводят, стоит знать: в том же документе он описан как последовательный кибер-ретрофит. Сначала весь имеющийся стек целиком запускают в виртуальной машине поверх микроядра — выигрыша в безопасности это не даёт вовсе, зато даёт точку отсчёта. Потом из него по одному вынимают компоненты: в работе по программе DARPA HACMS с автономным вертолётом Boeing ULB сначала отделили камеру во вторую виртуальную машину, затем вытащили из машины сетевой стек, затем остальные критические модули. Итог, ради которого всё делалось: приглашённые DARPA специалисты по проникновению по-прежнему взламывали Linux внутри виртуальной машины, но выйти за её пределы и добраться до остальной системы уже не могли.
Чем за это платят на самом деле
Цену принято искать в тактах на IPC. Искать её надо в другом месте, и честнее всего об этом говорит сам лагерь микроядер. Документ seL4 Foundation признаёт: микроядро «не содержит ни одной из обычных служб ОС», эти компоненты «должны откуда-то взяться» — их портируют из FreeBSD или Linux либо пишут с нуля, «и в любом случае это значительная работа», — а API seL4 «очень низкоуровневый», настолько, что авторы предлагают думать о нём как об «ассемблере операционных систем».
Вторая часть цены — архитектурная, и её видно на любом сервисе, через который идёт поток данных. Лучшее измерение здесь — работа про FUSE (USENIX FAST '17), где ту же файловую систему сравнивали с ext4 на 45 нагрузках: деградация «может быть совершенно незаметной или достигать −83 % даже в оптимизированном варианте, а относительная загрузка процессора вырастает на 31 %». Разброс не случайный, и разбор по нагрузкам объясняет, где именно теряется. Все записи и почти все последовательные чтения укладываются в пять процентов — там граница пересекается редко, а данных за раз передаётся много. Хуже всего метаданные и мелкие случайные чтения, но по-разному, и разница практическая. Худшая нагрузка всего набора — создание файлов: −83 % и в базовой конфигурации, и в оптимизированной; из сорока пяти нагрузок только две, обе про создание файлов, остаются в худшем классе даже при лучшей из двух конфигураций. Мелкие случайные чтения проваливаются до тех же −83 % только в базовой: там каждое пользовательское чтение превращается в отдельный поход к демону и тридцать один поток из тридцати двух ждёт, пока однопоточный демон обслужит один запрос, — а оптимизации поднимают этот случай до −28 %. Тактов на операцию при этом становится больше в 1,2–10 раз.
Отсюда правило, которое стоит унести целиком: в микроядерной системе цена определяется не стоимостью одного перехода, а тем, сколько раз поток данных пересекает границы и умеет ли архитектура эти пересечения группировать. Именно поэтому современные микроядерные фреймворки разводят управление и данные: в Microkit сервер вызывают защищённым вызовом процедуры ppcall(), а асинхронное notify() не передаёт ничего, кроме факта события, — данные лежат в разделяемой области памяти, отображённой обеим сторонам. Это тот же вывод, к которому пришёл монолит с кольцами подачи и завершения (статья 7): число пересечений границы — параметр интерфейса, а не деталь реализации.
История про «микроядра медленные»
Что именно измерили в 1993 году
Первоисточник — работа Лидтке «Improving IPC by Kernel Design» (SOSP '93). Обстановка эксперимента названа точно: безымянный ПК с Intel 486-DX50 на 50 МГц, 256 КиБ внешнего кэша, 16 МиБ памяти. Два потока в разных адресных пространствах играли в пинг-понг сообщениями, десять тысяч раз; среднее время получено делением общего времени на двадцать тысяч. То есть знаменитые 5,2 микросекунды — это одностороннее межадресное сообщение, а не полный оборот. Полный оборот в той же работе назван отдельно, в сводной таблице Null-RPC: L3 на 486-50 — 10 микросекунд, Mach на том же 486-50 — 230.
Рамку вокруг верных чисел проверять здесь обязательно. Чаще всего цитируют «5 микросекунд против 115»; второе число получается из первого по названному в аннотации коэффициенту 22 и относится к тому же одностороннему измерению — то есть пара верна, но это не времена полного оборота, и подставлять их в рассуждение про стоимость запроса к серверу нельзя. В той же таблице есть третья строка, которую цитируют редко: QNX на 486-33 показал 76 микросекунд Null-RPC против 346 у Mach на том же процессоре. То есть ещё до L3 существовало микроядро, обгонявшее Mach в четыре с половиной раза, — довод, что дело не в идее, был на столе с самого начала.
Есть и четвёртое число, объясняющее половину разрыва: на том же 486 Лидтке измерил вызов mach_thread_self в 18 микросекунд при том, что голый переход «пользователь → ядро → пользователь» стоил 2. Ядро тратило на вход и выход из себя девять голых переходов.
Что показала вторая работа и чего из неё не следовало
Параллельно, на той же конференции, Чен и Бершад опубликовали измерение памяти: они сравнивали Ultrix (монолит) и Mach 3.0 с UNIX-сервером CMU на тринадцати нагрузках и получили, что микроядерная система «исполняет заметно больше системных инструкций при той же работе», а средняя инструкция обходится дороже по числу тактов простоя памяти на инструкцию (MCPI). Вывод их работы аккуратен: «у микроядерной системы на базе Mach локальность системного кода хуже, чем у Ultrix».
Именно эта пара работ и стала фольклором «микроядра медленные». Лидтке в 1995 году перечитал те же измерения и показал, что из них следует другое. Эмуляционная библиотека Mach давала не больше трёх процентов накладных расходов, UNIX-сервер тратил инструкций не больше соответствующих процедур Ultrix — «остаётся сам Mach», и потому «деградация системы памяти вызвана исключительно высоким потреблением кэша микроядром. Или, другими словами: радикальное уменьшение рабочего множества кэша микроядра решит проблему».
Ключевое различие — между свойством идеи и свойством реализации. Микроядро первого поколения проектировалось переносимым, со слоем абстракции над оборудованием; Лидтке в той же работе объявляет это ошибкой и выносит в аннотацию: микроядра «принципиально непереносимы, хотя и улучшают переносимость системы в целом». Микроядро — это и есть машинно-зависимый слой, и писать его надо заново под каждую архитектуру, а не абстрагировать.
Аргумент с другой стороны, в те же годы
Полезно посмотреть, как спор выглядел со стороны монолита, потому что там позиция была изложена столь же ясно и опиралась на такие же измерения. Белая книга Microsoft, объяснявшая перенос диспетчера окон и GDI из пользовательского процесса CSRSS в привилегированную часть NT 4.0, формулирует тезис без обиняков: «ни одна коммерческая операционная система не построена на чистом микроядре. Причина проста: чистая микроядерная конструкция коммерчески непрактична, потому что слишком дорога вычислительно, то есть слишком медленна». Там же довод об отказоустойчивости, который стоит услышать целиком: если файловая система в пользовательском режиме время от времени падает, то «какая практическая разница между операционной системой, которая иногда падает, и такой, которая продолжает работать, но теряет доступ ко всему постоянному хранилищу?»
И там же — числа, ради которых цитата приведена. Переход клиент-сервер в NT 3.51 оценён порядком величины — 60–70 микросекунд на Pentium 100 против 4–5 на переход в режим ядра. Именно оценён: ни методики, ни условий документ не приводит, и это тоже часть сюжета — архитектурное решение обосновывали числами, которые нечем перепроверить. То есть компания брала собственный механизм на машине заведомо более быстрой, чем 486-50, получала в шесть-семь раз худший результат, чем L3 показывал на полном обороте Null-RPC, и делала вывод про модель. На что опиралась общая оценка, видно в сноске того же документа: коммерческие реализации Mach «исполняют в режиме ядра по крайней мере весь код файловых систем, сети и управления памятью». Довод о непрактичности микроядер строился на микроядре первого поколения — том самом, чью стоимость Лидтке годом раньше объяснил рабочим множеством кэша.
Сравнивать эти числа лоб в лоб нельзя: у Microsoft это переход между парой связанных потоков через Fast LPC, названный без методики, у Лидтке — пинг-понг между адресными пространствами с описанным стендом и способом счёта, и контролируемым экспериментом такое сопоставление не является. Но именно эта разница — десятки микросекунд у одних против единиц у других на одну и ту же по смыслу операцию — и была предметом спора. Разрешил его не спор.
Контролируемый эксперимент 1997 года
Спор закрыла работа «The Performance of µ-Kernel-Based Systems» (SOSP '97), и закрыла правильным способом: одну и ту же операционную систему — Linux 2.0 — измерили в трёх видах на одной машине (Pentium 133 МГц, 256 КиБ кэша второго уровня, 64 МиБ памяти). Native Linux, L4Linux (ядро Linux как единственный сервер поверх L4 второго поколения) и MkLinux (то же поверх микроядра из семейства Mach) в двух конфигурациях: сервер в пользовательском режиме и сервер, вкомпонованный в само микроядро.
Самый короткий системный вызов, getpid: 1,68 мкс у native Linux, 3,95 у L4Linux, 15,41 у MkLinux с сервером внутри ядра и 110,60 у MkLinux с сервером в пользовательском режиме. Макроизмерение по коммерческому пакету AIM VII: 130 заданий в минуту у native Linux, 123 (95 %) у L4Linux, 95 (73 %) у вкомпонованного MkLinux, 81 (62 %) у пользовательского. В среднем по всем нагрузкам L4Linux отставал на 8,3 %, MkLinux — на 29 % и 49 % соответственно. Вывод авторов: «плата за использование микроядра может быть удержана где-то между 5 % и 10 % для приложений».
Но по-настоящему важна в этой работе другая строка. Вкомпоновывание сервера в ядро (co-location) — то самое лекарство, которым лечили Mach, — дало 29 % вместо 49 %, тогда как простая смена микроядра при сервере, оставшемся в пользовательском режиме, дала 8,3 %. Авторы формулируют это прямо: «быстрый IPC и эффективные абстракции отображения оказываются действеннее таких приёмов, как co-location». Иначе говоря, стоимость сидела не в пересечении границы, а в ядре, которое эту границу обслуживало. Убрать границу помогало вдвое хуже, чем починить ядро.
Где спор находится сегодня
Свежие измерения ту же картину подтверждают, но добавляют деталь, которой в девяностых не было. Независимое сравнение трёх микроядер — работа про SkyBridge (EuroSys '19), на которую seL4 Foundation и ссылается как на Mi et al., — меряло оборот пустого IPC на Intel Core i7-6700K: 986 тактов у быстрого пути seL4, 2717 у Fiasco.OC, 8157 у Zircon; между процессорными ядрами, где быстрый путь вырождается и добавляется межпроцессорное прерывание, — 6764, 8440 и 20099. То есть Fiasco.OC вдвое с лишним медленнее seL4, а Zircon — в восемь с лишним раз. Там же разложен пол, ниже которого IPC через ядро не опускается: SYSCALL 82 такта, два SWAPGS по 26, SYSRET 75, смена адресного пространства 186 тактов с PCID — и сверх этого 98 тактов собственной логики быстрого пути seL4, итого 493 такта на одну доставку сообщения при выключенных контрмерах Meltdown и вдвое больше на оборот; с контрмерами смен адресного пространства становится две. Абсолютные значения между работами расходятся сильнее, чем хотелось бы, и расходятся по железу: на Xeon Gold 6138 в работе про UnderBridge тот же оборот у seL4 — 1450 тактов, а seL4 Foundation в споре с измерением CertiKOS называет около 720, не указывая платформы.
Деталь же в том, куда пошли исследователи дальше. Если стоимость упёрлась в аппаратный предел смены привилегий и адресного пространства, следующий шаг — не пересекать эту границу вовсе. Та же работа это и делает: SkyBridge переносит переключение на инструкцию vmfunc со сменой таблиц второй ступени и сбивает оборот с 986 до 396 тактов на том же процессоре. UnderBridge, следующая работа той же лаборатории, переносит его на ключи защиты памяти, и оборот между серверами падает до 109 тактов. Механизм ключей разобран в первой статье как программная изоляция внутри одного адресного пространства; здесь он всплывает с другой стороны — как способ построить микроядро, у которого серверы больше не платят за смену карты. Цена названа авторами прямо и она поучительна: серверы у них исполняются в нулевом кольце, поэтому скомпрометированный сервер «теоретически может исполнить любую привилегированную инструкцию» — например, установить свою таблицу страниц. Чтобы не раздувать доверенную базу, приходится строить ещё один этаж: систему запускают в неroot-режиме виртуализации, а крошечный монитор в root-режиме перехватывает привилегированные инструкции, плюс переписывание бинарника там, где перехват слишком дорог. То есть изоляция никуда не делась — она переехала с таблиц страниц на другой механизм, и доказывать её достаточность приходится заново.
Верификация: размер как возможность
Именно здесь маленькая доверенная база перестаёт быть метрикой и становится качественно другим свойством.
Числа из работы 2009 года, где seL4 был впервые верифицирован: ядро — 8700 строк на C и 600 на ассемблере; доказательство — 200 000 строк скрипта Isabelle; трудоёмкость доказательства около 20 человеко-лет, из которых 9 ушли на общие инструменты и библиотеки, а собственно на seL4 — 11. Само ядро при этом стоило 2,2 человеко-года против примерно шести, потраченных группой из Карлсруэ на ядро Pistachio. Повторение такой верификации для нового ядра авторы оценивали в 6 человеко-лет доказательства.
Читать эти числа надо не как «дорого» или «дёшево», а как ответ на вопрос, что вообще возможно. Одиннадцать человеко-лет на 8700 строк — это примерно человеко-год на тысячу строк. Для двадцати миллионов строк такой цены не существует ни при каком бюджете, и это не вопрос усердия: доказательство функциональной корректности требует спецификации всего, что ядро делает, а спецификация драйвера видеокарты не короче самого драйвера.
Что именно доказано, стоит смотреть по таблице конфигураций, потому что она меняется. На дату сверки: у AArch32 — функциональная корректность на уровне C вместе с быстрым путём, целостность и доступность, конфиденциальность и, единственная из всех, корректность бинарника; у AArch64 — то же без корректности бинарника; у RISC-V 64 — то же, но без быстрого пути; у x86-64 (платформа PC99) — только функциональная корректность на уровне C и тоже без быстрого пути. Различие про бинарник существеннее, чем кажется: без него в доверенной базе остаётся компилятор, и seL4 закрывает эту дыру отдельной трансляционной валидацией, а не доверием к GCC.
Чего доказательства не покрывают, сказано у авторов честно: они «не охватывают свойств, связанных со временем» — доказательства конфиденциальности исключают скрытые каналы по памяти, но не по времени, — и верификация оборудования вне их области. То есть доказанное ядро не защищает от атаки по таймингам на оборудовании, которое их допускает, и все контрмеры спекулятивным атакам из статьи 7 остаются в силе.
Практический вывод для того, кто выбирает: верификация — единственный довод в пользу микроядра, который не имеет замены. Отказоустойчивость драйверов монолит умеет отвоевать по кускам, поверхность атаки — сузить конфигурацией, а вот доказать что-либо про двадцать миллионов строк нельзя, и никакая инженерная дисциплина этого не заменит.
Как монолиты отвоёвывают свойства микроядра
Самое интересное в сегодняшнем раскладе — не спор двух лагерей, а то, что монолиты последние двадцать лет по одному отбирают у микроядер их свойства, не меняя модели.
Драйверы в пользовательском пространстве. Документация UIO в ядре Linux перечисляет мотивы почти теми же словами, что и микроядерная литература: «только один маленький модуль ядра, который надо писать и сопровождать», разработка основной части драйвера в пользовательском пространстве «со всеми инструментами и библиотеками, к которым вы привыкли», и главное — «ошибки в вашем драйвере не уронят ядро». Ограничения названы там же и они существенны: прерывание всё равно приходит в ядро, и «если вашему оборудованию нужно совершить какое-то действие после каждого прерывания, вы обязаны сделать это в модуле ядра», а сам UIO «не является универсальным интерфейсом драйверов». VFIO снимает главное оставшееся ограничение — небезопасность DMA из пользовательского процесса: это «независимый от IOMMU и устройства фреймворк для предоставления прямого доступа к устройству в пользовательское пространство, в безопасном, защищённом IOMMU окружении». DPDK и SPDK доводят приём до логического конца ради производительности, а не изоляции: SPDK описывает свой метод как «перенос всех необходимых драйверов в пользовательское пространство, что избавляет от системных вызовов и позволяет обращаться к данным без копирования», плюс опрос вместо прерываний и отказ от блокировок в пользу передачи сообщений.
Чужой код в ядре под проверкой. eBPF решает другую половину задачи: не вынести код наружу, а впустить внутрь, доказав его безопасность до исполнения. Верификатор работает в два шага — сначала проверка графа управления, «чтобы запретить циклы и прочие нарушения структуры», затем прогон всех возможных путей с отслеживанием типа и границ каждого регистра; «если в регистр никогда не писали, читать его нельзя», а загрузка и сохранение разрешены только через указатели известных типов. Свойство, которое это даёт, ровно то, чего не даёт C: программа не прочитает неинициализированный регистр, не выйдет за границы буфера и не зациклится навсегда. Цена — писать можно только то, что верификатор способен доказать: программа, корректная по существу, но слишком сложная для анализа, будет отвергнута, и это ограничение языка, а не ошибка.
Изоляция имён, а не привилегий. Namespaces в Linux и jails во FreeBSD часто попадают в этот же список, и попадать не должны. Они изолируют то, что процессы видят, оставаясь одним ядром на всех: доверенная база от этого не уменьшается ни на строку, и уязвимость в ядре компрометирует хост целиком — об этом прямо сказано в статье про контейнеризацию, а со стороны FreeBSD — в статье про jail.
Движение снаружи, из индустрии. Apple объявила расширения ядра устаревшими: «начиная с macOS Big Sur, релизы macOS по умолчанию больше не загружают расширения ядра, использующие устаревшие KPI», а на замену пришли системные расширения и DriverKit, работающие в пользовательском пространстве. Microsoft начала с графики — в WDDM «драйвер с компонентами в пользовательском и в ядерном режиме» прямо назван средством, которое «снижает вероятность отказа системы из-за сбоя драйвера», — а после инцидента 2024 года взялась за средства безопасности: платформа Windows endpoint security «переносит применение антивирусных политик из ядра в пользовательский режим», так что ошибка антивируса роняет антивирус, а не Windows. Это по-прежнему приватное превью: признаков общедоступности на дату сверки нет, и это первое, что устареет в этой статье.
Общий итог этого раздела важнее любого отдельного примера. Монолит способен купить отказоустойчивость по одной подсистеме за раз, платя только там, где сам решил заплатить, — и это гибче, чем звучит. Чего он купить не может, так это маленькой доверенной базы: остальные двадцать миллионов строк никуда не делись, и вынос драйвера принтера наружу не делает ядро проверяемым.
Гибриды и остальное пространство
NT и XNU: что в них от микроядра
Слово «гибридное ядро» описывает происхождение, а не структуру. Apple в README своего репозитория так и пишет: «XNU — гибридное ядро, объединяющее ядро Mach, разработанное в Университете Карнеги — Меллона, с компонентами FreeBSD и написанным на C++ API для драйверов под названием IOKit». Mach внутри действительно есть, но BSD-часть и драйверы исполняются в том же адресном пространстве, а не поверх IPC, и с точки зрения вопроса «что случится при ошибке в драйвере» XNU — первая колонка схемы, а не вторая.
История NT ещё выразительнее, потому что там движение шло в обратную сторону, и обе его точки задокументированы самой компанией. В NT 4.0 диспетчер окон и GDI переехали из пользовательского процесса в привилегированную часть системы ради производительности и экономии памяти, и белая книга того переезда прямо относит NT к «модифицированным микроядрам, или макроядрам». Спустя почти тридцать лет та же компания строит платформу, чтобы вынести из ядра средства безопасности, а графический драйвер у неё уже давно разделён на пользовательскую и ядерную части. Вывод из этой пары не в том, что кто-то ошибся, а в том, что граница внутри модели двигается в обе стороны и двигается по конкретным подсистемам — а сама модель у NT за это время не менялась ни разу.
Zircon: современное микроядро, не претендующее на минимальность
Zircon интересен тем, что его авторы отказались от главного принципа Лидтке явно. Документация Fuchsia формулирует: «хотя Zircon применяет многие понятия, популяризованные микроядрами, он не стремится быть минимальным», а смысл конструкции — «сократить объём доверенного кода в системе до нескольких основных функций». Файловые системы и драйверы вынесены наружу; драйверы — динамически загружаемые библиотеки в пользовательских процессах-хостах, а системных вызовов меньше, чем в POSIX-системах, «потому что службы вроде файловых систем и драйверов размещены вне ядра».
Проект живой: релиз F31 датирован 22 июля 2026 года, и в его заметках — замена унаследованных блочных драйверов новой архитектурой хранения, то есть изменения, которых не бывает у замороженного кода. Оценки будущего Fuchsia в прессе противоречивы, и подтвердить их первоисточником я не смог; поэтому здесь только проверяемое — темп релизов и содержание документации. Отдельного упоминания заслуживает Starnix — «раннер, позволяющий немодифицированным программам Linux работать в системе Fuchsia», транслирующий системные вызовы Linux в подсистемы Fuchsia и работающий сам пользовательской программой. Это ровно конструкция L4Linux 1997 года, только вместо порта самого ядра Linux здесь трансляция его ABI.
Мультиядро: машина как сеть
Barrelfish (SOSP '09) довёл идею до предела: раз в многоядерной машине связь между ядрами всё равно устроена как передача сообщений, пусть ОС так её и трактует — никакой разделяемой памяти в самой ОС, явные сообщения, реплицированное состояние вместо общего. Через двенадцать лет авторы написали честную ретроспективу: гетерогенность и разнообразие оборудования оказались «вполне реальными проблемами» и модель для них по-прежнему подходит лучше всего, а вот главный прогноз не сбылся — «наши предсказания про будущее с сотнями ядер оказались несколько мимо», и старые архитектуры ОС продолжили масштабироваться постепенно. Сам проект после этого сузился до преподавания и отдельных систем вроде Enzian; систему общего назначения из него не вышло.
Для автора своей ОС здесь полезен не результат, а метод: реплицированное состояние вместо общего — это то, к чему приходят и монолиты, когда данные на процессор перестают помещаться под один замок.
Экзоядро и то, что растёт из него
Экзоядро отвечает на вопрос не «где исполнять», а «кто принимает решения». Формулировка авторов (SOSP '95): экзоядро «отделяет защиту от управления через низкоуровневый интерфейс», отслеживает владение ресурсами и обеспечивает защиту через безопасные привязки, а все абстракции — виртуальную память, IPC, файловые системы — реализует библиотечная ОС в самом приложении. Измерения обещали многое: «большинство примитивных операций ядра в десять-сто раз быстрее, чем в Ultrix». Оговорка авторов там же и она решающая: Aegis и ExOS «не предоставляют того же уровня функциональности, что Ultrix», — то есть сравнение примитивов, а не систем.
Прямые потомки этой линии — библиотечные ОС и уникернелы, где приложение и ядро компонуются в один образ и живут в одном адресном пространстве без смены привилегий, а изоляция вынесена в гипервизор; ошибка в драйвере роняет здесь не процесс и не ядро, а виртуальную машину целиком. Они разобраны в первой статье цикла вместе с ретроспективой авторов MirageOS, и повторять здесь нечего; для этой статьи важно одно: уникернел — не третья модель ядра, а решение вынести границу наружу, за пределы образа. Поэтому на схеме он стоит третьей колонкой, а не разновидностью первых двух.
Языковая безопасность как вторая ось
Последняя развилка ортогональна первой, и путать их не стоит. Изоляция может держаться на железе (таблицы страниц), а может — на компиляторе. Singularity показала, что второе дешевле: аппаратная изоляция стоила там 25–33 %, программная — менее 5 %, но в доверенную базу переехал оптимизирующий компилятор; числа и вывод авторов про эшелонированную защиту — в первой статье.
Сегодняшний живой пример совмещения обеих осей — Redox: «полноценная Unix-подобная микроядерная операционная система, написанная на Rust», где, по описанию проекта, драйверы работают в пользовательском пространстве, а ядро и драйверы написаны на Rust. Статус стоит назвать точно, потому что он часто преувеличивается: последний релиз — 0.9.0 от 9 сентября 2024 года, при этом ежемесячные отчёты о разработке выходят по сей день (последний на дату сверки — за июль 2026). Противоположный выбор — Linux, где модель ядра не меняется, а язык внедряется внутрь неё; что это даёт и чего стоит, разобрано в статье 8.
Вердикт по этой оси: языковая безопасность не заменяет структурную и не отменяет её. Она убирает целый класс ошибок внутри компонента, но ничего не говорит о том, что случится, если компонент всё-таки ошибётся, — а структурная изоляция отвечает именно на этот вопрос и не зависит от корректности компилятора.
Как модель определяет всё остальное
Это раздел, ради которого статья стоит последней. Ниже — не сводка предыдущих восьми, а точки, в которых выбор модели меняет ответ, уже разобранный там.
Стеки и то, где можно заблокироваться (статья 4). Развилка «свой стек ядра у каждого потока или один на процессор» разбиралась там как самостоятельное решение. На самом деле она следует из структуры. Модель прерывания практична для микроядра ровно потому, что код, которому хочется поспать посреди операции, в ядре не живёт: файловая система и драйвер — обычные пользовательские потоки со своими стеками, а ядру остаются короткие операции, которые можно исполнять с запрещёнными прерываниями и при необходимости перезапускать с точки вытеснения. У монолита та же модель означает, что каждая блокирующая операция в цепочке «файловая система → блочный слой → драйвер» превращается в явный конечный автомат, — а во что обходится переделать под это чужой код, статья 4 считает отдельно, по эксперименту Fluke. Прямое следствие для бюджета: у монолита стек ядра — постоянная плата за существование каждого потока (16 КиБ у Linux и FreeBSD), у seL4 стека ядра на поток нет вовсе.
Вход в ядро (статья 7). В монолите обращение к драйверу — вызов функции внутри уже пересечённой границы; всё, что перечислено в статье 7 как налог на переход (кадр входа, обнуление регистров, контрмеры спекулятивным атакам, переключение корня трансляции при изоляции таблиц), платится один раз на системный вызов. В микроядре тот же запрос пересекает границу дважды на каждом шаге конвейера — из процесса в ядро и из ядра в сервер, — а с ответом выходит четыре пересечения на один вызов, и каждое несёт полный налог. Это меняет вес решений из статьи 7 радикально: там пакетирование интерфейса было полезной оптимизацией, здесь оно становится условием жизнеспособности. И это же объясняет, почему после Meltdown и Spectre микроядрам стало объективно тяжелее: контрмеры удорожают ровно ту операцию, которую они выполняют чаще, — на том же Xeon Gold 6138 изоляция таблиц страниц поднимает оборот между серверами в seL4 с 1450 тактов до 2035, а в Fiasco.OC с 3057 до 4145.
Смена адресного пространства (статьи 1 и 2). Теги адресных пространств для монолита — оптимизация переключения контекста; для микроядра — несущая конструкция, потому что каждый вызов сервера меняет карту. Лидтке в девяностых обходил эту цену трюком с малыми адресными пространствами на сегментах Pentium; сегодня ту же задачу решают ключи защиты памяти и вторая ступень трансляции. Вопрос «дорого ли менять адресное пространство» в монолите задаётся про планировщик, а в микроядре — про каждый вызов файловой системы.
Карта памяти ядра (статья 3). Окно прямого отображения существует потому, что ядру нужен доступ к произвольному физическому кадру. Смена модели его не отменяет: seL4 окно держит, и статья 3 это отдельно оговаривает. Меняется другое — кто по эту сторону окна живёт. Драйверу-серверу прямое отображение не нужно и не выдаётся: он получает отображёнными ровно те кадры, которые ему передали, и его испорченный указатель не дотягивается до всей памяти машины. То есть модель не убирает опасный механизм из ядра, а выселяет из-под него основную массу кода, который этим механизмом пользовался.
Физическая память (статья 5). Самый резкий пример. В seL4 аллокатора в ядре нет вовсе; как устроена раздача памяти мандатами на нетипизированные области и почему двойственный аллокатор с зонами и политикой NUMA оказывается следствием решения держать распределение внутри ядра, разобрано в статье 5. Здесь важно другое: выбрав микроядро, вы удаляете из ядра целую подсистему — и обязаны написать её в пользовательском пространстве, потому что политика распределения памяти нужна системе в любом случае.
Загрузка (статья 6). Монолит склонен втягивать раннюю работу внутрь себя, микроядро — выносить её в отдельную программу; где именно проходит эта граница у seL4 и почему она разная на ARM и на x86, разобрано в статье 6. Существеннее здесь то, чем загрузка заканчивается: монолит монтирует корень и запускает первый процесс, микроядро передаёт начальной задаче мандаты на всё оставшееся оборудование и память. Это разные контракты, и написаны они в разных местах.
Язык (статья 8). Чем меньше кода исполняется с правами ядра, тем меньше выигрыш от безопасного языка внутри этого кода — и тем больше от него выигрывают серверы, которых теперь много и которые пишутся годами. Redox выбирает обе оси сразу, Linux — только языковую, seL4 — только структурную, полагаясь на доказательство вместо системы типов. Ни один из трёх выборов не следует из другого.
Из перечисленного и вытекает единственный общий вывод: модель выбирается до всего остального. Не потому, что она важнее, а потому, что все остальные решения принимают её как данность. Ответ на вопрос «нужен ли стек ядра каждому потоку» зависит от того, что в вашем ядре вообще живёт; ответ на вопрос «какой нужен аллокатор» — от того, кто распределяет память. Приняв эти решения раньше решения о структуре, вы просто примете их за монолит, не заметив, что выбирали.
Вердикт для своей ОС
Для учебного ядра начинайте с монолита, и довод здесь не про производительность.
Довод первый — порядок работ. В монолите первое устройство начинает отвечать, когда написан драйвер; в микроядре — когда написаны драйвер, механизм IPC, способ отдать серверу отображение регистров устройства, способ доставить ему прерывание и хоть какой-то способ найти сервер по имени. Оценка стоимости здесь не моя: документ seL4 Foundation сам называет своё API «ассемблером операционных систем» и признаёт, что нужные компоненты «должны откуда-то взяться» и это «значительная работа».
Довод второй — корпус, по которому вы будете сверяться. Механизмы, разобранные в этом цикле, проверяются чтением Linux, FreeBSD и xv6 — трёх монолитов; seL4 даёт по каждому вопросу второй ответ, но не первый.
Довод третий — обратимость. Монолит умеет отдавать свойства микроядра по частям, и раздел выше это показал: драйвер выносится наружу через UIO и VFIO, чужой код впускается внутрь под верификатором, целые классы драйверов уезжают в пользовательский режим у Apple и Microsoft. Обратное движение — из микроядра в монолит — не бывает частичным.
Микроядро выбирают, когда есть одна из двух причин, и обе конкретны. Верификация: если требуется доказательство, а не тестирование, размер ядра из метрики превращается в условие возможности, и никакая дисциплина этого не заменяет. Отказоустойчивость как требование, а не пожелание: если перезапуск драйвера без перезагрузки системы записан в требованиях — как в автомобильных и медицинских системах, — модель выбрана за вас.
| Решение | Рекомендация | Почему и что будет, если передумать |
|---|---|---|
| Модель ядра | монолит | Первое устройство отвечает раньше, корпус для сверки больше, свойства второй модели добираются по частям. Смена модели — переписывание способа, которым подсистемы общаются |
| Граница драйвера | явный интерфейс с самого начала: запрос как объект, никакого доступа к чужим структурам напрямую | Это единственная часть решения, которую дёшево принять авансом: драйвер, не лазающий в чужие поля, потом выносится наружу; драйвер, лазающий, — нет |
| Загружаемые модули | не сразу | Модуль не даёт изоляции и не меняет модель, а стоит механизма разрешения символов и релокаций во время работы. Добавляется в любой момент |
| Первый вынос наружу | файловая система или драйвер без жёсткого времени отклика | Там граница пересекается редко и порциями; измерения FUSE показывают, что запись и последовательное чтение почти не теряют, случайное чтение после оптимизаций восстанавливается до −28 %, а метаданные остаются на −83 % и в оптимизированном варианте |
| Безопасный язык | ортогонально модели, решается отдельно | Убирает класс ошибок внутри компонента, но не отвечает, что будет при ошибке компонента; см. статью 8 |
| Верификация | только если это требование заказчика | Порядок величины — человеко-год доказательства на тысячу строк ядра; задним числом к выросшему ядру не приделывается |
И одна вещь, которую полезно решить рано, независимо от модели: ведите список того, что исполняется с правами ядра. Не строк в дереве, а подсистем в вашей конфигурации. Это и есть TCB, а список, который никто не ведёт, растёт молча.
Как это сделано в пяти системах
| Linux | XNU | Zircon | seL4 | QNX | |
|---|---|---|---|---|---|
| Самоопределение | монолит с модулями | гибрид (по README проекта) | «не стремится быть минимальным» | микроядро с доказательством | микроядро |
| Драйверы | в ядре; часть классов выносима наружу | в ядре (IOKit), новые — в пользовательском режиме через DriverKit | в пользовательских процессах | в пользовательских процессах | в пользовательских процессах |
| Вызов драйвера | вызов функции | вызов функции | сообщение через объект ядра | сообщение через мандат | сообщение |
| Отказ драйвера | отказ системы; у вынесенного наружу — отказ процесса | отказ системы; у DriverKit — отказ процесса | отказ процесса | отказ процесса | отказ процесса, перезапуск без перезагрузки |
| Чем подтверждена корректность | тестирование и эксплуатация | тестирование и эксплуатация | тестирование и эксплуатация | доказательство, по конфигурациям | тестирование и эксплуатация |
FreeBSD отдельной колонки не имеет намеренно: по всем этим строкам она совпадает с Linux, и различия между ними, разобранные в предыдущих статьях цикла, лежат внутри одной модели, а не между моделями. Именно это и есть главное наблюдение таблицы: расхождения между двумя монолитами — про реализацию, расхождение между колонками — про то, чем является вызов драйвера.
Источники
- Improving IPC by Kernel Design (Liedtke, SOSP '93) — обстановка измерения (486-DX50 50 МГц, 256 КиБ внешнего кэша, 16 МиБ памяти), методика пинг-понга между адресными пространствами и деление на 20 000, одностороннее время 5,2 мкс, таблица Null-RPC (L3 10 мкс и Mach 230 мкс на 486-50, QNX 76 мкс и Mach 346 мкс на 486-33),
mach_thread_selfза 18 мкс против 2 мкс голого перехода - On µ-Kernel Construction (Liedtke, SOSP '95) — принцип минимальности и оговорка «критерий — функциональность, а не производительность»; разбор измерений Чена и Бершада с выводом, что деградация вызвана потреблением кэша микроядром; мультиплексирование нескольких пользовательских адресных пространств в одном линейном через сегменты Pentium — 15 тактов на переключение вместо перезагрузки таблицы страниц; тезис о принципиальной непереносимости микроядер
- The Impact of Operating System Structure on Memory System Performance (Chen, Bershad, SOSP '93) — сравнение Ultrix и Mach 3.0 с UNIX-сервером CMU, MCPI как метрика, вывод о худшей локальности системного кода у микроядерной системы
- The Performance of µ-Kernel-Based Systems (Härtig, Hohmuth, Liedtke, Schönberg, Wolter, SOSP '97) — Pentium 133 МГц как единый стенд,
getpidв четырёх системах, AIM VII (130/123/95/81 задания в минуту), средние 8,3 %, 29 % и 49 %, вывод про 5–10 % и про то, что быстрый IPC действеннее co-location - seL4: Formal Verification of an OS Kernel (Klein et al., SOSP '09) — 8700 строк C и 600 строк ассемблера, 200 000 строк скрипта Isabelle, 20 человеко-лет доказательства (9 на инструменты, 11 на seL4), 2,2 человеко-года на само ядро против 6 у Pistachio, оценка повторения в 6 человеко-лет
- The seL4 Microkernel — An Introduction (Heiser, seL4 Foundation) — определение TCB, оценка Linux в 20 миллионов строк против порядка 10 тысяч у микроядра, отсутствие служб ОС в ядре и признание, что компоненты «должны откуда-то взяться», «ассемблер операционных систем», Microkit с
ppcall()иnotify(), около 720 тактов на оборот IPC в возражении на измерение CertiKOS (Gu et al. 2016), без указания платформы, оговорка про скрытые каналы по времени, деплойменты OKL4 и L4-embedded, история кибер-ретрофита вертолёта в программе DARPA HACMS - seL4 verified configurations — что именно доказано на AArch32, AArch64, RISC-V 64 и x86-64, включая корректность бинарника только у AArch32
- SkyBridge: Fast and Secure Inter-Process Communication for Microkernels (Mi, Li, Yang, Wang, Chen, EuroSys '19) — та самая работа, на которую seL4 Foundation ссылается как на Mi et al.: Intel Core i7-6700K как стенд, оборот пустого IPC в пределах одного процессорного ядра (seL4 986 тактов, Fiasco.OC 2717, Zircon 8157) и между ядрами (6764, 8440, 20099), разложение неустранимой части (SYSCALL 82, SWAPGS 26, SYSRET 75, смена адресного пространства 186 тактов с PCID, 98 тактов логики быстрого пути seL4, итого 493 такта на доставку сообщения при выключенных контрмерах Meltdown и две смены адресного пространства с ними), 396 тактов у самого SkyBridge на
vmfunc, no-op системный вызов в 181 такт без KPTI и 431 с ним - Harmonizing Performance and Isolation in Microkernels with Efficient Intra-kernel Isolation and Communication (Gu et al., USENIX ATC '20) — Xeon Gold 6138 как стенд, 24 такта на косвенный
call/retв монолите, 1450 тактов на оборот вызова между двумя серверами в seL4 (2035 с изоляцией таблиц страниц; у Fiasco.OC 3057 и 4145), порядок seL4 → Fiasco.OC → Zircon и объяснение отставания Zircon отсутствием прямого переключения на вызываемого, 437 тактов у SkyBridge при перемере на этом же стенде и 109 у UnderBridge на ключах защиты памяти, а также разбор того, чем оплачен перенос серверов в нулевое кольцо: монитор в root-режиме, перехватывающий привилегированные инструкции, и переписывание бинарника на критических путях - To FUSE or Not to FUSE: Performance of User-Space File Systems (Vangoor, Tarasov, Zadok, USENIX FAST '17) — деградация от незаметной до −83 %, рост загрузки процессора на 31 %, разбор по нагрузкам (записи и последовательные чтения в пределах 5 %; −83,1 % — создание файлов, и только две нагрузки из сорока пяти, обе про создание файлов, остаются в худшем классе при лучшей из двух конфигураций; мелкие случайные чтения — −83 % в базовой конфигурации и −28 % в оптимизированной), рост тактов на операцию в 1,2–10 раз
- Exokernel: An Operating System Architecture for Application-Level Resource Management (Engler, Kaashoek, O'Toole, SOSP '95) — отделение защиты от управления, безопасные привязки, «в десять-сто раз быстрее, чем в Ultrix» и оговорка о неодинаковой функциональности
- Deconstructing Process Isolation (Aiken et al., MSPC '06) — Singularity: 25–33 % у аппаратной изоляции против менее 5 % у программной на одной кодовой базе, состав доверенной базы и вывод авторов про аппаратную изоляцию как эшелонированную защиту
- Fish in a Barrel: an insider's retrospective of the SOSP'09 multikernel paper (SIGOPS, 2021) — три мотива мультиядра, признание авторов о несбывшемся прогнозе про сотни ядер и о том, что гетерогенность осталась актуальной
- Документация ядра Linux:
driver-api/uio-howto— мотивы userspace-драйвера, обязанность модуля обрабатывать прерывание и оговорка «UIO не универсальный интерфейс»;driver-api/vfio— прямой доступ к устройству под защитой IOMMU;bpf/verifier— два шага проверки, запрет циклов, отслеживание типов и границ регистров;process/stable-api-nonsense— почему внутренний интерфейс не фиксируется и почему выход — дерево ядра;admin-guide/module-signing— подпись модулей как способ не пустить чужой код в ядро - User Mode and Kernel Mode — Microsoft Learn — единое адресное пространство режима ядра, отсутствие изоляции между драйверами и падение всей ОС при падении драйвера
- MS Windows NT Kernel-mode User and GDI White Paper (архив Microsoft, NT 4.0) — позиция монолита в том же споре: «ни одна коммерческая операционная система не построена на чистом микроядре», довод про файловую систему, которая не падает, но теряет доступ к хранилищу, перенос диспетчера окон, GDI и графических драйверов из CSRSS в Executive, оценка порядком величины без методики — 60–70 микросекунд на переход клиент-сервер против 4–5 на переход в режим ядра на Pentium 100, экономия буфера в 64 КиБ и от 256 КиБ до 1 МиБ рабочего множества, самоопределение NT как модифицированного микроядра и сноска про то, что коммерческие реализации Mach держат файловые системы, сеть и управление памятью в режиме ядра
- Windows Display Driver Model (WDDM) Overview — Microsoft Learn — разделение драйвера на пользовательскую и ядерную части ради снижения вероятности отказа системы, TDR
- Preparing for what's next: Windows security and resiliency innovations — Windows Experience Blog, 18 ноября 2025 — платформа Windows endpoint security переносит применение антивирусных политик из ядра в пользовательский режим; приватное превью с июня 2025
- Helping our customers through the CrowdStrike outage — Microsoft, 20 июля 2024 — оценка Microsoft: 8,5 миллиона устройств Windows, менее одного процента парка
- Kernel Extensions — Apple Developer — расширения ядра объявлены устаревшими, macOS Big Sur не загружает по умолчанию использующие устаревшие KPI, замена — системные расширения и DriverKit
- apple-oss-distributions/xnu — README — самоопределение XNU как гибридного ядра из Mach, компонентов FreeBSD и IOKit
- How QNX OS is unique — QNX 8.0 User's Guide — микроядро
procntoи процессы, каждый в своём адресном пространстве; сбойный драйвер вряд ли уронит ОС; перезапуск драйвера без перезагрузки - QNX Embedded Technology Now Powering More Than 275 Million Vehicles on the Road — пресс-релиз, 16 декабря 2025 — оценка Counterpoint Research
- Документация Fuchsia: Zircon fundamentals — «не стремится быть минимальным», службы вне ядра, права на дескрипторах; Zircon kernel — что предоставляют системные вызовы; Starnix — раннер для немодифицированных программ Linux; Fuchsia F31 release notes — дата 22 июля 2026 и состав изменений
- MINIX 3 — самоопределение «крошечное микроядро в режиме ядра, остальная ОС — изолированные процессы в пользовательском режиме»; на странице загрузки стабильным релизом значится 3.3.0
- An Open Letter to Intel (Tanenbaum) — модифицированный MINIX внутри ME-11 «почти на всех современных настольных и портативных компьютерах»
- Redox OS — самоопределение микроядерной ОС на Rust, драйверы в пользовательском пространстве; новости проекта — релиз 0.9.0 от 9 сентября 2024 года и ежемесячные отчёты по июль 2026
- SPDK: About — перенос драйверов в пользовательское пространство, опрос вместо прерываний, отказ от блокировок в пользу передачи сообщений
Связанные заметки
- Адресное пространство: зачем трансляция и какие есть альтернативы — первая статья цикла: программная изоляция, ключи защиты памяти и уникернелы — те же границы, проведённые не структурой ядра
- Страничная трансляция: таблицы, TLB, разрядность — вторая статья цикла: теги адресных пространств, вес которых полностью зависит от выбранной здесь модели
- Карта памяти ядра: половины, прямое отображение, KASLR — третья статья цикла: окно прямого отображения, которое микроядро оставляет себе, но не выдаёт серверам
- Стеки: ядра, прерываний, пользовательские — четвёртая статья цикла: модель процесса против модели прерывания — развилка, которая следует из структуры ядра
- Физическая память: от карты firmware до аллокатора — пятая статья цикла: аллокатор, которого в seL4 нет, потому что распределение памяти вынесено наружу
- Загрузка: от питания до первой инструкции ядра — шестая статья цикла: ранняя работа, которую монолит втягивает внутрь, а микроядро выносит в отдельную программу
- Вход в ядро и переключение контекста — седьмая статья цикла: налог на пересечение границы, который микроядро платит на каждый вызов сервера
- Ядро как программа: freestanding, компоновка, ABI, выбор языка — восьмая статья цикла: выбор языка как вторая, независимая ось изоляции
- Устройство ОС — план цикла статей — состав и порядок цикла, который эта статья закрывает
- Linux — ядро: сборка, модули, параметры — загружаемые модули со стороны эксплуатации: что происходит при
modprobeи зачем нужна подпись - Linux — контейнеризация: namespaces, cgroups, Docker, Podman — изоляция имён внутри одного ядра: почему она не уменьшает доверенную базу
- FreeBSD — Jails: контейнеризация по-BSD — тот же приём со стороны FreeBSD: разделение видимости при общем ядре
Из библиотеки института уносят только знания. Читателей здесь не считают: посещение не регистрируется, отметок в издании не остаётся, счётчиков нет ни у одного издания фонда.
Издание пополняется и пересверяется. Текст доступен на условиях CC BY-SA 4.0 — унесённое можно передавать дальше на тех же условиях.