Что здесь на самом деле решается
Ядро — обычная программа в том смысле, что его собирает обычный компилятор обычной командой. Всё остальное в нём необычно: под ним нет ни библиотеки языка, ни кучи, ни динамического загрузчика, который расставил бы всё по местам, ни системы, которая подберёт за ним, когда он упадёт. Список того, чего нет, читается как набор мелких неудобств, и в туториалах его так и подают — «добавьте эти флаги». На самом деле у каждого отсутствия своя причина, причины связаны между собой, и знание причины — единственный способ понять, что произойдёт, когда флаг забудут.
Статья разбирает три вещи. Первая — что означает freestanding-окружение и почему компилятор всё равно продолжает рассчитывать на код, которого у вас нет. Вторая, и главная, — чем компоновка ядра отличается от компоновки программы: скрипт компоновщика как часть исходников, различие адреса загрузки и адреса исполнения, и модели кода, где ограничение на кодирование непосредственных операндов напрямую задаёт, в какой части адресного пространства ядру разрешено жить. Третья — ABI, которых здесь не одно, а по меньшей мере три: соглашение о вызовах внутри ядра, отдельное соглашение системного вызова и отдельный способ не входить в ядро вовсе.
Ближе к концу — вопрос о языке. Он ставится не как «что лучше», а как «что конкретно даёт и чего стоит безопасный язык там, где небезопасные операции неустранимы по существу задачи»: ядро обязано писать в таблицы страниц, отображённые регистры устройств и буферы DMA, и ни одна система типов этого не проверит. Разбирать это до компоновки бессмысленно — половина цены языка состоит именно в том, как он ведёт себя в отсутствие рантайма.
Это восьмая статья цикла про устройство операционных систем; состав и порядок — в плане. Она не про сборку ядра Linux со стороны администратора: конфигурация, модули и параметры загрузки разобраны в отдельной заметке, и пересечение здесь только в именах файлов. Все примеры ниже выверялись на дереве mainline 7.3-rc1 и на исходниках FreeBSD main.
Freestanding: чего нет и почему
Что обещает стандарт и почему этого мало
Формально всё просто. Стандарт C определяет две среды: hosted, где доступна вся стандартная библиотека и вход в программу — main, и freestanding, где «библиотечных средств может не быть сверх тех, что требуются от freestanding-реализаций, а обработка запуска и завершения программы определяется реализацией». Флаг -ffreestanding переводит компилятор во второй режим: __STDC_HOSTED__ становится нулём, а компилятор, как формулирует документация GCC, «не делает предположений о значении имён функций из стандартной библиотеки». Тот же флаг подразумевает -fno-builtin.
Перечень того, что freestanding-реализация обязана предоставить, документация GCC приводит накопительно, по редакциям стандарта. В редакции C11 он невелик и — что важнее — состоит из одних деклараций: <float.h>, <limits.h>, <stdarg.h>, <stddef.h>, <iso646.h>, <stdbool.h>, <stdint.h>, <stdalign.h>, <stdnoreturn.h>. Ни одного байта кода. Практически это означает, что стандарт гарантирует вам size_t, NULL, uint64_t и работу с переменным числом аргументов — и ничего более. Всё, что делает что-нибудь, вы пишете сами. Редакцию здесь стоит называть вслух, потому что она перестала быть умолчанием: начиная с GCC 15 компилятор без явного -std собирает как -std=gnu23, а про C23 та же страница документации говорит, что freestanding-реализация обязана поддерживать «более широкий круг библиотечных средств, включая некоторые функции из других заголовков». То есть «ни одного байта кода» — свойство списка C11, а не freestanding-режима как такового.
Полезнее формального определения — то, как флагом распоряжаются реальные ядра, потому что здесь они расходятся. FreeBSD включает -ffreestanding для всего ядра, и комментарий в sys/conf/kern.mk называет причину прямо: «GCC 3.0 и выше любит делать некоторые оптимизации, исходя из предположения, что программа скомпонована с libc. Прекратить это». Linux -ffreestanding для основного ядра не передаёт вовсе — он раздаёт его точечно: распаковщику и коду реального режима на x86 (REALMODE_CFLAGS в arch/x86/Makefile), файлам с интринсиками NEON на arm64. Вместо этого Linux убирает системные заголовки (-nostdinc) и гасит отдельные встроенные функции по мере того, как они начинают мешать: в верхнем Makefile живёт -fno-builtin-wcslen с комментарием «убедиться, что компиляторы не превращают некоторые циклы в вызовы wcslen()».
Разница осмысленная, и обе позиции защитимы. -ffreestanding отключает знание компилятора о библиотечных функциях целиком, а вместе с ним и полезную его часть: способность встроить memcpy вместо вызова и знание, что memcpy не портит произвольную память. Linux эту способность бережёт и платит точечными флагами по мере обнаружения проблем — по мере обнаружения буквально: -fno-builtin-wcslen дописан после того, как компилятор начал сворачивать в вызов циклы, написанные руками. Для своего ядра правильный старт — всё-таки -ffreestanding, но полезно точно знать, какой класс проблем он снимает, а какой оставляет. Снимает он преобразования по семантике libc: компилятор перестаёт узнавать в вашем коде библиотечную функцию и подставлять вызов на её место — тот самый случай с wcslen, — а заодно перестаёт делать предположения о том, чего такая функция не делает, вроде названного в документации GCC «strlen не изменяет глобальную память». Оставляет он две вещи, и обе известны заранее: четыре функции работы с памятью, которые GCC зовёт по праву и с -ffreestanding тоже — про них следующий раздел, — и подпрограммы libgcc, до которых флаг не дотягивается вовсе. Тем остаток и хорош, что он перечислим и ловится компоновкой: при -nostdlib -static неразрешённый символ — это ошибка сборки, а не отказ на живой машине. До машины дело доходит, только если символ чем-то разрешился, — например, вашей же реализацией memset, свёрнутой оптимизацией в вызов самой себя.
Функции, которые компилятор зовёт сам
Самое неприятное свойство freestanding-окружения в том, что оно не полностью freestanding. Документация GCC говорит об этом одной строкой: «GCC требует, чтобы freestanding-окружение предоставляло memcpy, memmove, memset и memcmp». То есть даже с -ffreestanding компилятор оставляет за собой право сгенерировать вызов этих четырёх функций из кода, где вы их не писали, — например, при присваивании структуры или при инициализации массива.
Дальше начинается ловушка, на которой спотыкаются все. Оптимизация -ftree-loop-distribute-patterns, включённая на -O2 и выше, распознаёт цикл, заполняющий память константой, и заменяет его вызовом memset. Примените это к телу вашей собственной реализации memset — получите функцию, вызывающую саму себя. Лечится либо -fno-tree-loop-distribute-patterns на файл с реализациями строковых операций, либо сборкой этого файла отдельными флагами.
Строковыми операциями дело не исчерпывается, и вот здесь паритет архитектур особенно нагляден, потому что у каждой свой набор скрытых вызовов в libgcc. На ARM64 по умолчанию включён -moutline-atomics: атомарные операции превращаются в вызовы вспомогательных функций, которые в рантайме определяют, доступны ли инструкции LSE из ARMv8.1-A, и если нет — используют пару load/store-exclusive. Вспомогательные функции живут в libgcc, и FreeBSD отключает механизм явно (-mno-outline-atomics). На RISC-V есть -msave-restore, где прологи и эпилоги функций заменяются вызовами библиотечных подпрограмм ради размера кода; Linux передаёт -mno-save-restore, хотя умолчание и так — встроенные прологи. На 32-битных целях 64-битное деление превращается в вызов __udivdi3. Защита стека зовёт __stack_chk_fail.
Общее правило отсюда важнее любого из частных случаев: вывод компилятора — это не замкнутый набор инструкций, а инструкции плюс неявная зависимость от библиотеки поддержки языка. У обычной программы эта зависимость удовлетворяется автоматически и потому невидима. Ядро обязано либо предоставить недостающее, либо выключить порождающие его возможности — и выключается это разными флагами на разных архитектурах, потому что порождают их разные механизмы.
Кучи нет, пока вы её не написали
Аллокатор — часть ядра, а не сервис под ним, и это не формальность, а разворот отношений. Прикладная программа получает память у системы и не обязана знать, откуда система её взяла; ядро обязано, потому что оно и есть та система. Задача раскрутки — чтобы построить таблицы страниц, нужна память; чтобы выделять память, нужен аллокатор; чтобы заработал аллокатор, нужна память под его метаданные — предмет отдельной статьи цикла про физическую память.
Для сборки существенно то, как отсутствие кучи выглядит с точки зрения языка, и здесь три языка ведут себя по-разному настолько, что это заметно влияет на выбор. Для C вопроса нет: malloc — просто функция, вы её пишете, компилятор ничего о ней не знает. У Rust библиотека alloc устроена вокруг предположения, что выделение либо удаётся, либо программа завершается, — и ядро Linux от неё отказалось, построив собственные KBox и KVec, где каждая операция, способная выделить память, принимает флаги GFP и возвращает Result. У Zig аллокатор с самого начала является явным параметром: «любая функция, которой нужно выделить память, принимает параметр-аллокатор. Как следствие, стандартную библиотеку Zig можно использовать даже для цели freestanding». Это не деталь удобства — это ответ на вопрос, сколько чужого кода вы сможете взять, не переписывая.
Плавающей точки нет, и это следствие входа в ядро
Запрет на плавающую точку в ядре выглядит произвольным, пока не назвать причину, и причина не в том, что вычисления с плавающей точкой ядру не нужны. Документация Linux формулирует её в двух предложениях: «Коду ядра обычно запрещено использовать регистры или инструкции плавающей точки, включая типы C float и double. Это правило снижает накладные расходы системного вызова, потому что ядру не нужно сохранять и восстанавливать состояние регистров плавающей точки пользовательского пространства». То есть запрет — обратная сторона решения не сохранять контекст FPU при входе в ядро; механизм самого входа разбирается отдельной статьёй цикла, здесь достаточно следствия: регистры FPU при входе продолжают принадлежать прерванному потоку, и любое обращение к ним из ядра эти данные уничтожит.
Компилятору об этом надо сказать явно, и снова не потому, что вы собираетесь считать в double. Та же документация называет настоящую причину: компиляторы иногда используют регистры плавающей точки для оптимизации встроенного memcpy или присваивания переменной, поскольку эти регистры шире целочисленных. Один флаг лечит это, но выражается он на трёх архитектурах по-разному, и разница поучительна:
# общая часть: ни библиотек, ни стартовых файлов, ни системных заголовков
CFLAGS='-ffreestanding -nostdinc -fno-stack-protector -fno-asynchronous-unwind-tables'
LDFLAGS='-nostdlib -static -T kernel.ld'

# x86-64: запрет перечисляется по расширениям, и забыть одно легко
CFLAGS_X86='-mno-sse -mno-mmx -mno-sse2 -mno-3dnow -mno-avx -mno-sse4a -mno-80387 -mno-fp-ret-in-387 -mno-red-zone -mcmodel=kernel'
# ARM64: тот же запрет одним флагом, модель кода менять не нужно
CFLAGS_ARM64='-mgeneral-regs-only'
# RISC-V: запрет выражен не флагом, а выбором ABI — lp64 против lp64d
CFLAGS_RISCV='-march=rv64imac -mabi=lp64 -mcmodel=medany'
RISC-V здесь интереснее остальных: у него отказ от плавающей точки — это не запрет на инструкции, а выбор целочисленного ABI (lp64 вместо lp64d), то есть соглашения, по которому аргументы не передаются в FP-регистрах. FreeBSD пользуется разделением буквально: оставляет расширения F и D в -march, чтобы код переключения контекста мог сохранять регистры плавающей точки, и при этом собирает ядро с -mabi=lp64, чтобы компилятор не трогал их сам.
Когда плавающая точка всё-таки нужна — обычно в криптографии или контрольных суммах, ускоренных векторными инструкциями, — её включают явными окнами: kernel_fpu_available(), затем kernel_fpu_begin() и kernel_fpu_end() вокруг критической секции; у FreeBSD это fpu_kern_enter(). Существенны ограничения окна, а не его наличие. Код с плавающей точкой обязан лежать в отдельной единице трансляции, собираемой своими флагами, — «чтобы не дать компилятору сгенерировать код, трогающий FP-регистры вне этих критических секций»: попросить «регион без FPU» внутри файла нечем. Сама секция гарантированно вызываема только из процессного контекста, внутри неё может быть запрещено вытеснение, и реентерантной она не обязана быть — вложенность вы считаете сами.
Раскрутки стека нет
Ядра просят компилятор таблиц не делать, и комментарий в arch/arm64/Makefile предельно краток: «избежать генерации секций .eh_frame». Строгость при этом у архитектур разная: arm64 передаёт пару -fno-asynchronous-unwind-tables -fno-unwind-tables, x86 обходится первым флагом из двух. Таблицы раскрутки описывают, как восстановить состояние вызывающего при проходе по стеку вверх; порождаются они прежде всего ради исключений, которых в ядре нет, и потому оказываются мёртвым весом в образе. Обратные трассировки ядру при этом нужны, но берутся не отсюда: указателем кадра либо специально придуманным форматом метаданных, компактнее DWARF. Ассемблерные точки входа в любом случае описываются вручную — автоматически там описывать нечего, кадра в привычном смысле нет. Показательно, что решение не абсолютно: arm64 умеет собираться и с таблицами (CONFIG_UNWIND_TABLES), и тогда флаги переворачиваются на -fasynchronous-unwind-tables.
Из отсутствия раскрутки следует отсутствие исключений и всего, что на них построено. Для C это ничего не меняет. Для Rust это означает -Cpanic=abort: паника не разматывает стек, а останавливает, и обработчик паники вы пишете сами (#[panic_handler]). Для C++ это означало бы -fno-exceptions -fno-rtti, что вычёркивает из языка изрядную часть его самого.
Локальной памяти потока нет — есть данные на процессор
__thread в ядре не используется, и дело не только в том, что под ним нет рантайма, который завёл бы область TLS: он означал бы не то. Поток ядра мигрирует между процессорами, а данные, которые обычно хотят получить по быстрому пути, — счётчики, текущая задача, локальный список — принадлежат процессору, а не потоку, и обязаны следовать за процессором. Механизм, которым это делается, разобран в первой статье цикла: база GS на x86-64 и swapgs при входе, TPIDR_EL1 на ARM64, регистр tp на RISC-V.
Здесь важна другая сторона того же механизма — как об этом узнаёт компилятор, ведь распределитель регистров по умолчанию считает своими все регистры общего назначения. Способов три, и все три встречаются в живых деревьях. Linux на RISC-V объявляет глобальную регистровую переменную — register struct task_struct *riscv_current_is_tp __asm__("tp"), — после чего current компилируется в чтение tp без единой инструкции. FreeBSD на ARM64 резервирует платформенный регистр целиком: -ffixed-x18 с комментарием «зарезервировать x18 под данные pcpu»; Linux на той же архитектуре тратит -ffixed-x18 на теневой стек вызовов, и то условно — только при включённом CONFIG_SHADOW_CALL_STACK, — а данные процессора держит в TPIDR_EL1. Третий способ — попросить компилятор о конкретной услуге: у GCC есть -mstack-protector-guard=sysreg с указанием регистра и смещения, и документация объясняет происхождение опции честнее некуда — «нет умолчания для регистра и смещения, поскольку это целиком для использования внутри ядра Linux». Канарейка защиты стека обычно лежит в TLS; в ядре TLS нет, и компилятору пришлось научиться брать её из данных процессора.
Компоновка
Скрипт компоновщика как часть исходников
Обычная программа собирается без скрипта компоновки, потому что он есть — встроенный, и он делает разумные вещи: складывает секции в привычном порядке, назначает адреса, оставляет место под заголовки. Ядру этого мало по четырём независимым причинам, и полезно держать их раздельно, потому что каждая может укусить отдельно.
Во-первых, порядок. Точка входа обязана оказаться там, куда передаст управление загрузчик, а это не всегда адрес из заголовка ELF: протокол загрузки может прыгать в начало плоского образа, ничего не читая. ENTRY(_start) записывает точку входа в заголовок, но не гарантирует её расположения — это делает порядок секций в скрипте.
Во-вторых, границы. Ядру нужны символы, которых нет в исходниках: где кончается текст, где начинается и кончается .bss, где начинается и кончается раздел инициализации. Обнулить .bss некому, кроме самого ядра, а чтобы обнулить, нужны его границы.
В-третьих, выравнивание. Права назначаются страницами, значит границы между областями с разными правами обязаны быть выровнены на страницу; об этом ниже отдельно.
В-четвёртых — то, о чём вспоминают последним. Новая секция, появившаяся из-за флага компилятора или чужого объектного файла, будет размещена компоновщиком по эвристике, и обнаружится это на живой машине. Linux эту дыру закрывает явно: --orphan-handling с комментарием «мы никогда не хотим, чтобы ожидаемые секции размещались компоновщиком эвристически. Все секции должны быть явно названы в скрипте компоновки». Для своего ядра это стоит включить с первого дня — цена нулевая, а найденная ошибка всегда неочевидная.
Адрес загрузки против адреса исполнения
Различие, снимающее половину вопросов о ранней загрузке, документация GNU ld формулирует в двух определениях. VMA — «адрес, который секция будет иметь при исполнении файла». LMA — «адрес, по которому секция будет загружена». У обычной программы они совпадают, и потому о существовании двух адресов легко не узнать за всю карьеру. У ядра они различаются всегда, и по причине более фундаментальной, чем классический пример ld про данные в ПЗУ, копируемые в ОЗУ при старте: ядро собрано под виртуальные адреса, которых в момент загрузки образа ещё не существует. Их создаст сам образ, когда построит таблицы страниц и включит трансляцию, — а до тех пор он лежит по физическому адресу, выбранному загрузчиком или прошивкой.
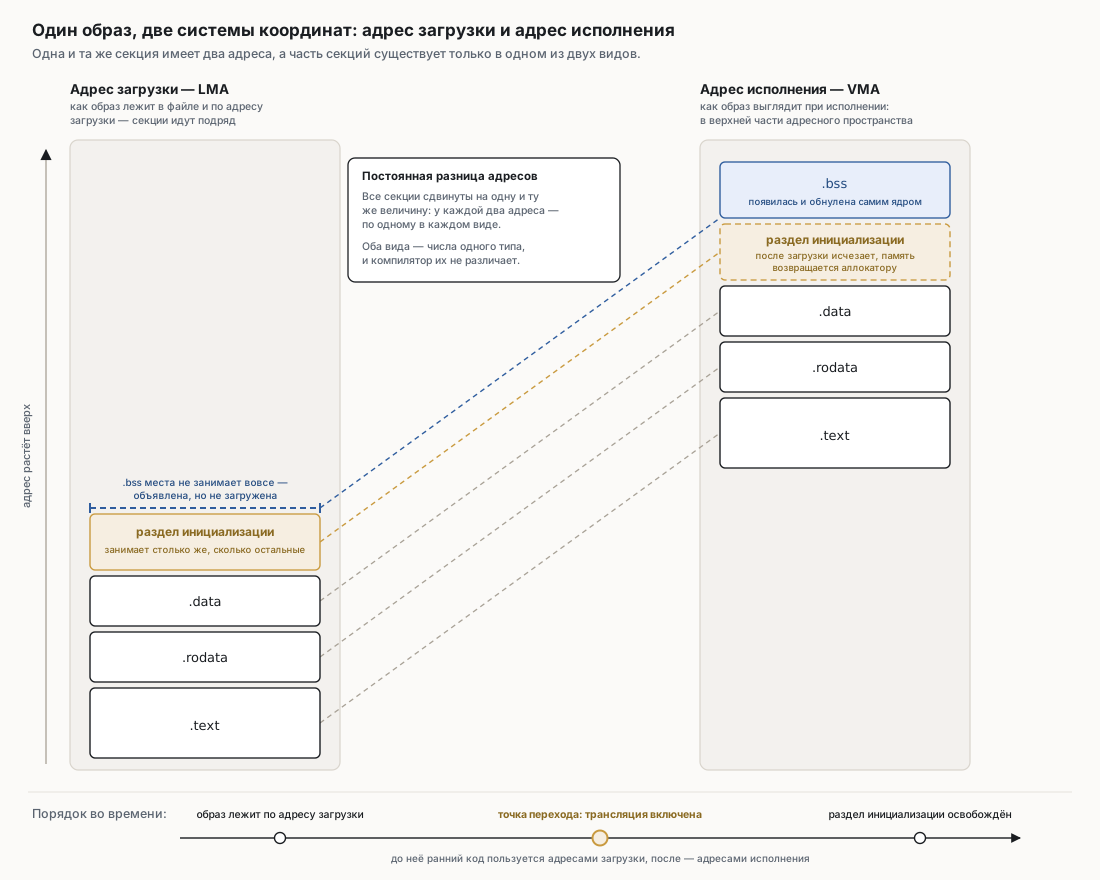
В скрипте это выражается одной конструкцией: секции назначается VMA обычным способом, а LMA задаётся через AT(). Реальный скрипт ядра Linux на x86 делает ровно это — .text : AT(ADDR(.text) - LOAD_OFFSET), где LOAD_OFFSET есть база отображения ядра; то есть физический адрес получается вычитанием константы из виртуального. Минимальный самостоятельный вариант выглядит так:
KERNEL_VMA = 0xffffffff80000000;   /* верхние 2 ГиБ: этого требует -mcmodel=kernel */
KERNEL_LMA = 0x200000;             /* куда образ кладёт загрузчик */

ENTRY(_start)

SECTIONS
{
    . = KERNEL_VMA + KERNEL_LMA;

    .text : AT(ADDR(.text) - KERNEL_VMA) {
        *(.text.boot)              /* точка входа: загрузчик придёт по адресу загрузки */
        *(.text .text.*)
    }

    . = ALIGN(4096);               /* граница прав — всегда граница страницы */
    .rodata : AT(ADDR(.rodata) - KERNEL_VMA) { *(.rodata .rodata.*) }

    . = ALIGN(4096);
    .data   : AT(ADDR(.data) - KERNEL_VMA)   { *(.data .data.*) }

    . = ALIGN(4096);
    __bss_start = .;
    .bss    : AT(ADDR(.bss) - KERNEL_VMA)    { *(.bss .bss.*) *(COMMON) }
    __bss_end = .;
}
Три следствия этого различия стоит проговорить, потому что они и есть источник ранних падений. Первое: код, исполняющийся до включения трансляции, обязан обращаться к данным по адресам загрузки, а не по адресам, которые ему подставит компилятор из символов, — отсюда весь ранний ассемблер и вычитания константы вручную. Второе: .bss не имеет содержательного LMA, потому что в образе её нет — она объявлена, но не загружена, и обнулять её будет само ядро по границам из скрипта. Третье: символы границ существуют в двух видах, виртуальном и физическом, и путаница между ними — классическая ошибка, потому что оба вида являются числами одного типа и компилятор их не различает. Сам момент перехода — где именно ранний код перестаёт пользоваться адресами загрузки и начинает пользоваться адресами исполнения — принадлежит не этой статье, а той, что в цикле разбирает загрузку: инструкция, включающая трансляцию, исполняется по адресу, который обязан быть осмысленным сразу в обеих картах, и три архитектуры решают это по-разному.
Модели кода: система команд задаёт раскладку
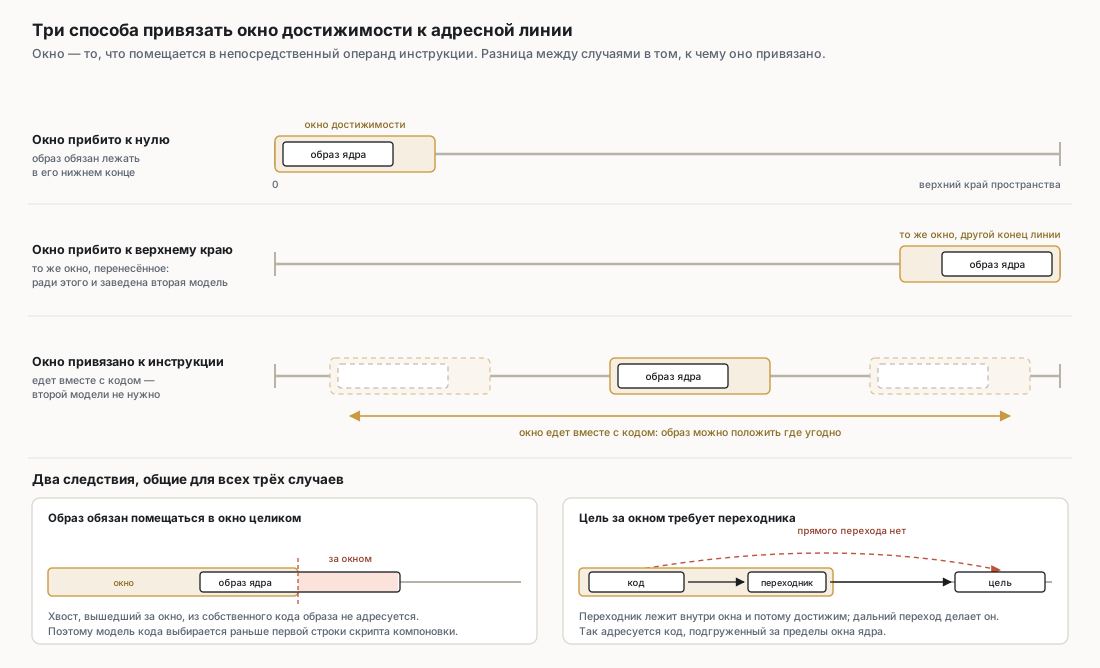
Это тот редкий случай, где ограничение на кодирование инструкций напрямую диктует, в какой части адресного пространства живёт ядро. Механизм на всех трёх архитектурах один: адрес символа надо как-то поместить в инструкцию, а места под полный 64-битный адрес там нет. Различаются архитектуры не этим, а тем, к чему привязано окно достижимости.
Спецификация SysV AMD64 говорит прямо: «архитектура x86-64 обычно не позволяет инструкции закодировать произвольную 64-битную константу как непосредственный операнд. Большинство инструкций принимают 32-битные непосредственные, расширяемые знаком до 64-битных», и то же ограничение действует для переходов и для адресации относительно счётчика команд. Отсюда 2 ГиБ достижимости — и отсюда же две модели: малая привязывает окно к нулю, а «ядерная» — к верхнему краю пространства, «поскольку ядро операционной системы обычно довольно мало, но исполняется в отрицательной половине адресного пространства». Именно это, а не соображения безопасности или традиция, и есть причина, по которой ядро x86-64 живёт в верхних двух гигабайтах.
| Архитектура и модель | К чему привязано окно | Досягаемость | Как выражено в инструкциях |
|---|---|---|---|
x86-64, small |
к нулю | от 0 до 2³¹−2²⁴−1 |
32-битные знаковые непосредственные, RIP-относительная адресация |
x86-64, kernel |
к верхнему краю | от 2⁶⁴−2³¹ до 2⁶⁴−2²⁴ |
те же кодировки, окно перенесено вверх |
ARM64, small (умолчание) |
к счётчику команд | окно 4 ГиБ где угодно | adrp + add |
RISC-V, medlow |
к нулю | от −2 ГиБ до +2 ГиБ | lui + смещение |
RISC-V, medany |
к счётчику команд | окно 2 ГиБ где угодно | auipc + смещение |
Читать таблицу стоит по второму столбцу. Там, где окно привязано к счётчику команд, отдельной «ядерной» модели не нужно вовсе — код сам таскает своё окно за собой, и вопрос «куда положить ядро» перестаёт быть вопросом компилятора. Поэтому ARM64 собирается моделью по умолчанию, а 64-битный RISC-V — моделью medany; medlow остаётся 32-битным конфигурациям, где всё пространство и так помещается в окно. Тут же поджидает ловушка именования, которую FreeBSD документирует в своём kern.mk: одну и ту же модель clang называет medium, а GCC — medany, и сборка ядра одним компилятором с флагом от другого просто не начнётся.
Практическое следствие модели кода живёт не в самом ядре, а в том, что грузится к нему потом. Модуль, попавший за пределы окна, адресовать напрямую нельзя, и загрузчику модулей приходится синтезировать переходники: код arm64 в arch/arm64/kernel/module.c содержит и «вне досягаемости ADR — сгенерировать переходник», и генерацию элементов PLT для вызовов дальше досягаемости bl. То же соображение объясняет, почему модули на RISC-V собираются моделью medany, даже когда само ядро собрано medlow. Для своего ядра вывод простой: модель кода выбирается один раз, до первой строки скрипта компоновки, потому что она задаёт диапазон адресов, а из диапазона адресов вытекает всё остальное, включая то, где вы разместите динамически загружаемый код. Карта памяти ядра целиком — предмет отдельной статьи цикла.
Перемещаемое ядро против фиксированного адреса
Ядро можно собрать под конкретный виртуальный адрес и грузить только туда, а можно сделать перемещаемым — и это разные объёмы работы, а не настройка. Реализаций две, и обе живут в mainline.
Первая — собрать образ как позиционно-независимый и применить перемещения при старте. ARM64 и RISC-V идут этим путём: CONFIG_RELOCATABLE добавляет к сборке -fPIE, а к компоновке -shared -Bsymbolic -z notext, после чего ранний код проходит по таблице RELA и правит адреса. Цена названа в самом Kconfig: «поскольку AArch64 использует формат перемещений RELA, это требует прохода перемещений во время исполнения, даже если ядро загружено по тому же адресу, по которому скомпоновано».
Вторая — оставить фиксированный адрес компоновки, но заставить компоновщик сохранить сведения о перемещениях и вынести их отдельной таблицей. Так делает x86: --emit-relocs --discard-none при сборке vmlinux, затем утилита arch/x86/tools/relocs вытаскивает перемещения в файл vmlinux.relocs, который кладётся рядом со сжатым образом, а распаковщик применяет их по фактическому адресу.
Платят за перемещаемость трижды. Проход перемещений выполняется на каждой загрузке независимо от того, сдвинулся ли образ. Таблица перемещений увеличивает образ — настолько заметно, что её сжимают, для чего в сборке появился --pack-dyn-relocs=relr (он же -z pack-relative-relocs), кодирующий подряд идущие относительные перемещения битовой картой. И ранний код усложняется: до прохода перемещений абсолютными адресами пользоваться нельзя, а значит участок кода, который этот проход выполняет, обязан обойтись без них сам.
Вердикт для своего ядра: начинайте с фиксированного адреса. Перемещаемость нужна ради двух вещей — рандомизации базы и возможности исполняться там, куда образ положили, а не там, куда его скомпоновали, — и вторая становится важной, только когда адрес выбирает не ваш загрузчик, а прошивка. Рандомизация же имеет смысл тогда, когда всё остальное уже работает и её есть что защищать. Переделка из фиксированного в перемещаемое затрагивает скрипт компоновки, ранний код и сборку, но не архитектуру ядра, поэтому откладывается дёшево — в отличие от модели кода, которую менять поздно.
Права на секции и момент их включения
Как получается, что текст ядра доступен только для чтения, — вопрос из двух половин, и вторая интереснее первой.
Первая половина — механическая. Права назначаются страницами, поэтому каждая граница между областями с разными правами обязана быть выровнена на страницу: . = ALIGN(PAGE_SIZE) в скрипте компоновки, дальше символ границы, дальше проход по диапазону, выставляющий права в записях таблиц. Форма записи и то, как права набираются вдоль пути обхода, разобраны в статье про страничную трансляцию. Выравнивание не бесплатно: оно оставляет неиспользованные хвосты, а на x86-64 Linux выравнивает конец .rodata не на страницу, а на большую страницу (HPAGE_SIZE), чтобы отображение ядра можно было собрать блоками по 2 МиБ, — прямой обмен памяти на охват TLB. Там же в сборку добавляется -z max-page-size=0x200000 — комментарий в arch/x86/Makefile объясняет, что 64-битное ядро обязано быть выровнено на 2 МиБ, а флаг заставляет компоновщика считать так независимо от его собственного умолчания.
Вторая половина — когда именно права включаются, и ответ «не сразу» имеет причину. Раннее ядро правит собственный текст: подставляет варианты инструкций под обнаруженный процессор, включает и выключает статические ветвления, размечает точки трассировки. Пока это происходит, текст обязан быть доступен на запись. Последовательность в init/main.c показывает точный порядок: free_initmem() освобождает раздел инициализации, затем mark_readonly() дожидается завершения отложенных работ, переводит в постоянный режим статические ветвления (jump_label_init_ro()) и вызывает mark_rodata_ro(), затем pti_finalize() доводит до конца изоляцию таблиц страниц — и только после этого система объявляется работающей. То есть окно записи в собственный текст закрывается последним действием загрузки, а не первым.
Своё ядро полезно строить с той же развилкой в голове: если вы собираетесь патчить инструкции — а рано или поздно собираетесь, — то либо права выставляются в конце загрузки, либо в ядре появляется отдельный механизм временного отображения текста на запись, и он немедленно становится самым интересным местом для атаки.
Разделы, выбрасываемые после загрузки
Код, нужный ровно один раз, занимает память всё время работы машины, если ничего не предпринять. Механизм борьбы — атрибут размещения: функция помечается как принадлежащая разделу инициализации, компоновщик собирает такие функции вместе между символами границ, а ядро после загрузки возвращает диапазон аллокатору. В Linux это __init и .init.*, границы __init_begin/__init_end, освобождение — free_initmem_default(POISON_FREE_INITMEM), то есть с заполнением ядовитым значением, чтобы обращение к освобождённому обнаружилось шумно. Место этого диапазона в скрипте компоновки тоже не произвольно: в arch/x86/kernel/vmlinux.lds.S он лежит между .data и .bss, и причина в том, чем .bss отличается от всего остального, — у раздела инициализации содержимое в образе есть, у .bss его нет, поэтому всё, что несёт байты, обязано оказаться раньше секции, не занимающей в файле места.
Механизм — именно размещение, а не освобождение: вернуть память россыпью нельзя, диапазон обязан быть непрерывным, и непрерывным его делает компоновщик. Отсюда же его главная опасность. Вызов функции инициализации после загрузки — это обращение к освобождённой памяти, и обычная сборка его не поймает, потому что на уровне C это законный вызов законной функции. Ловится он проверкой соответствия секций — в Linux это делает modpost, ругаясь на ссылку из обычного кода в .init.* на этапе сборки. Если вы заводите такой раздел у себя, заводите вместе с ним и проверку, иначе получите механизм, который экономит сотню килобайт и раз в полгода роняет систему.
ABI: три соглашения вместо одного
Соглашение о вызовах
Внутри ядра действует обычный C-ABI целевой платформы — ничего специфического для ядра в нём нет, кроме того, что нарушать его теперь некому за вас. Сводка по трём архитектурам:
| x86-64 (SysV) | ARM64 (AAPCS64) | RISC-V (psABI) | |
|---|---|---|---|
| Целочисленные аргументы | rdi, rsi, rdx, rcx, r8, r9 |
x0–x7 |
a0–a7 |
| Возврат | rax, второй в rdx |
x0, второй в x1 |
a0, второй в a1 |
| Сохраняет вызываемый | rbx, rbp, r12–r15, rsp |
x19–x28, x29, sp |
s0–s11, sp |
| Выравнивание стека | rsp+8 кратно 16 в точке входа |
sp кратно 16 |
sp кратно 16 |
| Ниже указателя стека | 128 байт неприкосновенны | обращаться запрещено | полагаться запрещено |
Последняя строка — та, где различие важнее прочих для ядра, и она же объясняет один из самых загадочных флагов сборки.
Красная зона
SysV AMD64 объявляет 128 байт ниже rsp зарезервированными: эта область «не должна изменяться обработчиками сигналов и прерываний», а потому листовая функция может разместить там весь свой кадр, не трогая указатель стека вовсе. Сноска в спецификации называет и мотив: 128 байт адресуются однобайтовым смещением.
Для пользовательского кода это чистый выигрыш. Для ядра — источник тихого разрушения памяти, и документация GCC формулирует почему, описывая атрибут interrupt: «любой код, прерываемый без переключения стека, должен собираться с -mno-red-zone, поскольку обработчики прерываний могут и будут, из-за устройства аппаратуры, затрагивать красную зону». Прерывание, пришедшее, когда процессор уже в ядре, стека не меняет и складывает своё состояние прямо туда, где прерванная функция держала свои данные. Отсюда -mno-red-zone в сборке ядра на x86-64 и у Linux, и у FreeBSD.
Наглядно здесь то, что проблема целиком x86-64-специфична, причём по решению ABI, а не архитектуры. AAPCS64 требует обратного: «ни один поток не имеет права обращаться (для чтения или для записи) к неактивной области» стека. RISC-V psABI столь же прям: «процедуры не должны полагаться на сохранность размещённых на стеке данных, адреса которых лежат ниже указателя стека». То есть на двух из трёх архитектур красной зоны нет и флага не требуется — и если вы переносите ядро с x86-64 и не найдёте в чужих сборочных файлах аналога -mno-red-zone, это не упущение. Стеки ядра, стеки прерываний и то, почему их вообще несколько, разобраны в отдельной статье цикла.
ABI системного вызова
Соглашение системного вызова — отдельное от C-ABI, и это не историческая случайность, а следствие того, что инструкцию перехода в ядро проектировали в железе. Комментарий в точке входа Linux на x86-64 показывает механизм полностью: «64-битный SYSCALL сохраняет rip в rcx, сбрасывает rflags.RF, затем сохраняет rflags в r11 <…> SYSCALL ничего не сохраняет на стеке и не меняет rsp». Инструкция забирает себе rcx и r11, а rcx в C-ABI — регистр четвёртого аргумента; поэтому четвёртый аргумент системного вызова едет в r10, и в том же комментарии рядом с ним стоит пометка «нужно переложить в rcx, чтобы соответствовать C ABI». Перекладывают обёртки в libc — и у glibc, и у FreeBSD в стабе стоит одна и та же инструкция movq %rcx, %r10 перед syscall; у FreeBSD она безусловна, у glibc спрятана в макрос DOARGS_4 и появляется у вызовов от четырёх аргументов, то есть ровно там, где четвёртый аргумент вообще возникает. Это и есть самый наглядный признак того, что перед вами два разных соглашения, а не одно: между вызовом функции и системным вызовом всегда стоит переходник, пусть даже в одну инструкцию.
Способ вернуть ошибку различается уже не архитектурой, а операционной системой, и это самое поучительное различие во всём разделе.
| Linux | FreeBSD | |
|---|---|---|
| x86-64 | номер в rax, аргументы rdi, rsi, rdx, r10, r8, r9; ошибка — отрицательный код в rax |
номер и аргументы те же; ошибка — флаг переноса, положительный код в rax |
| ARM64 | номер в x8, аргументы x0–x5; ошибка — отрицательный код в x0 |
номер в x8; ошибка — флаг C в PSTATE, проверяется b.cs |
| RISC-V | номер в a7, аргументы a0–a5; ошибка — отрицательный код в a0 |
номер в t0; ошибка — t0 отличен от нуля после возврата, положительный код в a0 |
Правая колонка последней строки — это то, ради чего таблицу стоит рассматривать. FreeBSD исторически сигнализирует об ошибке флагом переноса; у RISC-V регистра флагов нет вовсе, и соглашение пришлось перенести в обычный регистр: ядро выставляет t0 в единицу при ошибке и в ноль при успехе, а обёртка libc проверяет его условным переходом. Механизм сохранён, носитель заменён.
# FreeBSD, RISC-V: номер в t0, он же признак ошибки при возврате
li      t0, SYS_read
ecall
bnez    t0, 1f
ret
1:      la t1, cerror                # положительный код ошибки лежит в a0
        jr t1

# Linux, RISC-V: номер в a7, ошибка закодирована в самом результате
li      a7, __NR_read
ecall
                                     # значение a0 в [-4095, -1] — это -errno
У обоих способов есть цена, и обе видны. Отрицательный код навсегда отнимает у диапазона возвращаемых значений верхние 4096: ядро закрепляет число константой MAX_ERRNO, равной 4095, а libc проверяет ровно эту границу — комментарий в glibc для x86-64 объясняет происхождение соглашения буквально: «Линус сказал, что позаботится о том, чтобы ни один системный вызов не возвращал значение из -1 .. -4095 как правильный результат, так что мы можем спокойно сравнивать с -4095», после чего идёт cmpq $-4095, %rax; jae SYSCALL_ERROR_LABEL. Флаг переноса не отнимает ничего, но требует от архитектуры флага, которого может не оказаться. Для своего ядра вердикт прямой: отрицательный код ошибки, потому что он не требует от системы команд ничего и переживает перенос на следующую архитектуру без изобретений. Потеря четырёх килобайт из диапазона возвращаемых значений — цена, которую вы не заметите; поиск замены флагу на третьей по счёту архитектуре — заметите.
Почему точки входа пишут на ассемблере
Причина не в том, что ассемблер быстрее, и не в том, что нужны привилегированные инструкции. Причина в порядке: сохранить регистры надо раньше, чем начнёт исполняться хоть одна инструкция, сгенерированная компилятором, а сказать компилятору «эта функция начинается в момент, когда живы все регистры» нечем.
Компилятор пишет пролог функции исходя из того, что сюда пришли вызовом: часть регистров по соглашению уже принадлежит вызываемому, и портить их можно свободно. Исключение или прерывание приходит не вызовом — управление отнимается между двумя произвольными инструкциями произвольного кода, и живо всё. Первая же инструкция, сгенерированная компилятором, может оказаться записью в регистр, который прерванный код собирался использовать.
Частично компиляторы это умеют: у GCC на x86 есть атрибут interrupt, при котором «все регистры, кроме EFLAGS, восстанавливаемого инструкцией IRET, сохраняются компилятором», а возврат делается через IRET; требуется при этом -mgeneral-regs-only, поскольку состояния SSE, MMX и x87 компилятор не сохраняет. Но полного ответа это не даёт, и хорошо видно, чего именно не хватает: атрибут не сделает swapgs, не переключит стек, не переключит корень таблиц страниц при включённой изоляции и вовсе неприменим к пути системного вызова — там, как сказано выше, аппаратура не меняет указатель стека, так что первые инструкции обязаны работать на стеке пользователя или вовсе без него.
Отсюда устойчивая форма, одинаковая во всех ядрах: несколько десятков строк ассемблера, которые сохраняют регистры в структуру заранее известного вида, переключают то, что нужно переключить, и вызывают функцию на C, передавая ей указатель на сохранённый кадр. Граница между ассемблером и C проходит ровно там, где состояние стало описываться C-ABI.
vDSO: способ не входить в ядро вовсе
Часть системных вызовов не нуждается в привилегиях — им нужны данные, которые ядро могло бы просто показать. Механизм, который из этого вырос, у Linux называется vDSO: «маленькая разделяемая библиотека, которую ядро автоматически отображает в адресное пространство всех программ». Адрес отображения программа узнаёт из вспомогательного вектора ELF по тегу AT_SYSINFO_EHDR; набор символов зависит от архитектуры и включает чтение времени на всех трёх (__vdso_clock_gettime и родственные, под своими именами на arm64).
С точки зрения этой статьи в vDSO интереснее всего то, как он смещает границу совместимости. Во-первых, вызывается он не как системный вызов, а как функция: «вы используете стандартные соглашения о вызовах C при вызове любой из этих функций. Не нужно беспокоиться о странном поведении регистров или стека». То есть ядро собирает и отдаёт кусок себя, который снаружи выглядит библиотекой, — со всеми вытекающими требованиями к сборке: позиционно-независимый код, никаких обращений к тому, чего нет у процесса, отдельный скрипт компоновки, отдельные флаги. Во-вторых, номер системного вызова — это соглашение навсегда, а символ в vDSO ищется по имени и версии, и потому реализацию можно менять. Взамен публичным становится другое: раскладка страницы данных, из которой vDSO читает.
FreeBSD решает ту же задачу иначе, и сравнение показывает, где именно проходит выбор. Отдельного ELF-объекта ядро не отдаёт — оно отображает разделяемую страницу, а функции вроде __vdso_clock_gettime живут в libc и читают из этой страницы структуру vdso_timehands, снабжённую номером версии и кодом алгоритма таймера. Linux публикует код и прячет данные, FreeBSD публикует данные и оставляет код в libc; и там и там появляется новый ABI, но он разного рода. Для своего ядра из этого следует практическое: как только вы отображаете процессу страницу со своими данными, её раскладка становится обязательством, и версионировать её надо с первого дня — задним числом это не приделывается.
Выбирать же между двумя формами стоит по тому, что обязано уметь меняться. Начинать дешевле с формы FreeBSD — страница данных с номером версии и функция в libc, которая её читает: страницу вы отображаете в любом случае, а отдельный ELF-объект внутри ядра стоит собственных флагов сборки, собственного скрипта компоновки, позиционно-независимого кода и версионирования символов. Форма Linux окупается тогда, когда меняться обязан читающий код, а не только данные: другой алгоритм часов, обход ошибки конкретного процессора, вариант на другом наборе инструкций — всё это ядро подменяет в отдаваемом объекте, ничего не пересобирая в пользовательском пространстве. Пока такой потребности нет, вы платите за неё вперёд.
Выбор языка
Что именно выбирается
Спор «C против безопасных языков» в применении к ядру сформулирован неудачно, потому что подразумевает выбор между «есть проверки» и «нет проверок». В ядре небезопасные операции — не досадное исключение, а содержание работы: запись в таблицу страниц, обращение к регистру устройства по физическому адресу, передача буфера контроллеру DMA, переключение стека. Ни одна система типов не проверит, что адрес, который вы записали в поле дескриптора, действительно указывает на выделенный вами кадр физической памяти, — она об этом соответствии не знает и знать не может.
Поэтому вопрос ставится иначе: что язык делает с той частью, которая небезопасна по существу, и что он даёт на всей остальной. Судить полезно по трём признакам — что язык предполагает о рантайме под собой, чего стоит разговор с ассемблером и железом, и какой корпус чужого кода вы сможете читать, пока учитесь.
C
Главный довод за C — не свойства языка, а корпус. Всё, на что придётся смотреть, написано на нём: Linux, FreeBSD, xv6, seL4. Механизм, разобранный в любой статье этого цикла, в конечном счёте проверяется чтением чьего-то C. Второй довод — прозрачность: между исходником и потоком инструкций нет ничего, что пряталось бы от вас, а интеграция с ассемблером тривиальна, потому что C-ABI и есть та граница, к которой ассемблер пишут. Третий — доступность тулчейна: GCC собирает под архитектуры, которых LLVM не знает, а freestanding-режим у него описан стандартом.
Цена известна, и смягчается она лишь отчасти — но отчасти всё-таки смягчается, и умолчать об этом значило бы сравнивать нечестно. Динамические санитайзеры ядра ловят ровно тот класс ошибок, который пропускает компилятор: KASAN документация ядра называет «динамическим детектором ошибок безопасности памяти, предназначенным находить выходы за границу и обращения к освобождённому», рядом с ним живут UBSAN и KMSAN. Слово «динамический» и есть ограничение: ошибка обязана оказаться на исполненном пути, а у основного, отладочного режима KASAN та же документация отдельно оговаривает заметные накладные расходы по памяти и по скорости. Статический анализ работает до исполнения, но проверяет размеченное руками — sparse встроен в сборку ядра (make C=1) и ловит смешение типов, которые вы сами объявили несовместимыми. Окно оба сужают, ни один не закрывает: гарантии, что ошибка работы с памятью будет поймана до её проявления, в C нет. В прикладной программе проявление — падение; в ядре — испорченная таблица страниц, обнаруживающаяся через три секунды в другой подсистеме, и отладка начинается с вопроса, какая из подсистем солгала.
Rust
Что Rust предполагает о рантайме, лучше всего видно на том, от чего пришлось отказаться. Ядру доступна только библиотека core: «поддержка Rust в ядре может компоноваться только с core, но не со std; крейты для использования в ядре должны выбрать это поведение атрибутом #![no_std]». Библиотека alloc тоже не подошла — она устроена вокруг предположения, что выделение памяти не отказывает, а при отказе программа завершается; ядро построило собственные KBox, KVec и родственные типы, где каждая выделяющая операция принимает флаги GFP и возвращает Result, так что отказ выделения обязан быть обработан на месте. Паника не разматывает стек (-Cpanic=abort), а обработчик паники пишется вручную.
Что даёт владение, точнее всего описывается через то, чего оно не даёт. unsafe в ядре не устраняется — он локализуется, и локализация проверяема механически. Правила Rust for Linux требуют комментария // SAFETY: перед каждым блоком unsafe, объясняющего, почему код внутри корректен, и раздела # Safety в документации небезопасной функции, описывающего контракт для вызывающего; сборка ядра включает -Dunsafe_op_in_unsafe_fn, из-за которого даже внутри небезопасной функции каждая небезопасная операция обязана быть обёрнута явным блоком. Разница с C — не в наличии проверок, а в том, где заканчивается зона ручного доказательства:
/* C: контракт существует, но только в голове у автора */
static inline void uart_put(volatile uint32_t *base, uint8_t byte)
{
        base[UART_TX] = byte;
}
pub struct Uart {
    base: *mut u32,
}

impl Uart {
    /// # Safety
    /// `base` обязан указывать на отображение регистров UART,
    /// и никто другой не должен владеть этим отображением.
    pub unsafe fn new(base: *mut u32) -> Self {
        Self { base }
    }

    pub fn put(&mut self, byte: u8) {
        // SAFETY: инвариант типа гарантирует, что `base` — регистры UART,
        // а `&mut self` — что параллельного владельца нет.
        unsafe { self.base.add(UART_TX).write_volatile(byte as u32) }
    }
}
Небезопасная операция осталась ровно одна, и доказывается она один раз, в конструкторе. Дальше идёт обычный проверяемый код — а именно им и является большая часть ядра: списки, счётчики ссылок, разбор структур, пути обработки ошибок.
Состояние на сегодня стоит зафиксировать точно, потому что тема движется быстро. Решение снять с Rust статус эксперимента принято на ежегодной встрече сопровождающих и объявлено 10 декабря 2025 года; в дереве это видно так: раздел «The Rust experiment» из Documentation/rust/index.rst присутствует в v6.19 и отсутствует в v7.0, а в init/Kconfig пометки об экспериментальности нет. Драйвер Binder на Rust появился в v6.18: CONFIG_ANDROID_BINDER_IPC_RUST есть в drivers/android/Kconfig этого тега и отсутствует в v6.17. Архитектуры с поддержкой: arm, arm64, loongarch, riscv (только riscv64 и только LLVM/Clang), s390, um, x86 (только x86_64). Минимальная версия компилятора — rustc 1.85.0, для генерации привязок к C нужен bindgen 0.71.1; сборка идёт стабильным компилятором, но с RUSTC_BOOTSTRAP=1, что комментарий в Makefile объясняет как «разрешение использовать нестабильные возможности в стабильных компиляторах». Границы у этого статуса тоже стоит назвать, потому что впечатление «Rust уже везде» неверно. По отчёту LWN с той же встречи, сопровождающий графической подсистемы сказал, что DRM примерно через год перестанет принимать новые драйверы на C и потребует Rust, — но это заявление о намерении, а не действующее правило, и по дереву оно сегодня не проверяется. Там же сказано и обратное: добавлять зависимости основного кода ядра от кода на Rust не предполагается «ещё год или два». То есть Rust сегодня — язык драйверов и подсистем, а не язык ядра целиком.
Цена для собственного ядра складывается из трёх пунктов. Стабильного ABI у языка нет: справочник Rust прямо говорит, что «раскладка типа может меняться с каждой компиляцией», поэтому всякая граница с ассемблером и с аппаратными структурами описывается через extern "C" и #[repr(C)]. Кодогенерация — только LLVM, так что архитектура, которой LLVM не знает, отпадает. И цели без операционной системы — второго уровня поддержки: x86_64-unknown-none, aarch64-unknown-none, aarch64-unknown-none-softfloat, riscv64gc-unknown-none-elf относятся к «tier 2 without host tools», что означает гарантию сборки, а не гарантию работы. Насколько шаблонные цели не покрывают ядро, видно на самом Linux: arm64 и riscv64 обходятся встроенными целями rustc, а x86_64 приходится описывать сгенерированным файлом scripts/target.json, потому что нужного сочетания модели кода, отключённой красной зоны и программной плавающей точки среди готовых целей нет.
Zig
Zig привлекателен в этой задаче двумя решениями, и оба идеологически совпадают с тем, как устроено ядро. Первое — comptime вместо препроцессора: вычисления и порождение типов происходят при компиляции средствами самого языка, а не текстовой подстановкой, то есть исчезает целый класс приёмов, которыми в ядрах на C выражают то, что языку выразить нечем. Второе — явные аллокаторы: «нет скрытого потока управления, нет скрытых выделений памяти, нет препроцессора и нет макросов», а любая функция, которой нужна память, принимает аллокатор параметром, — благодаря чему стандартная библиотека применима и на цели freestanding. Ядру, где аллокатор всё равно свой, это подходит буквально. Третье, менее идеологическое: zig cc работает готовым кросс-компилятором C, и отдельного тулчейна для сборки под другую архитектуру не требуется.
Цена — незавершённость языка, и её стоит оценивать по темпу изменений, а не по номеру версии. Последний выпуск на момент написания — 0.16.0 от 14 апреля 2026 года; в нём объявлен устаревшим @cImport с переносом трансляции заголовков C в систему сборки, целиком переделан ввод-вывод, удалены существовавшие типы потоков ввода-вывода, написан новый компоновщик ELF. Ветка master уже несёт версию 0.17.0-dev. Нетривиальный код, написанный под 0.15, на 0.16 без правок не переносится — примечания к выпуску сами описывают требуемые миграции, — и это нормальный режим языка до стабилизации, а не разовое неудобство. Второй пункт цены подпёрт слабее, и это стоит сказать прямо: ядер на Zig, кроме учебных и любительских, найти не удалось — жанр представлен минимальными примерами вроде разобранного в OSDev Wiki, а отсутствие остального ссылкой не доказывается. Считайте это наблюдением, а не установленным фактом; практический вывод от такой оговорки не меняется — корпус, по которому вы будете сверяться, всё равно останется C.
Вердикт по языку
Вопрос распадается на два, и ответы у них разные — в этом и состоит выбор.
Что даёт больше понимания механизма — C, и без колебаний. Не потому, что язык хорош, а потому, что весь материал, из которого понимание собирается, написан на нём: чтобы сравнить, как одну задачу решают Linux, FreeBSD, seL4 и xv6, надо читать четыре реализации на C. Плюс к тому C ничего не скрывает между исходником и инструкциями, а в задаче, где половина ответов лежит в том, какие именно инструкции получились, это и есть главное свойство.
Что даёт более работоспособный результат — Rust, при одном условии: цель входит в число x86-64, ARM64 или RISC-V, то есть находится на территории LLVM. Довод не в том, что система владения проверит вашу работу с таблицами страниц, — не проверит. Довод в пропорции: таблицы страниц, MMIO и DMA составляют небольшую часть ядра, а всё остальное — структуры данных, счётчики ссылок, пути обработки ошибок, — то есть ровно тот код, где проверки работают и где в C рождается большинство ошибок. К этому добавляется вынужденная явность отказов выделения памяти, которая в C достигается только дисциплиной. Цена — те же три пункта, что названы выше: всякая граница с ассемблером и с аппаратными структурами описывается вручную через extern "C" и #[repr(C)], кодогенерация только LLVM, а цели без операционной системы дают гарантию сборки, а не гарантию работы.
Какой из двух вопросов ваш — зависит от того, чем ядро является. Пока оно учебное, а цикл адресован именно тому, кто пишет учебное ядро, решает первый: цель здесь в том, чтобы понять механизм, и корпус, по которому это делается, весит больше, чем проверки компилятора. Второй становится вашим, когда ядро перестаёт быть учебным, — когда у него появляются пользователи, а неинтересная его половина начинает жить дольше, чем ваша память о том, как она устроена.
Zig имеет смысл выбрать, если comptime и явные аллокаторы для вас — не удобство, а способ выразить структуру задачи, и вы готовы платить пересборкой под движущийся язык. Это честный выбор, но его цену труднее оценить заранее, чем цену первых двух, — именно потому, что язык не закончен. Читать C придётся при любом ответе, и это цена не Zig и не Rust, а предмета: Linux, FreeBSD, seL4 и xv6 написаны на нём независимо от того, на чём пишете вы.
Наконец, стоит заметить, что решение связывает меньше, чем кажется. Граница между модулями во всех трёх случаях описывается C-ABI, ассемблерные точки входа выглядят одинаково, а скрипт компоновки вообще не знает, на чём написаны объектные файлы. Начать на C и перенести отдельную подсистему на Rust — рабочий путь; именно им идёт Linux.
Сборка и отладка
Свой toolchain обычно не нужен
Совет «соберите себе кросс-компилятор» происходит из времён, когда основной болью кросс-сборки была libc: чтобы собрать GCC, нужна библиотека C, чтобы собрать библиотеку C — компилятор. Для ядра эта петля не существует вовсе, потому что libc не нужна: сборка идёт с -nostdlib, и ни стартовых файлов, ни библиотек не требуется. Остаются ассемблер, компоновщик и компилятор под целевую архитектуру.
Дальше всё зависит от тулчейна. У LLVM вопрос снят по построению: «Clang/LLVM изначально является кросс-компилятором, то есть один набор программ может компилировать под все цели заданием опции -target»; отдельно нужен только компоновщик, и lld покрывает все три архитектуры. У Rust целевая платформа ставится одной командой, и для целей второго уровня библиотека core поставляется собранной. У Zig кросс-компиляция — заявленный основной режим работы. У GCC кросс-сборка по-прежнему означает отдельный набор программ, но его почти всегда можно поставить пакетом дистрибутива, а собирать самому приходится редко.
Практический вывод: не собирайте тулчейн, если для этого нет отдельной причины. Берите clang с lld и переключайте цель флагом; если нужен именно GCC — ставьте кросс-пакет. Сборка своего GCC остаётся оправданной ровно тогда, когда целевой архитектуры нет ни в LLVM, ни в пакетах.
QEMU и GDB
Отладчик ядра — это QEMU с подключённым GDB, и два флага делают почти всё: -s заставляет QEMU слушать подключение gdb на TCP-порту 1234, -S — не запускать гостя, пока об этом не скажут из отладчика. Вместе они дают то, чего на живой машине нет: остановку до первой исполненной инструкции.
Дальше начинаются особенности, специфичные именно для ранней загрузки, и обе связаны с тем, что отладчик знает про программу больше, чем сейчас верно. Первая: символы скомпонованы под адреса исполнения, а процессор до включения трансляции работает по адресам загрузки — значит все адреса из таблицы символов смещены на постоянную величину, и до переключения полезно загрузить вторую копию символов со сдвигом, а после — вернуться к обычной. Это ровно то различие LMA и VMA, о котором шла речь выше, только увиденное со стороны инструмента. Вторая: на x86-64 процессор стартует не в 64-битном режиме, и gdb об этом не догадывается — руководство QEMU советует set architecture i8086, чтобы дизассемблировать 16-битный код, и считать адрес как $cs*16+$eip. То же руководство предупреждает и о более общем случае: перемещение кода средствами вроде рандомизации базы сбивает представление отладчика о памяти, и на время отладки её проще отключить.
Ранний вывод и почему printf в ядре нетривиален
Последовательный порт — единственное, что работает всегда, и причина этого механическая: чтобы записать байт в UART, не нужно ни выделения памяти, ни прерываний, ни модели устройств — достаточно записи в один регистр и опроса другого в цикле. Всё остальное появляется позже.
Ловушка в том, что адрес этого регистра не универсален. QEMU говорит об этом прямо: у машины virt на ARM гарантированы только адреса флеш-памяти и ОЗУ, а «вся прочая информация о расположении устройств может меняться между версиями QEMU, так что гостевой код обязан смотреть в DTB»; для RISC-V сказано то же — гостевое ПО должно обнаруживать устройства из сгенерированного дерева устройств. Ответ, к которому пришли настоящие ядра, — двухступенчатый. Linux заводит отдельную раннюю консоль: earlycon без параметров определяет устройство «свойством stdout-path в узле chosen дерева устройств либо таблицей ACPI SPCR», работает в режиме опроса и позже уступает место обычному драйверу консоли. Своему ядру стоит повторить эту же лестницу: зашитый адрес, чтобы вывести первую строку и увидеть, что вы вообще исполняетесь, — затем адрес из дерева устройств, как только его есть чем разобрать.
Вывод строки в ядре нетривиален по причине, не имеющей отношения к форматированию. Функция обязана быть вызываемой из любого контекста: из обработчика прерывания, из планировщика, из кода, который уже держит какие-то замки, из обработчика отказа страницы. Значит она не имеет права ни спать, ни выделять память, ни брать замок, который может оказаться уже взятым ею же на другом уровне вложенности, — а последнее случается сплошь и рядом, потому что предупреждение, выданное внутри драйвера консоли, приведёт к повторному входу. Linux разрешает это разделением на две части: запись форматируется в кольцевой буфер, устроенный так, что «внутреннее состояние дескриптора — ключевой элемент, позволяющий читателям и писателям синхронизировать доступ к данным без блокировок», а собственно вывод на консоль отвязан от записи. Своему ядру достаточно повторить идею: путь записи не берёт замков и не выделяет память, а вывод в порт делается отдельно и с оглядкой на то, что он может быть прерван.
Ассерты и паника
Паника — код, работающий тогда, когда предположения уже нарушены, и потому единственное её требование: не зависеть ни от чего, что могло сломаться. Ни выделения памяти, ни замков, ни планировщика, ни отложенного вывода — прямая запись в порт в режиме опроса. Полезное содержимое минимально: причина, адрес, где всё случилось, содержимое регистров и проход по стеку, насколько его удастся сделать. Всё остальное — приятные излишества, которые в первой версии ядра стоят дороже, чем дают.
Проверки же полезно с самого начала разделить на два вида. Одни утверждают то, что не может нарушиться при корректном коде, — их место рядом с кодом, они дешёвые и в неотладочной сборке могут исчезать. Другие проверяют данные, пришедшие извне: из пользовательского пространства, от устройства, из таблицы прошивки. Эти обязаны оставаться в любой сборке и обязаны возвращать ошибку, а не останавливать машину, — ядро, падающее от неправильного аргумента системного вызова, приносит атакующему остановку обслуживания одной строкой.
Вердикт для своей ОС
Свести всё стоит по тому же признаку, что и в предыдущих статьях цикла: где выбор есть, а где его нет.
Выбора нет в следующем. Своими будут memcpy, memset, memmove и memcmp — компилятор их зовёт сам. Плавающей точки в ядре не будет, и запретить её компилятору придётся явно, разными флагами на трёх архитектурах. Скрипт компоновки станет частью исходников, и в нём появятся символы границ, выравнивание на страницу и различие адреса загрузки с адресом исполнения. Точки входа будут на ассемблере. Аллокатор будет ваш.
Выбор есть, и вот он вместе с рекомендациями. Модель кода: -mcmodel=kernel на x86-64, умолчание на ARM64, medany на 64-битном RISC-V — и решается это раньше всего остального, потому что задаёт диапазон адресов. Перемещаемость: сначала фиксированный адрес, перемещаемость потом, когда понадобится рандомизация. Freestanding: -ffreestanding с первого дня — не потому, что так делают все (Linux как раз не делает), а потому, что он оптом закрывает вызовы, которые компилятор придумывает по семантике libc; остальное компилятор зовёт по праву, и это ловит компоновщик. Возврат ошибки из системного вызова: отрицательный код, потому что он не требует от архитектуры ничего. Права на секции: закладывайте выравнивание сразу, включайте права в конце загрузки. Раздел инициализации: заводите вместе с проверкой ссылок в него, иначе он опаснее, чем полезен. Отображаемые процессу данные: страница с номером версии — с первого дня, отдельный ELF-объект с кодом — когда меняться обязан код, а не только данные. Тулчейн: clang с lld, если нет причины на GCC.
И один выбор, у которого два правильных ответа на два разных вопроса. Учиться механизму — на C, потому что весь корпус, с которым вы будете сверяться, написан на нём. Получить работающее ядро с меньшим числом ошибок в неинтересной части — на Rust, если цель попадает в LLVM. Пока ядро учебное, ваш вопрос первый; второй становится вашим, когда у ядра появляются пользователи. Обе рекомендации совместимы больше, чем кажется: граница модулей описывается C-ABI в любом случае, и переход подсистемы с одного языка на другой не требует переделки ни компоновки, ни точек входа.
Соседние статьи цикла по этому сюжету — карта памяти ядра, куда упирается выбранная здесь модель кода, и физическая память с задачей раскрутки, где выясняется, откуда аллокатор берёт первую страницу.
Источники
- GCC: Language Standards Supported by GCC — определения freestanding и hosted, список обязательных заголовков freestanding-реализации по редакциям стандарта (девять — накопленные к C11) и расширение набора в C23 «включая некоторые функции из других заголовков», требование предоставить
memcpy,memmove,memsetиmemcmp - GCC: Options Controlling C Dialect —
-ffreestandingподразумевает-fno-builtinи эквивалентен-fno-hosted;-fno-builtinописан как отказ распознавать библиотечные функции, то есть отключение преобразований по их семантике - GCC 15 Release Series — Changes, New Features, and Fixes — умолчание для C переведено с
-std=gnu17на-std=gnu23 - GCC: Options That Control Optimization —
-ftree-loop-distribute-patternsпревращает цикл инициализации в вызовmemsetи включён на-O2 - GCC: x86 Options —
-mcmodel=small/kernel/medium/large,-mno-red-zoneи определение красной зоны,-mgeneral-regs-only - GCC: x86 Function Attributes — атрибут
interrupt, сохранение всех регистров и возврат черезIRET, требование-mgeneral-regs-onlyи предупреждение про красную зону при прерывании без переключения стека - GCC: AArch64 Options — модели кода
tiny/small/large,-mgeneral-regs-only,-moutline-atomicsи вспомогательные функции LSE,-mstack-protector-guard=sysregс оговоркой «целиком для использования внутри ядра Linux» - GCC: RISC-V Options —
-mcmodel=medlow/medany/large,-mabi,-msave-restore,-mrelax,-mstrict-align - Clang: Cross-compilation using Clang — «Clang/LLVM изначально является кросс-компилятором», опция
-targetи что всё равно приходится искать снаружи - System V Application Binary Interface — AMD64 Architecture Processor Supplement — таблица регистров и кто их сохраняет, 128-байтная красная зона, ограничение на 32-битные знаковые непосредственные и определения моделей кода, включая kernel («ядро <…> исполняется в отрицательной половине адресного пространства»)
- Procedure Call Standard for the Arm 64-bit Architecture (AAPCS64) — роли регистров, выравнивание стека и запрет обращаться к неактивной области стека
- RISC-V ELF psABI: Calling Conventions — таблица регистров, запрет полагаться на данные ниже указателя стека
- GNU ld: Basic Linker Script Concepts и Output Section LMA — определения VMA и LMA,
AT()иAT>, правила выбора LMA по умолчанию - The RISC-V Code Models (2026 Edition): medlow, medany, & large — SiFive — какие последовательности инструкций порождает каждая модель и откуда берётся окно в 2 ГиБ
- Floating-point API — документация ядра Linux — почему плавающая точка запрещена, зачем изолировать FP-код в отдельную единицу трансляции, ограничения
kernel_fpu_begin() - earlycon — Documentation/admin-guide/kernel-parameters.txt — ранняя консоль по
stdout-pathв дереве устройств либо по таблице ACPI SPCR - Kernel Address Sanitizer (KASAN) и Sparse — документация ядра Linux: KASAN как динамический детектор выходов за границу и обращений к освобождённому, накладные расходы отладочного режима;
sparseкак семантический анализатор, встраиваемый в сборку черезmake C=1 - Исходники ядра Linux:
Makefile—-nostdinc,-fno-builtin-wcslen,--emit-relocs --discard-none,--orphan-handling,--pack-dyn-relocs=relr,-Cpanic=abortиRUSTC_BOOTSTRAP := 1;arch/x86/Makefile—REALMODE_CFLAGSс-ffreestanding, полный список запретов расширений (-mno-sse -mno-mmx -mno-sse2 -mno-3dnow -mno-avx -mno-sse4a, отдельно-mno-80387и-mno-fp-ret-in-387),-mno-red-zone,-mcmodel=kernel, одиночный-fno-asynchronous-unwind-tables,-z max-page-size=0x200000,--target=scripts/target.json;arch/arm64/Makefile—-mgeneral-regs-only,-ffixed-x18под теневой стек приCONFIG_SHADOW_CALL_STACK, пара-fno-asynchronous-unwind-tables -fno-unwind-tablesс комментарием про.eh_frame,-shared -Bsymbolic -z notextприCONFIG_RELOCATABLE;arch/riscv/Makefileиarch/riscv/Kconfig—-mabi=lp64,-mno-save-restore, выбор модели кода по умолчанию (medlowдля 32 бит,medanyдля 64) и сборка модулей сmedany;scripts/mod/modpost.c— проверка ссылок в.init.*;arch/x86/kernel/vmlinux.lds.S—AT(ADDR(.text) - LOAD_OFFSET), символы границ, выравнивание.rodataна большую страницу, порядок.data→ раздел инициализации между__init_beginи__init_end→.bss;init/main.c— порядокfree_initmem()→mark_readonly()→pti_finalize();arch/Kconfig—STRICT_KERNEL_RWX;arch/arm64/Kconfig—RELOCATABLEи проход перемещений при каждой загрузке;arch/arm64/kernel/module.c— переходники дляADRи элементы PLT;arch/x86/entry/entry_64.S— что делаетSYSCALLсrcxиr11и почему четвёртый аргумент вr10;include/linux/err.h—MAX_ERRNOравный 4095;kernel/printk/printk_ringbuffer.c— кольцевой буфер без блокировок;arch/riscv/include/asm/current.h—currentкак глобальная регистровая переменная вtp;arch/arm64/include/asm/percpu.h— смещение данных процессора вTPIDR_EL1;scripts/generate_rust_target.rs— arm64 и riscv64 берут встроенные цели rustc, x86_64 требует своей - Rust in the kernel — документация ядра Linux: general-information — компоновка только с
coreи#![no_std]; arch-support — список архитектур, riscv только riscv64 и только LLVM; coding-guidelines —// SAFETY:перед каждым блокомunsafeи раздел# Safetyкак контракт - Documentation/process/changes.rst — минимальные версии rustc 1.85.0 и bindgen 0.71.1
Documentation/rust/index.rstв v6.19 иdrivers/android/Kconfig— раздел «The Rust experiment», исчезнувший в v7.0, иCONFIG_ANDROID_BINDER_IPC_RUST, появившийся в v6.18- The (successful) end of the kernel Rust experiment — LWN.net — дата решения и формулировка «Rust в ядре больше не эксперимент»
- The state of the kernel Rust experiment — LWN.net — отчёт со встречи сопровождающих: заявление про DRM «примерно через год» и оговорка про зависимости основного кода ядра «ещё год или два»
- Rust: platform support — уровни поддержки целей без ОС и что гарантирует tier 2
- Rust Reference: Type layout — отсутствие гарантий раскладки у представления по умолчанию и «раскладка типа может меняться с каждой компиляцией»
- The Rustonomicon:
#[panic_handler]— обработчик паники вno_std - Zig: In-depth Overview — отсутствие скрытых выделений памяти, аллокатор как параметр, применимость стандартной библиотеки на freestanding, кросс-компиляция и
zig cc - Zig 0.16.0 Release Notes и объявление о выпуске — состав изменений и дата 14 апреля 2026 года; текущие версии — в индексе загрузок
- Zig Bare Bones — OSDev Wiki — минимальное ядро на Zig как жанр учебного проекта
- Исходники FreeBSD:
sys/conf/kern.mk—-ffreestandingс обоснованием,-mcmodel=kernel -mno-red-zoneна amd64,-mgeneral-regs-onlyи-ffixed-x18на arm64, разъяснение проmediumв clang противmedanyв GCC;lib/libsys/amd64/SYS.h,lib/libsys/aarch64/SYS.h,lib/libsys/riscv/SYS.h— обёртки системных вызовов и признак ошибки;sys/riscv/riscv/vm_machdep.c—cpu_set_syscall_retval(), выставляющийt0в 0 или 1;sys/sys/vdso.h—struct vdso_timehandsс версией и кодом алгоритма syscall(2)— Linux manual page — таблицы соглашений системного вызова по архитектурам- glibc,
sysdeps/unix/sysv/linux/x86_64/sysdep.h— граница-4095и комментарий о том, откуда взялось обещание не возвращать значения из этого диапазона, а такжеmovq %rcx, %r10в макросеDOARGS_4 vdso(7)— Linux manual page — назначение vDSO,AT_SYSINFO_EHDR, набор символов и «стандартные соглашения о вызовах C»- QEMU: GDB usage —
-sи-S, отладка 16-битного кода, предупреждение про перемещение кода - QEMU:
virtgeneric virtual platform (ARM) иvirt(RISC-V) — PL011 и NS16550, нестабильность карты устройств и требование читать DTB
Связанные заметки
- Адресное пространство: зачем трансляция и какие есть альтернативы — откуда берутся FS/GS,
TPIDR_EL1иtp, которыми в ядре заменяют локальную память потока - Страничная трансляция: таблицы, TLB, разрядность — права в записи таблицы, из-за которых границы секций в скрипте компоновки выравниваются на страницу
- Карта памяти ядра: половины, прямое отображение, KASLR — куда именно попадает образ, чью раскладку задаёт выбранная здесь модель кода, и что требуется от перемещаемого ядра
- Стеки: ядра, прерываний, пользовательские — продолжение сюжета про красную зону и про то, на каком стеке оказывается код после ассемблерной точки входа
- Устройство ОС — план цикла статей — состав и порядок цикла; загрузка, физическая память и вход в ядро разбираются отдельными статьями
- Linux — ядро: сборка, модули, параметры — то же ядро со стороны администратора: конфигурация, сборка пакетом, загрузка модулей
- TLPI — база знаний — ABI системного вызова с другой стороны границы, глазами прикладного программиста
- Методика изучения Go-библиотек — приёмы разбора чужого кода; выбор языка ядра во многом и есть выбор корпуса, который придётся так читать
- Вход в ядро и переключение контекста — седьмая статья цикла: что происходит по ту сторону соглашения о системном вызове и почему в ядре нет плавающей точки
- Физическая память: от карты firmware до аллокатора — пятая статья цикла: первый потребитель этого скрипта компоновки — ранние таблицы страниц, зарезервированные в образе, и первый жилец раздела инициализации
- Загрузка: от питания до первой инструкции ядра — шестая статья цикла: момент, в котором ранний код перестаёт пользоваться адресами загрузки и переходит на адреса исполнения
- Структура ядра: монолит, микроядро и что между — девятая статья цикла: безопасный язык как вторая ось изоляции, независимая от структуры ядра
Из библиотеки института уносят только знания. Читателей здесь не считают: посещение не регистрируется, отметок в издании не остаётся, счётчиков нет ни у одного издания фонда.
Издание пополняется и пересверяется. Текст доступен на условиях CC BY-SA 4.0 — унесённое можно передавать дальше на тех же условиях.