Где живёт приостановленное вычисление
Стек в этой статье — не структура данных из учебника, а ответ на вопрос, где хранится состояние вычисления, которое сейчас не исполняется. У функции это кадр: сохранённые регистры, локальные переменные, адрес возврата. У потока, уснувшего посреди системного вызова, — вся цепочка таких кадров разом, вместе с тем, что каждый уровень успел захватить и обязан отпустить. Пока вычисление одно, вопрос не стоит. Как только их много, «сколько в системе стеков и кому они принадлежат» перестаёт быть деталью реализации и становится тем, что определяет, где код имеет право заблокироваться, а где обязан довести дело до конца.
Решений здесь два, и оба принимаются один раз. Первое — сколько у ядра стеков: свой на каждый поток или один на процессор. Ядро с собственным стеком у каждого потока может уснуть в любой точке, потому что состояние операции остаётся лежать на стеке спящего. Ядро с единственным стеком на процессор уснуть не может нигде: стек общий, и всякая операция, которая могла бы заблокироваться, обязана превратиться в явный конечный автомат. Переделать это потом — значит переписать ядро.
Второе решение выглядит техническим, но следует из первого и связывает всю остальную статью: стек ядра нельзя вырастить по требованию, потому что обработчик отказа страницы исполняется на стеке, которого не хватило. Это не сложность реализации, а замкнутый круг, и из него растёт всё остальное — фиксированный размер, сторожевые страницы, отдельные стеки для исключений, запрет рекурсии и больших локальных массивов, сборка ядра без красной зоны.
Механизм отказа страницы, права в записи таблицы и цена инвалидации разобраны во второй статье цикла, а зачем вообще нужна трансляция — в первой; здесь они берутся как готовые. Переключение на стек ядра при входе в него — предмет отдельной статьи цикла про вход в ядро, и здесь оно упоминается ровно настолько, насколько нужно, чтобы объяснить сами стеки.
Развилка: модель процесса против модели прерывания
Что именно лежит на стеке ядра
Поток, вошедший в ядро и добравшийся до ожидания ввода-вывода, находится где-то в середине цепочки вызовов: файловая система вызвала блочный слой, тот — драйвер, драйвер отправил запрос и ждёт. Всё, что описывает эту позицию, лежит на стеке ядра: адреса возврата, локальные переменные каждого уровня, указатели на структуры, взятые в работу. Формулировка авторов Fluke точна: каждый поток «сохраняет состояние своего стека ядра, даже когда спит, и потому имеет неявный „контекст исполнения“, описывающий, какую операцию он сейчас выполняет».
Слово «неявный» здесь ключевое. Состояние есть, но оно не представлено ни одной структурой данных — оно размазано по кадрам, и прочитать его извне нельзя. Ровно поэтому его нельзя ни сериализовать, ни передать другому процессору, ни отменить снаружи, и ровно поэтому стек спящего потока нельзя освободить.
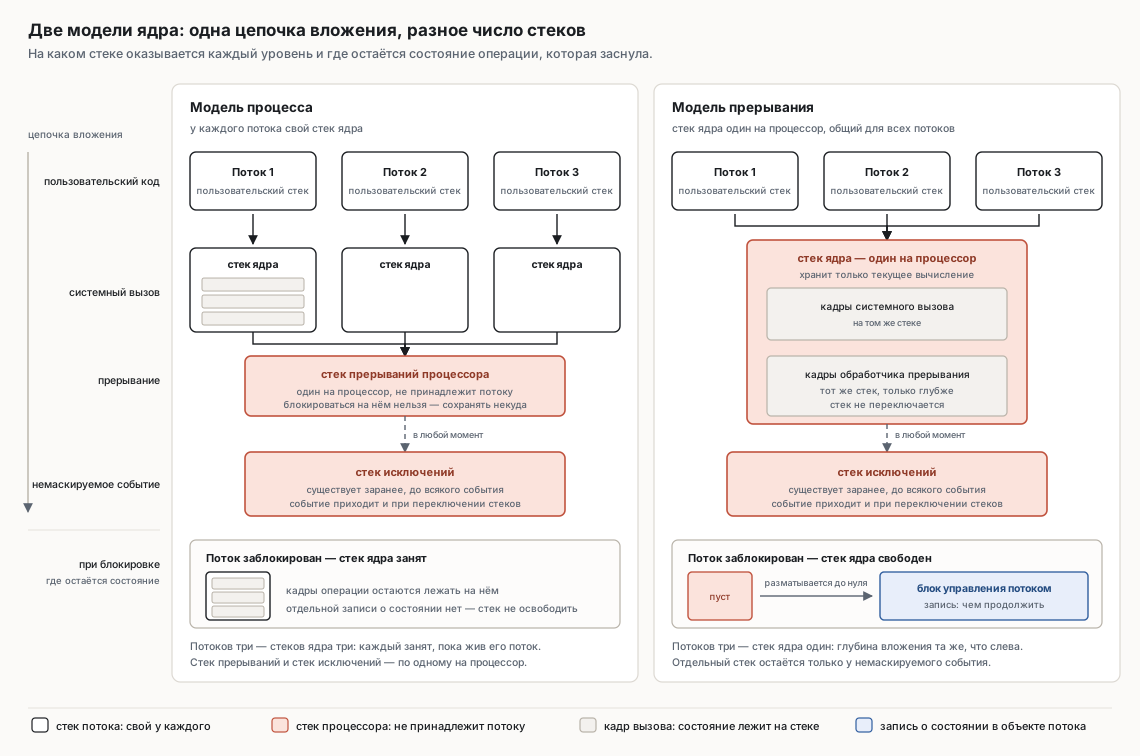
Модель процесса
Так устроены Linux, FreeBSD и почти всё, что выросло из Unix. У каждого потока — свой стек ядра; вход в ядро переключает на него, выход возвращает обратно. Блокирующая операция пишется как обычный последовательный код:
/* модель процесса: состояние операции — в локальных переменных и кадрах */
ssize_t read_block(struct file *f, void *buf, size_t n)
{
    struct bio *bio = submit_read(f, buf, n);
    wait_for_completion(&bio->done);   /* поток засыпает прямо здесь */
    return bio->result;
}
Цена — память на поток и то, что она не возвращается, пока поток жив. При 16 КиБ на стек десять тысяч потоков стоят 160 МиБ, которые заняты даже когда все они спят. Вторая, менее очевидная цена — невозможность посмотреть на операцию снаружи: чтобы её прервать, нужно, чтобы код сам дошёл до точки, где он проверяет сигналы.
Модель прерывания
Второй ответ: один стек ядра на процессор. Так работали V и экзоядра, так работает seL4. Стек хранит состояние только текущего вычисления; переключение потоков — это разматывание стека до нуля и старт с чистого. Тогда всё, что нужно сохранить, приходится выписать явно:
/* модель прерывания: то же состояние вынесено в объект потока */
void read_block(struct tcb *t, struct file *f, void *buf, size_t n)
{
    t->io = submit_read(f, buf, n);
    t->cont = read_block_done;   /* чем продолжить, когда придёт ответ */
    yield();                     /* стек разматывается до нуля */
}

static void read_block_done(struct tcb *t) { t->retval = t->io->result; }
Такая запись называется продолжением (continuation), и первым её массово применил Mach: переработка управления потоками и IPC под продолжения сократила расход памяти на поток на 85 %, ускорив заодно межадресный RPC на 14 %, а обработку исключений — более чем на 60 %.
seL4 идёт дальше и обходится без явных структур-продолжений, заменив их перезапуском. Ядро исполняется с запрещёнными прерываниями — авторы прямо пишут, что «в терминах задержек прерывания выиграть от вытесняемой конструкции удалось бы немного, а цена в терминах сложности была бы очень высокой», — и потому системный вызов обязан быть коротким. Длинные операции, прежде всего отзыв капабилити, разбиты на короткие подоперации, каждая из которых переводит ядро из одного согласованного состояния в другое; при наличии ожидающего прерывания операция прерывается и перезапускается. Свойство, на котором это держится, авторы называют инкрементальной согласованностью, а место, где ядро опрашивает прерывания, — точкой вытеснения. С точки зрения стека разница принципиальная: не нужно сохранять ничего, потому что состояние всегда либо целиком в объектах ядра, либо ещё не начато.
Что показал контролируемый эксперимент
Спор о моделях долго шёл на аргументах, пока в 1999 году группа Flux не сделала единственно правильную вещь: ядро Fluke собиралось в обеих моделях из одного исходника, и разница между сборками составляла около двухсот инструкций на ассемблере в коде входа и выхода плюс полсотни строк на C. Результаты стоит держать в голове целиком, потому что они переворачивают половину ожиданий.
Память действительно экономится, но меньше, чем принято думать: накладные расходы на управление потоком в измерениях того времени составили 8832 байта во FreeBSD и 6491 в Linux против 300 байт у Fluke в модели прерывания, — однако сам Fluke в модели процесса укладывался в 1024 байта. Оговорка, на которой этот вывод держится, стоит в той же таблице: килобайта хватало только в производственной сборке, из которой выкинуты отладочные средства, и только пока на этих стеках не исполнялись драйверы — заимствованные драйверы Fluke требовали четырёх килобайт, и вторая строка модели процесса в таблице именно такая. С этой оговоркой авторы и заключают, что «по крайней мере на архитектуре x86, пока накладные расходы на управление потоком составляют около килобайта на поток или меньше, между двумя моделями, судя по всему, нет большой разницы при умеренном числе потоков». То есть выигрывает не модель, а дисциплина — причём дисциплина всего кода, который окажется на стеке: ядро, не кладущее на стек лишнего, получает почти ту же экономию, оставаясь в модели процесса, а один чужой драйвер её съедает.
Производительность оказалась почти неразличимой: из трёх тестов модель прерывания выиграла один (0,94 от базы на нагрузке из системных вызовов и переключений контекста), сравнялась на втором и на 3 % проиграла на третьем.
С задержкой вытеснения надо быть аккуратным, потому что вдоль неё меряли не модель. Конфигураций было пять: обе модели без вытеснения, обе с одной явной точкой вытеснения на пути копирования данных IPC и модель процесса с полным вытеснением — строки «модель прерывания, полностью вытесняемая» в таблице нет вовсе, потому что полное вытеснение требует уметь заблокироваться внутри ядра. Одинаково собранные модели дают почти одинаковый результат: без вытеснения максимум 7430 микросекунд против 7356, с точкой вытеснения — 1200 против 1272. Единственная конфигурация без пары — полностью вытесняемая модель процесса, и она отстоит от невытесняемых почти на три порядка: максимум 19,6 микросекунды, средняя 5,14 против 28,9 — почти в шесть раз меньше. Авторы говорят это прямым текстом: «полная вытесняемость обходится не даром, но эта цена связана с вытесняемостью, а не с самой моделью процесса», — и в сводке добавляют, что по задержке вытеснения «ядро модели прерывания способно работать не хуже равнозначно сконфигурированного ядра модели процесса, но самую низкую задержку даёт полностью вытесняемое ядро модели процесса». Ось здесь — вытесняемость, а модель важна ровно постольку, поскольку до полной вытесняемости достаёт только модель процесса.
Вывод авторов заслуживает буквальной цитаты, потому что он не тот, которого ждёшь: «для внутренней модели исполнения ядра любая из моделей реализации разумна», а по-настоящему важен атомарный API — такой, где нет состояний потока, невидимых пользовательскому коду.
Чем помогает и мешает архитектура
Здесь три архитектуры цикла расходятся, и расхождение это то же самое, что объясняет полстатьи дальше. Вопрос простой: пишет ли процессор что-нибудь в память при входе в ядро.
x86-64 пишет. При переходе на более привилегированный уровень процессор сам загружает новый указатель стека — из поля TSS, а для отмеченных векторов из таблицы стеков прерываний, — и укладывает на него SS, RSP, RFLAGS, CS и RIP, а при наличии кода ошибки ещё и его. Процессор, таким образом, встроенно предполагает, что стек ядра принадлежит текущему потоку. Fluke называет это смещением архитектуры в пользу модели процесса и измеряет его: перекладывание сохранённого состояния со стека в структуру потока и обратно стоило около шести тактов на Pentium при 70 тактах минимальной цены самого перехода в супервизорный режим.
Шесть тактов — цена конкретного приёма, а не смещения вообще: столько стоит перекладывание состояния в модели прерывания. Повседневная работа, которую смещение навязывает, другая — указатель стека процессор берёт из поля RSP0, а TSS один на процессор, поэтому ядро, у которого стек свой у каждого потока, обязано переписывать это поле при каждом переключении контекста; иначе следующее прерывание уложит кадр на стек предыдущего потока. Об это спотыкаются первым делом, когда пишут своё ядро: всё работает, пока поток один. Linux, впрочем, платит иначе — sp0 у него постоянно указывает на входной стек процессора, а вершина стека текущего потока лежит в переменной на процессор, которую и переписывает __switch_to().
ARM64 и RISC-V в память не пишут ничего. ARM64 при исключении складывает адрес возврата в ELR_ELx, состояние — в SPSR_ELx и переключает выбор указателя стека: архитектура определяет, что «когда происходит исключение, выбирается указатель стека целевого уровня исключения», а выбор между SP_EL0 и SP_ELx задаётся битом SPSel.SP. Суффиксы в именах векторов ровно об этом: t (thread) означает SP_EL0, h (handler) — SP_ELx. RISC-V складывает sepc, scause, stval и биты sstatus — и всё. Указатель стека ядра обе архитектуры оставляют программе: ARM64 отдаёт под него банкированный SP_EL1, RISC-V — регистр-царапину sscratch, «обычно используемый для хранения указателя на локальный для харта супервизорный контекст, пока харт исполняет пользовательский код», который меняют местами с рабочим регистром одной инструкцией csrrw.
Практический вывод: на ARM64 и RISC-V обе модели пишутся одинаково легко, на x86-64 модель прерывания требует лишней возни, но не лишней производительности.
Гибриды и вердикт
Чистых моделей в проде почти нет. Mach перешёл к частичной модели прерывания, добавив продолжения в ключевых местах и оставив стеки везде, где переписывать было дорого. Linux и FreeBSD, будучи ядрами модели процесса, применяют модель прерывания локально: обработчик аппаратного прерывания исполняется на стеке, который не принадлежит никакому потоку, и потому обязан довести дело до конца. Об этом — отдельный раздел ниже; здесь важно, что модель прерывания — не экзотика, а режим, в который любое ядро входит на несколько микросекунд десятки тысяч раз в секунду.
Вердикт для своей ОС: начинайте с модели процесса. Не потому, что она лучше — эксперимент Fluke показал, что по производительности и памяти разница на современных масштабах в шуме, — а потому, что она позволяет писать блокирующий код последовательно и заимствовать чужой. Раздел про заимствования Fluke открывает тем, что использовать в ядре модели прерывания драйвер, файловую систему или сетевой стек, написанные для модели процесса, «представляется невозможным», — и тут же эту оценку снимает, перечисляя работающие подходы: чужой код запускают на потоках ядра (так делает Minix) либо на частичной модели прерывания, где стек удерживается на время исполнения такого кода (так делает Mach с продолжениями); сам Fluke исполняет его в непривилегированном режиме, но в адресном пространстве ядра. Итог авторов поэтому мягче исходной формулировки: «проще всего использовать этот унаследованный код в ядрах модели процесса», а в ядре модели прерывания он тоже работает — «с небольшой потерей производительности». Для учебного ядра, которое будет расти за счёт заимствований, решает именно «проще»: каждый из обходных путей — это подсистема, которую придётся написать и отладить прежде, чем заработает первый чужой драйвер.
Модель прерывания выбирают, когда есть одна из трёх причин. Верификация: доказать свойства ядра без параллелизма и без неявного состояния на стеках несоизмеримо проще, и seL4 существует благодаря этому выбору. Жёсткий реальный масштаб памяти: сотни тысяч потоков при десятке килобайт на каждый. Ограниченная сверху глубина стека: разматывание до нуля не даёт цепочке вызовов накапливаться, и максимум известен заранее — но это свойство про память и про проверяемость границ, а не про задержку, по которой, как показал тот же эксперимент, преимущество у противоположной стороны. Если ни одна из трёх не про вас, платить стилем кода не за что. Но знать, что выбор был сделан, обязательно: он не переигрывается.
Почему стек ядра нельзя вырастить
Замкнутый круг
Пользовательский стек растёт по требованию: программа обращается за границу отображённой области, ядро ловит отказ страницы, подставляет страницу и возвращает управление. Со стеком ядра тот же приём не работает, и причина видна, если проследить, на чём исполняется обработчик.
На x86-64 круг замыкается аппаратно и виден в комментарии обработчика двойного отказа в ядре Linux: «если мы переполняем стек в сторожевую страницу, процессор не сможет доставить #PF и пришлёт вместо него #DF». Отказу страницы отдельный стек не назначен, поэтому при исключении внутри ядра процессор стек не меняет — он укладывает кадр на текущий, — и укладка сама попадает в неотображённую страницу. Второй отказ поверх доставки первого спецификация классифицирует как двойной отказ, а третий, поверх доставки двойного, переводит процессор в состояние остановки, из которого выводит только сброс.
На ARM64 и RISC-V процессор в память не пишет, поэтому первая инструкция обработчика исполнится. Но обработчику нужен стек, а единственный, который у него есть, — тот, что только что кончился. Круг тот же, просто замыкается на одну инструкцию позже.
Разорвать его можно только одним способом: обработчик обязан исполняться на другом, заранее существующем стеке. Это и есть механизм стеков исключений, разобранный ниже. Но даже получив такой стек, растить стек ядра по отказу не стала ни одна из четырёх систем, разбираемых в этой статье (Windows и коммерческие RTOS здесь не проверялись), и на то есть три независимые причины. Обработчику пришлось бы выделять память в контексте, где выделение может заблокироваться, — а заблокироваться в обработчике отказа стека негде. Выделение вызывалось бы в том числе из обработчика прерывания и из немаскируемого прерывания, где блокироваться нельзя вовсе. И новая страница обязана стать видимой всем процессорам синхронно, что превращает рост стека в рассылку инвалидаций. Дешевле выделить стек целиком при создании потока.
Асимметрия здесь и есть ответ на вопрос, почему пользовательский стек растёт, а стек ядра нет: отказ на пользовательском стеке обрабатывается на другом стеке — на стеке ядра. У стека ядра такого «другого» нет, кроме специально заведённого заранее.
Сколько это в байтах
Размеры на сентябрь 2026 года, по заголовкам, а не по документации:
| Система | Стек потока в ядре | Сторожевая страница | Стек прерываний |
|---|---|---|---|
| Linux, x86-64 | 16 КиБ (PAGE_SIZE << 2) |
есть при VMAP_STACK |
16 КиБ на процессор |
| Linux, ARM64 | 16 КиБ, но не меньше страницы | есть при VMAP_STACK |
равен стеку потока |
| Linux, RISC-V | 16 КиБ (CONFIG_THREAD_SIZE_ORDER=2) |
есть при VMAP_STACK |
равен стеку потока |
| FreeBSD, amd64/arm64/riscv | 16 КиБ (KSTACK_PAGES 4) |
есть всегда (KSTACK_GUARD_PAGES 1) |
отдельного нет, см. ниже |
| xv6-riscv | 4 КиБ (одна страница) | есть, по странице с обеих сторон | отдельного нет |
Историческая динамика поучительна. На x86-64 Linux жил на 8 КиБ большую часть своей жизни и перешёл на 16 КиБ только в 3.15, причём переход был спорным: до появления виртуально отображаемых стеков 16 КиБ означали физически непрерывное выделение второго порядка — четыре подряд идущие страницы, — то есть давление на аллокатор и уязвимость к фрагментации. Формулировка Торвальдса в том обсуждении — «8-килобайтный стек был довольно тесен и болезнен уже некоторое время, и я готов признать, что это стало просто слишком чертовски болезненно». Под KASAN все три архитектуры удваивают размер: инструментация занимает стек.
Заметьте, что цифра одна и та же — 16 КиБ — у двух независимых систем на трёх архитектурах каждая. Объяснять это приходится рассуждением, а не источником: похоже, что 16 КиБ — то, во что упирается глубина реальной цепочки вызовов ядра, помноженная на нежелание платить за каждый спящий поток. Против «традиции» говорит хотя бы то, что пришли к ней разными путями: Linux — переходом под давлением конкретных отчётов о переполнении, FreeBSD — константой KSTACK_PAGES 4, то есть числом страниц, а не байт. Для своего ядра 16 КиБ — разумная отправная точка, а 4 КиБ, как в xv6, хватает ровно до появления файловой системы поверх драйвера поверх слоя блочных устройств.
Сторожевая страница и виртуально отображённые стеки
Переполнение без сторожевой страницы — это тихая запись в чужую память под стеком, и разбирать её приходится по последствиям через часы работы. Документация ядра формулирует задачу прямо: виртуально отображённые стеки со сторожевыми страницами «приводят к тому, что переполнение стека ядра ловится немедленно, вместо того чтобы вызывать трудно диагностируемые повреждения».
Механизм простой: стек выделяется не как непрерывный кусок физической памяти, а как набор страниц, отображённых подряд в области vmalloc, с неотображённой страницей по краям. Побочный выигрыш — физическая непрерывность больше не нужна, и давление на аллокатор, из-за которого спорили о переходе на 16 КиБ, исчезает. Побочная плата — отображение постранично, а не блоком, то есть дополнительное давление на TLB, и запрет, о котором легко забыть: «когда VMAP_STACK включён, невозможно выполнять DMA над данными, размещёнными на стеке», потому что виртуально непрерывный буфер не обязан быть непрерывным физически.
В Linux VMAP_STACK появился на x86-64 в 4.9, на arm64 — в 4.14, почти ровно годом позже: именно в этих выпусках в Kconfig соответствующих архитектур впервые появляется HAVE_ARCH_VMAP_STACK. Сегодня опция включена по умолчанию везде, где поддерживается архитектурой, с одним исключением: при программных режимах KASAN она недоступна, пока не включён KASAN_VMALLOC, — теневая память должна уметь покрывать виртуальные отображения. Во FreeBSD сторожевая страница у стека ядра — не опция, а часть механизма выделения: стек берётся из виртуального адресного пространства ядра вместе с лишней страницей, которая затем снимается с отображения. Для своего ядра это стоит скопировать сразу: сторожевая страница стоит одной записи таблицы на поток и превращает самый неприятный класс ошибок в понятную панику.
Как переполнение обнаруживается на трёх архитектурах
Дальше начинается прямое следствие того, кто пишет в память при входе в ядро.
На x86-64 переполнение обнаруживает железо, и обнаруживает как двойной отказ: попытка уложить кадр исключения в сторожевую страницу не удаётся, #PF доставить невозможно, приходит #DF. Обработчик #DF исполняется на своём стеке (иначе бы и он не запустился), читает адрес отказа из CR2 и, если тот попадает в сторожевую страницу известного стека, печатает BUG: ... stack guard page was hit вместо бессмысленного «двойной отказ». Документация ядра называет это прямо: «на x86 это делается обработкой отказа страницы, свидетельствующего о переполнении стека ядра, на стеке двойного отказа».
На ARM64 и RISC-V железо не пишет, поэтому проверять приходится программно — и обе архитектуры делают это одинаковым трюком. Стеки выравниваются не по своему размеру, а по удвоенному (THREAD_ALIGN = 2 * THREAD_SIZE), после чего бит номер THREAD_SHIFT в корректном указателе стека всегда нулевой, а после выхода за нижнюю границу — единичный. Проверка занимает три инструкции и не требует ни одного обращения к памяти. На RISC-V она выглядит так:
addi sp, sp, -(PT_SIZE_ON_STACK)   # место под кадр, которое сейчас понадобится
srli sp, sp, THREAD_SHIFT
andi sp, sp, 0x1                   # вылезли за границу выровненного стека?
bnez sp, handle_kernel_stack_overflow
REG_L sp, TASK_TI_KERNEL_SP(tp)    # не вылезли — вернуть sp, сохранённый до проверки
Дальше обе системы переключаются на свой стек переполнения — по 4 КиБ на процессор, ровно чтобы напечатать регистры и упасть в панику с внятным сообщением. На ARM64 та же проверка встроена в макрос векторов и написана хитрее, потому что не имеет права испортить ни один регистр общего назначения до того, как они сохранены.
Отсюда практический вывод для своего ядра: выравнивание стеков по удвоенному размеру ничего не стоит в момент выделения и даёт трёхинструкционную проверку переполнения на входе. Делать это надо сразу — приделывать потом придётся ко всем путям входа одновременно.
Стеки исключений
Событие, которое может прийти в любой момент, включая момент переключения стеков, обязано иметь свой стек. На x86-64 для этого существует таблица стеков прерываний (IST) — до семи указателей в TSS, выбираемых трёхбитным полем в дескрипторе шлюза. TSS свой у каждого процессора, поэтому и стеки эти свои на процессор: документация ядра так и пишет — «может быть до семи входов IST на процессор». Ключевое слово в спецификации — «безусловно»: механизм «безусловно переключает стеки, когда включён», независимо от того, менялся ли уровень привилегий. Мотивация названа там же: дать определённым прерываниям — NMI, двойному отказу, машинной проверке — «всегда исполняться на заведомо исправном стеке».
Linux занимает пять из семи входов: двойной отказ, NMI, отладочные исключения, машинная проверка и коммуникационное исключение виртуальной машины. Размер каждого — 8 КиБ, хотя документация ядра до сих пор называет одну страницу: это тот случай, когда заголовок и текст разошлись, и верить надо заголовку.
У IST есть свойство, которое стоит целого раздела в коде входа: на вложенность одного и того же вектора эти стеки не рассчитаны. События с разными кодами IST вкладываются свободно — отладочное исключение спокойно прерывается NMI, стеки у них разные. Для одного и того же кода документация допускает вложение «в теории», раз обработчик правит указатели IST на входе и выходе, но тут же оговаривается: «в большинстве случаев размер стека, выделенный под IST, не предполагает вложенности для того же кода. Если это допущение будет нарушено, стеки окажутся испорчены» — второе событие начнёт писать с той же вершины и затрёт кадр первого. Про сам механизм документация говорит жёстче — «аппаратные стеки IST не могут вкладываться без гонок», — и потому на стек обычных прерываний Linux переключается программно, по счётчику вложенности, а не через IST. Комментарий у точки входа NMI объясняет, откуда вложенность вообще берётся: точка останова внутри обработчика NMI выполняет iret, а iret выводит процессор из состояния NMI, после чего следующий NMI придёт на тот же стек. Linux решает это в коде входа: обработчик проверяет флаг на стеке и, узнав себя вложенным, не исполняется, а помечает, что после выхода первого NMI надо повторить. Отладочные исключения решают ту же задачу иначе — двумя экземплярами стека, где вложенный переключает указатель на дыру, чтобы тройное вложение упало сразу.
ARM64 и RISC-V отдельного аппаратного механизма не имеют и не нуждаются в нём: раз железо в память не пишет, обработчик волен выбрать стек сам, до первой записи. ARM64 даёт для этого банкированный указатель SP_EL1, автоматически выбираемый при входе в EL1; освободившийся SP_EL0 Linux использует не по назначению — там лежит указатель на task_struct текущего потока, то есть current читается одной инструкцией mrs. RISC-V даёт sscratch, в котором Linux держит указатель потока, пока исполняется пользовательский код, и ноль, пока исполняется ядро: одна инструкция обмена одновременно достаёт рабочий регистр и отвечает на вопрос, откуда пришли.
Как ловят глубину заранее
Раз стек фиксирован, его расход надо считать, а не надеяться. Инструментов три, и они дополняют друг друга.
Компилятор считает кадр каждой функции: -fstack-usage кладёт рядом с объектным файлом .su с четырьмя полями на функцию, где третье — число байт, а четвёртое говорит, статичен ли расход. Квалификатор dynamic без bounded означает, что размер кадра не ограничен на этапе компиляции, — в ядре это красный флаг. Практичнее его младший брат -Wframe-larger-than=, который ядро включает всегда: порог задаётся конфигурацией и по умолчанию равен 2048 байтам на 64-битных архитектурах и 1280 на 32-битных.
Готовый образ считает scripts/checkstack.pl: разбирает вывод objdump и выдаёт список функций по убыванию расхода стека.
make checkstack                      # список «стековых обжор» по vmlinux
gcc -fstack-usage -c driver.c && cat driver.su
И третий инструмент — запреты. Массивы переменной длины из ядра Linux вычищены к 4.20 и с тех пор запрещены сборкой: в файле предупреждений стоит -Wvla-larger-than=1 с комментарием «стековые массивы переменной длины (VLA) не должны использоваться в ядре». Причина не эстетическая: размер такого массива приходит из данных, то есть глубина стека становится функцией входа, а вход бывает и от недоверенной стороны. По той же причине в ядре нет рекурсии по данным, а -fconserve-stack в общих флагах сборки просит компилятор не раздувать кадры ради встраивания.
Ни один из трёх инструментов не считает глубину цепочки вызовов целиком — это неразрешимо в общем виде при косвенных вызовах, которых в ядре большинство. Отсюда и берётся сторожевая страница: она нужна именно потому, что статический анализ до конца не доводит.
Стеки прерываний
Прерывание приходит в произвольный момент и в произвольный поток. Обработчику нужен стек, и вариантов два: занять стек прерванного потока или иметь свой на процессор.
Заимствование проще — переключать нечего. Но глубина тогда складывается: стек потока обязан вмещать самую глубокую цепочку ядра плюс самую глубокую цепочку обработчика, и растить его придётся у всех потоков сразу. Собственный стек на процессор снимает сложение и стоит одного переключения на входе. Именно этот довод документация ядра приводит дословно: отдельный стек прерываний «даёт больше места для обработки прерываний в ядре, не требуя увеличивать размер каждого потокового стека».
Дальше вопрос, насколько глубоко прерывания вкладываются. Если обработчик исполняется с разрешёнными прерываниями, второе прерывание ляжет поверх первого, и глубина ограничена только числом источников — на многих системах это верный путь к переполнению. Linux закрыл вопрос радикально: с 2.6.35 все обработчики исполняются с запрещёнными прерываниями, флаг IRQF_DISABLED, деливший их на «быстрые» и «медленные», стал ничего не значить, а позже был удалён совсем. Аппаратная вложенность после этого равна единице, и одного стека прерываний на процессор достаточно. Вкладываться остаётся тому, что запретом не отключается, — NMI и машинной проверке, — и им отведены стеки IST.
Нижние половины исполняются там же. Архитектура, у которой не только обработчик, но и выход из прерывания идёт на стеке прерываний, обрабатывает отложенные softirq на том же стеке, экономя переключение; там, где это не так, есть отдельная функция запуска __do_softirq() на своём стеке. Из-под большой нагрузки softirq уезжают в поток ksoftirqd и исполняются уже на его стеке потока, а в конфигурации реального времени такой перенос сделан безусловным: собственный стек для softirq отключается при PREEMPT_RT, потому что там они исполняются в контексте задачи. Tasklet — исторический слой поверх softirq, и он объявлен устаревшим прямо в заголовке ядра, с рекомендацией использовать вместо него потоковые обработчики прерываний.
Отсюда прямой ответ на вопрос, почему в обработчике прерывания нельзя блокироваться. Документация ядра перечисляет состояния процессора, и первые два звучат так: «не связан ни с каким процессом, обслуживает аппаратное прерывание» и «не связан ни с каким процессом, обслуживает softirq или tasklet». Блокировка — это сохранение состояния текущего вычисления и передача процессора другому, но сохранять здесь нечего и некуда: стек общий на процессор, а поток, чей контекст был прерван, — не тот, кто ждёт. Иначе говоря, контекст прерывания в ядре модели процесса — это и есть модель прерывания, включённая на несколько микросекунд. Все её ограничения появляются вместе с ней, и по той же причине.
FreeBSD отвечает на тот же вопрос иначе, и сравнение поучительно. Там обработчик по умолчанию — это поток прерывания (ithread) со своим стеком ядра и своим контекстом планирования; ограничения такого обработчика мягче: «в процедуре ithread можно делать что угодно, кроме как засыпать», а блокировка на обычном мьютексе разрешена. Код, который обязан исполниться немедленно, оформляется отдельным фильтром, и он живёт в тех же условиях, что обработчик прерывания в Linux: «фильтр исполняется в первичном контексте прерывания. В этом контексте нельзя пользоваться обычными мьютексами». То есть FreeBSD по умолчанию возвращает обработчику модель процесса, а Linux по умолчанию оставляет ему модель прерывания и добавляет потоковые обработчики как опцию. Оба выбора рабочие, и различаются они тем, что дороже: переключение на поток или ограничения в коде драйвера. Для своей ОС по умолчанию стоит брать линуксовый ответ — короткий обработчик в контексте прерывания на стеке процессора плюс явный способ отложить остальное в поток. Довод не в производительности, а в порядке работ: обработчик-поток требует готового планировщика и стека на каждый источник прерываний ещё до того, как заработает первый драйвер, и платит переключением на каждое прерывание, тогда как обратное — увести конкретный обработчик в поток — добавляется по одному драйверу и тогда, когда выяснилось, что ему нужно спать. Обратный выбор оправдан ровно в одном случае, и он тот же, что при выборе модели ядра: если драйверы вы собираетесь заимствовать, а написаны они в расчёте на то, что обработчику можно заблокироваться, дешевле сразу дать им поток.
Пользовательский стек
Куда он растёт и кто это решил
«Стек растёт вниз» — соглашение только на двух из трёх архитектур цикла. На x86-64 направление задано железом: push, call и доставка исключения уменьшают RSP, и никакого выбора у операционной системы нет. На ARM64 и RISC-V специальных стековых инструкций нет вовсе — есть обычные загрузки и сохранения относительно указателя, — и направление целиком в соглашении о вызовах. AAPCS64 определяет стек как полный убывающий и добавляет ограничение, которое дальше окажется важным: «ни одному потоку не разрешено обращаться (для чтения или записи) к неактивной области» стека. Соглашение RISC-V говорит то же самое двумя фразами: «стек растёт вниз (в сторону меньших адресов)» и «процедуры не должны полагаться на сохранность размещённых на стеке данных, чьи адреса лежат ниже указателя стека».
Растущие вверх стеки — не гипотетика. PA-RISC устроен именно так, и Linux до сих пор носит для этого отдельную конфигурацию STACK_GROWSUP, включённую на этой архитектуре, вместе с обеими ветками кода расширения стека. Для своей ОС направление менять не за чем: выигрыша нет, а совместимость с чужими компиляторами теряется целиком.
Главный поток растёт, остальные — нет
Разница, которая регулярно удивляет, состоит в том, что «пользовательский стек» — это два разных механизма.
Стек главного потока создаёт ядро, помечает его как растущий вниз и расширяет по отказу страницы, пока хватает лимита RLIMIT_STACK. Значение по умолчанию — 8 МиБ, и оно записано в самом ядре константой с комментарием «8 МБ кажется разумным». Расти он может именно потому, что отказ обрабатывается на другом стеке — на стеке ядра.
Стеки остальных потоков создаёт библиотека потоков обычным mmap и не растит вовсе. Размер фиксируется в момент создания: под NPTL по умолчанию берётся мягкий лимит RLIMIT_STACK на момент старта программы, а если он снят — «специфичное для архитектуры значение: 2 МБ на большинстве архитектур; 4 МБ на POWER и Sparc-64». Снизу подкладывается сторожевая область, по умолчанию «того же размера, что системная страница», причём NPTL, вопреки требованию POSIX, включает её в заявленный размер стека, а не добавляет сверху. Переполнение такого стека даёт SIGSEGV и ничего больше — расти некуда по построению.
Из этой асимметрии следует практическое: программа, которая уверенно работала в главном потоке, может упасть, будучи перенесённой в рабочий поток, и виноват не код, а то, что 8 МиБ превратились в 2 МиБ без единой строчки изменений.
Сторожевой разрыв и Stack Clash
Одной сторожевой страницы под стеком оказалось мало, и это выяснилось громко. Атака Stack Clash, опубликованная Qualys в июне 2017 года, состоит в том, чтобы перепрыгнуть сторожевую страницу, не коснувшись её: функция, выделяющая на стеке больше страницы за раз, сдвигает указатель сразу за неё и пишет уже в соседнее отображение. Отказа не возникает, потому что обращения к самой странице не было.
Ответ ядра Linux — расширить сторожевую зону с одной страницы до разрыва, в который не разрешается класть другие отображения. Переменная называется stack_guard_gap, по умолчанию равна 256 страницам, то есть мегабайту при четырёхкилобайтной странице, и настраивается параметром загрузки, а не sysctl — распространённое заблуждение, которое стоит проверить перед тем, как писать в /proc/sys.
Ответ со стороны компилятора — зондирование стека. Флаг -fstack-clash-protection заставляет компилятор «выделять только одну страницу стекового пространства за раз, причём каждая страница читается сразу после выделения», и тем самым «не даёт выделениям перепрыгнуть через любую сторожевую страницу, предоставленную операционной системой». В GCC он входит в набор -fhardened, включаемый одним ключом. Оговорка из той же документации существенна: «большинство целевых платформ не поддерживают защиту от stack clash в полном объёме», и там защищаются только динамические выделения.
Третий кусок той же истории — альтернативный стек сигналов. Обработчик SIGSEGV, вызванный переполнением стека, не может исполняться на переполненном стеке, и sigaltstack — это ровно то же решение, что IST в ядре, только с пользовательской стороны: «единственный способ поймать этот сигнал — на альтернативном стеке сигналов». Одна деталь устарела у всех в памяти: SIGSTKSZ и MINSIGSTKSZ перестали быть константами — начиная с glibc 2.34 при определённом _GNU_SOURCE они разворачиваются в sysconf, потому что размер сохраняемого состояния зависит от процессора (у ARM SVE он переменный). Код, объявляющий массив размером SIGSTKSZ, с тех пор не собирается.
Красная зона: единственное место, где стек живёт ниже указателя
У соглашения о вызовах System V для AMD64 есть свойство, которое ломает всё сказанное выше про границу активной части стека: 128 байт ниже RSP неприкосновенны — их не трогает никто, включая обработчики сигналов и прерываний, — и листовая функция вправе разместить там весь свой кадр, не двигая RSP вообще.
Для стека ядра эта договорённость невыполнима, и причина ровно та же, что тянется через всю статью: на x86-64 процессор при исключении внутри ядра стек не переключает и укладывает кадр сразу под текущий RSP — то есть в красную зону прерванной функции. На ARM64 и RISC-V красной зоны нет вовсе: обе процитированные выше спецификации запрещают полагаться на данные ниже указателя стека, и запрещают именно затем, чтобы обработчик мог начать писать с текущей вершины. Откуда взялось само число, чем красная зона выгодна пользовательскому коду и как её отключение выражается во флагах сборки ядра — в статье про ядро как программу, там же цитата из документации GCC про атрибут interrupt.
Растущие стеки: сегментированные и копирующие
Отдельная ветка решений — растить стек не отказом страницы, а средствами языка. Она развивалась вне ядер, но знать её надо: ровно она отвечает, чего стоит отказ от фиксированного размера.
Сегментированный стек описан в GCC флагом -fsplit-stack: «генерировать код, автоматически разбивающий стек до того, как он переполнится. Полученная программа имеет разрывный стек, который может переполниться, только если программа вообще не может выделить память». Пролог каждой функции сверяет указатель с границей сегмента и при нехватке выделяет новый сегмент, связывая его с предыдущим. Так работал Go до версии 1.3.
Погубила схему патология, которую в Go называют горячим расщеплением: если граница сегмента приходится на вызов внутри тесного цикла, каждая итерация выделяет сегмент и тут же его освобождает. Замеры авторов из проектного документа наглядны: на тесте, специально подобранном под этот случай, сегментированные стеки дали 5,37 секунды против 1,26 у копирующих.
Копирующий стек, введённый в Go 1.3, работает иначе: при нехватке места выделяется новый непрерывный блок побольше, туда копируются все живые кадры, а указатели внутрь стека переписываются. Требование, которое это накладывает на язык, названо в том же документе прямо: «настраивать можно только настоящие указатели — нужно избегать целых чисел, похожих на указатели. Значит, нужна структура данных, которая для каждого машинного слова на стеке говорит, указатель это или нет». Иначе говоря, копирующие стеки требуют точных карт указателей — того же, что требует перемещающий сборщик мусора. Сегодняшний Go стартует горутину с 2048 байт и растит стек до гигабайта на 64-битных системах.
В ядре не применимо ни то ни другое, и причин три. Точных карт указателей в C нет: компилятор не обязан отличать указатель от целого, а консервативная догадка здесь не годится — переписать надо ровно настоящие указатели и ничего кроме. Хуже того, указатель на объект на стеке уходит в железо, в другой процессор и в структуру, переживающую кадр, так что переписать все его копии нельзя даже теоретически. Проверка в прологе обязана работать в контекстах, где выделять память нельзя, — в обработчике прерывания, в обработчике отказа, в NMI. И выделение на пути роста способно заблокироваться, а блокироваться там негде. Отсюда следует и вывод про язык: безопасный язык в ядре решает другие задачи, но задачу растущего стека не решает ни один из тех, что годятся для ядра, потому что решает её не язык, а точная карта указателей на стеке. Обычно такая карта появляется вместе со сборщиком мусора, но сборщик здесь достаточен, а не обязателен: обязательна именно карта. Разбор того, что даёт и чего стоит выбор языка, — в статье про ядро как программу.
Вердикт для своей ОС
Свести всё стоит по признаку «где выбор есть, а где его нет».
Выбора нет в двух местах. Стек ядра — фиксированного размера, потому что растить его по отказу страницы нельзя по кругу, а не по недосмотру. Событиям, приходящим в любой момент, нужен собственный, заранее подготовленный стек, иначе переполнение обычного стека нечем даже напечатать.
Выбор есть, и вот он, с рекомендациями.
| Решение | Рекомендация | Почему и что будет, если передумать |
|---|---|---|
| Модель ядра | процесса | Позволяет писать блокирующий код последовательно и заимствовать чужой; модель прерывания берут ради верификации, экстремальной экономии памяти или ограниченной сверху глубины стека. Смена модели — переписывание ядра |
| Размер стека потока | 16 КиБ | На этой цифре сошлись Linux и FreeBSD на всех трёх архитектурах; 4 КиБ хватает до появления слоёв друг над другом. Увеличить потом легко, уменьшить — нет |
| Сторожевая страница | сразу | Стоит одной записи таблицы на поток и превращает тихое повреждение в понятную панику |
| Выравнивание стеков | по удвоенному размеру | Даёт трёхинструкционную проверку переполнения на входе; приделывать потом придётся ко всем путям входа сразу |
| Стек прерываний | свой на процессор | Глубина перестаёт складываться со стеком потока; переключение стоит нескольких инструкций. Отдельная развилка — исполнять обработчик в потоке, как ithread во FreeBSD: драйверу тогда можно блокироваться, но платятся стек на источник и переключение на каждое прерывание |
| Вложенность прерываний | запретить | Обработчик с запрещёнными прерываниями ограничивает глубину единицей и снимает целый класс переполнений |
| Учёт глубины | с первого дня | -Wframe-larger-than, запрет VLA и рекурсии; ретроспективно чинить дороже, чем не допускать |
| Красная зона (x86-64) | -mno-red-zone |
Не оптимизация, а корректность: процессор пишет кадр исключения прямо туда |
Ещё три вещи полезно решить рано, хотя они и не про сам стек. Стек ядра для потока выделяйте целиком при его создании — ленивое выделение возвращает вас в тот же замкнутый круг. Не размещайте на стеке буферы для DMA — документация DMA API запрещает это прямым текстом: «нельзя использовать для DMA ни адреса образа ядра (объекты в сегментах data/text/bss), ни адреса образов модулей, ни адреса на стеке». Причин две, и вторая не зависит от того, отображён ли стек виртуально: с виртуально отображёнными стеками буфер физически не непрерывен, а без них он делит кэш-линию с соседними данными — «процессор может писать в одно слово, DMA в это время в другое слово той же кэш-линии, и одно из двух окажется затёрто» на процессорах с некогерентным к DMA кэшем. И заведите поле в структуре потока под указатель на его стек ядра до того, как напишете вход в ядро: и SP_EL1, и sscratch, и поле RSP0 в TSS — это три разных способа ответить на один вопрос «где стек текущего потока», и код входа получается симметричным, только если ответ у вас один.
Как это сделано в четырёх системах
| Linux | FreeBSD | seL4 | xv6-riscv | |
|---|---|---|---|---|
| Модель ядра | процесса | процесса | прерывания | процесса |
| Стек ядра на поток | 16 КиБ | 16 КиБ | нет; один на процессор | 4 КиБ |
| Сторожевая страница | при VMAP_STACK, по умолчанию да |
всегда | — | по странице с обеих сторон |
| Прерывания при исполнении в ядре | разрешены, кроме обработчиков | разрешены, кроме фильтров | запрещены всё время | разрешены на время системного вызова |
| Обработчик прерывания | на стеке прерываний процессора | в своём потоке, кроме фильтров | на том же единственном стеке | на стеке текущего процесса |
| Длинные операции | блокируются на месте | блокируются на месте | точки вытеснения с перезапуском | блокируются на месте |
Таблица читается по последней строке: она и есть та развилка, с которой статья начиналась. Три системы из четырёх позволяют операции заснуть посреди себя, и все три платят за это стеком на каждый поток. Четвёртая не платит и взамен обязана уметь начать любую длинную операцию заново.
Источники
- Intel 64 and IA-32 Architectures Software Developer's Manual, Volume 3A, глава 7 — переключение стека в режиме IA-32e и укладка
SS,RSP,RFLAGS,CS,RIPна новый стек (7.14.4); таблица стеков прерываний, семь указателей в TSS, трёхбитное поле IST в дескрипторе шлюза и мотивация «всегда исполняться на заведомо исправном стеке» (7.14.5); классы исключений, условия двойного отказа и переход в состояние остановки при отказе поверх доставки#DF(Event 8) - Arm Architecture Reference Manual for A-profile (DDI 0487M.c) — банкированные указатели стека по уровням исключения, выбор по
PSTATE.SPи суффиксыt/h(D1.2.2);SPSel(C5.2.19); проверка выравниванияSPпо 16 байтам (D1.4.10.2) - Procedure Call Standard for the Arm 64-bit Architecture (AAPCS64) — полный убывающий стек, запрет на обращение к неактивной области, выравнивание по 16 байт
- RISC-V Privileged Architecture, глава «Supervisor-Level ISA» — назначение
sscratchи обмен черезCSRRWв начале обработчика ловушки - RISC-V psABI: соглашение о вызовах — стек растёт вниз, выравнивание по 128 бит, запрет полагаться на данные ниже указателя стека
- System V AMD64 psABI,
low-level-sys-info.tex— красная зона: 128 байт ниже указателя стека, которые не изменяются обработчиками сигналов и прерываний - Kernel Stacks — документация ядра Linux —
THREAD_SIZEкак4*PAGE_SIZE, назначение стека прерываний, программный счётчик вложенности и фраза про то, что аппаратные стеки IST не могут вкладываться без гонок, «до семи входов IST на процессор», вложение разных векторов против оговорки о вложении одного и того же, перечень занятых входов IST - Virtually Mapped Kernel Stack Support — документация ядра Linux — требования к архитектуре, обработка переполнения на стеке двойного отказа на x86, запрет DMA с данными на стеке
- Dynamic DMA mapping Guide — документация ядра Linux — запрет DMA по адресам образа ядра, образов модулей и стека; требование выравнивания буферов по кэш-линии и порча данных при её разделении на процессорах с некогерентным к DMA кэшем
- Исходники ядра Linux:
arch/x86/include/asm/page_64_types.h—THREAD_SIZE_ORDER2,EXCEPTION_STACK_ORDER1 (то есть 8 КиБ, а не одна страница, как говорит документация),IRQ_STACK_ORDER2, удвоение под KASAN, индексы IST;arch/x86/kernel/traps.c— комментарий про#PF, превращающийся в#DF, иhandle_stack_overflow();arch/x86/entry/entry_64.S— разбор вложенного NMI;arch/x86/kernel/irq_64.c— стек прерываний, отображаемый черезvmapсо сторожевыми страницами;arch/x86/include/asm/switch_to.hиarch/x86/kernel/process_64.c—sp0, постоянно указывающий на входной стек процессора, и запись вершины стека текущего потока в переменную на процессор при переключении контекста;arch/x86/Makefile—-mno-red-zoneи-Cno-redzone=y;arch/arm64/include/asm/memory.h—MIN_THREAD_SHIFT14,THREAD_ALIGNкак удвоенный размер,OVERFLOW_STACK_SIZE4 КиБ;arch/arm64/kernel/entry.S— проверка переполнения вkernel_ventryи__bad_stack;arch/arm64/include/asm/current.h—currentвSP_EL0;arch/riscv/include/asm/thread_info.hиarch/riscv/Kconfig—CONFIG_THREAD_SIZE_ORDERсо значением 2 по умолчанию,IRQ_STACKS;arch/riscv/kernel/entry.S— обменsscratchи проверка переполнения;arch/Kconfig—VMAP_STACKсо значением по умолчанию «включено» и зависимостью, отключающей его при программных режимах KASAN безKASAN_VMALLOC,arch/x86/Kconfigна теге v4.9 иarch/arm64/Kconfigна теге v4.14 — выпуски, в которыхHAVE_ARCH_VMAP_STACKпоявляется у этих архитектур,HAVE_IRQ_EXIT_ON_IRQ_STACK,SOFTIRQ_ON_OWN_STACKи его отключение приPREEMPT_RT;scripts/Makefile.warn—-Wframe-larger-thanи-Wvla-larger-than=1с формулировкой запрета;lib/Kconfig.debug—FRAME_WARN2048 на 64 битах;mm/mmap.c—stack_guard_gapкак 256 страниц и разбор параметра загрузки;include/uapi/linux/resource.h—_STK_LIM8 МиБ;arch/parisc/Kconfig—STACK_GROWSUP;include/linux/interrupt.h— объявление tasklet устаревшим - Unreliable Guide To Hacking The Linux Kernel — документация ядра — перечень контекстов процессора и формулировка «не связан ни с каким процессом, обслуживает аппаратное прерывание»
- Expanding the kernel stack — LWN.net — переход с 8 на 16 КиБ в 3.15, довод про физическую непрерывность и цитата Торвальдса
- Virtually mapped kernel stacks — LWN.net — что ломается без сторожевой страницы, цена
vmallocдля создания потока и для TLB - Disabling IRQF_DISABLED — LWN.net — переход к обработчикам с запрещёнными прерываниями в 2.6.35 и довод про переполнение стека при вложенности
- Interface and Execution Models in the Fluke Kernel (Ford, Hibler, Lepreau et al., OSDI '99) — определения модели процесса и модели прерывания, одна кодовая база в обеих сборках, таблица расхода памяти на поток с оговоркой про производственную сборку и драйверы, задержки вытеснения по пяти конфигурациям и вывод, что цена связана с вытесняемостью, а не с моделью, смещение архитектуры x86, подходы к переносу чужого кода в модель прерывания и вывод «любая из моделей реализации разумна»
- Using Continuations to Implement Thread Management and Communication in Operating Systems (Draves, Bershad, Rashid, Dean, SOSP '91) — продолжения в Mach: 85 % экономии памяти на поток, ускорение RPC и обработки исключений
- The seL4 Microkernel — An Introduction (Heiser, seL4 Foundation) — исполнение с запрещёнными прерываниями и обоснование отказа от вытесняемости, инкрементальная согласованность, разбиение отзыва капабилити на подоперации с перезапуском
- An Evaluation of Coarse-Grained Locking for Multicore Microkernels (von Tessin et al.) — «seL4 является событийным, с единственным стеком ядра», двухфазная структура системного вызова, точки вытеснения
- The Stack Clash — Qualys Security Advisory — механика перепрыгивания сторожевой страницы и рекомендация увеличить разрыв минимум до мегабайта
- Instrumentation Options — GCC —
-fstack-clash-protection(по странице за раз с немедленным обращением, оговорка про неполную поддержку целевых платформ),-fsplit-stack, состав-fhardened - Developer Options — GCC — формат файлов
.suдля-fstack-usageи смысл квалификаторовstatic,dynamic,bounded - Contiguous stacks — проектный документ Go и Go 1.3 Release Notes — горячее расщепление, копирование кадров, требование знать про каждое слово стека, указатель это или нет, замеры против сегментированных стеков
src/runtime/stack.goиsrc/runtime/proc.go—stackMin2048 байт и предел стека в 1 ГБ на 64-битных системахsys/amd64/include/param.hиsys/vm/vm_glue.c—KSTACK_PAGES4,KSTACK_GUARD_PAGES1, выделение стека в виртуальном пространстве ядра со снятием отображения со сторожевой страницыbus_setup_intr(9)— FreeBSD — фильтр в первичном контексте прерывания против ithread со своим контекстом, ограничения каждогоpthread_create(3),pthread_attr_setguardsize(3)иsigaltstack(2)— размер стека потока изRLIMIT_STACKили 2 МБ, сторожевая область размером со страницу внутри заявленного размера, альтернативный стек как единственный способ поймать переполнение- Анонс glibc 2.34 —
SIGSTKSZиMINSIGSTKSZперестали быть константами и разворачиваются вsysconf - xv6-riscv:
kernel/memlayout.hиkernel/proc.c— стек ядра размером в страницу на процесс, окружённый недействительными страницами
Связанные заметки
- Страничная трансляция: таблицы, TLB, разрядность — вторая статья цикла: отказ страницы, права в записи таблицы и инвалидация, на которых держится вся механика сторожевых страниц
- Адресное пространство: зачем трансляция и какие есть альтернативы — первая статья цикла: почему разрежённое адресное пространство вообще возможно, а с ним и дешёвая сторожевая страница
- Карта памяти ядра: половины, прямое отображение, KASLR — третья статья цикла: где в карте ядра лежит область
vmalloc, из которой берутся виртуально отображённые стеки - Ядро как программа: freestanding, компоновка, ABI, выбор языка — восьмая статья цикла: флаги сборки вроде
-mno-red-zoneи вопрос о языке, который растущие стеки не решает - Устройство ОС — план цикла статей — состав и порядок цикла; вход в ядро и переключение контекста разбираются отдельной статьёй
- TLPI — база знаний — та же граница со стороны прикладного программиста: стек потока, сигналы и альтернативный стек сигналов
- Linux — мониторинг и отладка — как выглядят следствия на живой системе: трассы стека, oops и инструменты, которые их читают
- Вход в ядро и переключение контекста — седьмая статья цикла: переключение на стек ядра при входе — вопрос, отложенный отсюда
- Физическая память: от карты firmware до аллокатора — пятая статья цикла: аллокатор, у которого стек ядра просит непрерывный блок высокого порядка при создании каждого потока
- Загрузка: от питания до первой инструкции ядра — шестая статья цикла: стек, который обязан существовать до старта вторичного процессора, и первый стек ядра вообще
- Структура ядра: монолит, микроядро и что между — девятая статья цикла: почему модель прерывания практична для микроядра и мучительна для монолита
Из библиотеки института уносят только знания. Читателей здесь не считают: посещение не регистрируется, отметок в издании не остаётся, счётчиков нет ни у одного издания фонда.
Издание пополняется и пересверяется. Текст доступен на условиях CC BY-SA 4.0 — унесённое можно передавать дальше на тех же условиях.